14. Labo : Guitar Alchemist en 3D, quinze expériences mesurées
Sections
Réglages de lecture
Aucune voix pour cette langue dans ce navigateur.
Plus de voix
Code et termes techniques en anglais
Désactivé : la voix de la page lit tout, sans pause entre deux voix.
Aucune voix pour cette langue dans ce navigateur.
Plus de voix
D’autres voix : Microsoft Edge propose des voix naturelles en ligne, et Windows (Paramètres › Heure et langue › Voix), macOS et Android en installent d’autres.
Code : code/threejs/ga-lab : une page par expérience, le lanceur scripts/run.mjs, le code de mesure partagé src/lab.ts, les hypothèses enregistrées dans experiments/ et toutes les mesures dans results/.
Objectif
Section intitulée « Objectif »Les leçons 1 à 13 ont enseigné three.js et porté le manche de GuitarAlchemist. Cette leçon pose les questions que le code 3D de GA rencontrera ensuite, et y répond par la mesure plutôt que par des règles empiriques : comment dessiner de nombreux manches, comment animer les cordes, comment sélectionner une note parmi 10 000, comment montrer 313 047 voicings, ce que coûtent les textures, les ombres et le bloom, comment un moteur physique et un casque traitent une guitare à taille réelle, et ce qui se passe sur un GPU faible.
Chaque expérience suit le même protocole. Son fichier JSON dans experiments/ contient une question, une hypothèse et des prédictions chiffrées, écrites et commitées le 16 septembre 2026, avant l’exécution mesurée. L’exécution a écrit results/<experiment>/results.json le 17 septembre. Les verdicts ci-dessous comparent les deux, et les prédictions qui ont échoué restent dans les tableaux : elles sont l’essentiel de ce que ce labo a appris.
Comment les mesures ont été faites
Section intitulée « Comment les mesures ont été faites »Machine. Windows 11 Pro 10.0.26200, Intel Core Ultra 9 285K, 64 Go, un seul GPU activé, une NVIDIA GeForce RTX 5080 (pilote 610.88), Chromium 153.0.8010.12 de Playwright 1.63.0, Node.js 24.12, three.js r186. Chaque results.json répète ces informations.
Images. Une page n’utilise pas requestAnimationFrame : elle rend image après image dans une boucle, avec Chromium lancé avec --disable-gpu-vsync et --disable-frame-rate-limit, pour que l’écran ne lui impose jamais son rythme. Chaque page rend à une taille fixe, et WebGPU et WebGL 2 sont comparés à la même taille. Après 30 images de chauffe, 240 images sont chronométrées (moins quand c’est indiqué), et les tableaux donnent des médianes :
- CPU ms : la fonction d’image de la page, qui inclut l’enregistrement et la soumission des commandes par
renderer.render(); - GPU ms : les durées des passes de rendu et de calcul de l’image, issues des timestamp queries (la fonctionnalité
timestamp-queryde WebGPU, ouEXT_disjoint_timer_query_webgl2sur WebGL 2) ; - wall ms : le temps CPU plus l’attente jusqu’à ce que la file du GPU soit vide (
GPUQueue.onSubmittedWorkDone()sur WebGPU, unreadPixels()d’un pixel sur WebGL 2).
Sur WebGPU, le temps wall n’est jamais descendu sous 3.5 ms environ, quelle que soit la scène : c’est le délai de onSubmittedWorkDone() dans ce Chromium, pas du travail GPU. La colonne GPU est celle à lire pour le coût GPU, et le temps wall seulement quand il dépasse ce plancher.
Compteurs. renderer.info est remis à zéro à chaque image, pas à chaque render(), donc les compteurs d’une image additionnent toutes ses passes. WebGPURenderer compte sa passe de sortie (le tone mapping vers le canvas) comme un draw call : une scène d’un seul maillage en rapporte 2.
L’exécuter. Depuis code/threejs, après npm ci et npx playwright install chromium chromium-headless-shell :
node ga-lab/scripts/optick-project.ts # la projection OPTIC-K (--synthetic 20000 sans l'index de GA)node ga-lab/scripts/wood-texture.ts # le PNG de bois ; ga-lab/scripts/wood-ktx2.sh le compresse avec KTX-Softwarenode ga-lab/scripts/guitar-body.ts # le corps glTF et ses niveaux de détailnode ga-lab/scripts/run.mjs 01-neck # une expérience, ou toutesnode ga-lab/scripts/run.mjs 01-neck --run merged-16npx vite --config ga-lab/vite.config.ts # les pages, à http://localhost:5288/01-neck.html?strategy=merged&necks=16Les commandes sont les mêmes sous Windows (Git Bash), Linux et macOS ; wood-ktx2.sh a besoin de Bash et de l’outil ktx de KTX-Software 4.4.2. Les nombres mesurés appartiennent à cette machine : les vôtres différeront, les rapports moins.
CI. threejs-ga-lab.yml exécute ga-lab/check.sh sous Ubuntu, Windows et macOS : la vérification des types, les tests unitaires, les scripts de données, les courtes exécutions ci de chaque expérience sur WebGL 2, dont les compteurs renderer.info et les vérifications sont comparés à expected/, et le build. Elle ne compare aucun temps : les runners n’ont pas de GPU.
1. Le manche de quatre façons
Section intitulée « 1. Le manche de quatre façons »Hypothèse. Les draw calls déterminent le temps CPU d’une image ; le temps GPU bouge à peine, puisque chaque stratégie dessine à peu près les mêmes triangles.
Dispositif. 01-neck dessine le manche avec l’accord de do majeur, en 1200 × 400 pixels CSS à un pixel ratio de 1, de quatre façons : ga, la reproduction de la structure de GA de la leçon 13 (un maillage par frette, incrustation, corde, étiquette et marqueur) ; instanced, le portage de la leçon 13 (un InstancedMesh par sorte d’objet) ; batched, un seul BatchedMesh ; merged, toutes les parties statiques fusionnées en une géométrie avec des couleurs de sommets, et les marqueurs instanciés. Pour 16 manches, ga et instanced montent 16 copies.
| Stratégie | Draw calls, 1 manche | CPU ms, 1 manche | Draw calls, 16 manches | CPU ms, 16 manches | GPU ms, 16 manches |
|---|---|---|---|---|---|
| ga | 72 | 0.715 | 1 137 | 2.910 | 0.134 |
| instanced | 7 | 0.405 | 97 | 1.155 | 0.026 |
| batched | 44 | 0.385 | 689 | 0.415 | 0.023 |
| merged | 4 | 0.315 | 19 | 0.360 | 0.025 |
Pixel ratio de 3 de GA contre 1, un manche : 0.040 contre 0.017 GPU ms. Sur WebGL 2, le même manche ga a pris 0.590 CPU ms et 1.435 wall ms.
| Prédiction | Mesure | Verdict |
|---|---|---|
| Draw calls ga 72, instanced 7, batched et merged 4 ou moins | 72, 7, 44, 4 | batched fausse |
| CPU, ga au moins 3 fois merged ; tous sous 2 ms | 2.3 fois ; tous sous 1 ms | fausse, seconde partie juste |
| CPU, 16 manches : ga au moins 10 ms ; batched et merged sous 1.5 ms | 2.9 ms ; 0.42 et 0.36 ms | fausse, seconde partie juste |
| GPU, 16 manches : les quatre à 30 % près | ga 5 fois les autres | fausse |
| Pixel ratio 3 contre 1 : GPU au moins 4 fois | 2.4 fois | fausse |
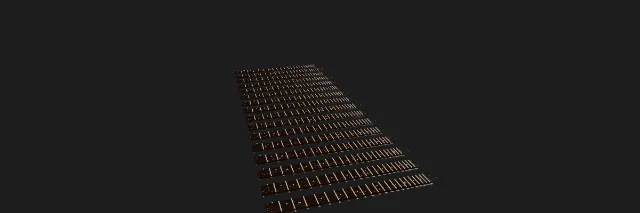
Ce que cela signifie pour GA. La RTX 5080 est trop rapide pour qu’un seul manche montre un coût : les 72 draw calls de GA prennent 0.7 ms de CPU. Ce qui croît, c’est le nombre d’objets : 16 manches dans la structure de GA prennent 8 fois le CPU des manches fusionnés, et 5 fois le temps GPU, puisque chaque draw call a aussi un coût fixe sur le GPU. BatchedMesh sur WebGPU a dessiné un appel par objet (44), là où WebGL 2 avec l’extension WEBGL_multi_draw en a dessiné 3 en CI : sur le backend WebGPU de r186, il économise du travail CPU, pas des draw calls. Et le portage de la leçon 13, instancié par manche, crée ses matériaux par manche : 97 draw calls et 73 programmes pour 16 manches, là où la fusion en garde 19 et 8. Un écran avec plusieurs manches devrait partager les matériaux entre les instances de Fretboard3D ou fusionner les parties statiques.
2. Une corde qui vibre de trois façons
Section intitulée « 2. Une corde qui vibre de trois façons »Hypothèse. Avec 6 cordes, les sommets CPU, TSL et les morph targets sont indiscernables ; avec 600, réécrire les sommets coûte du temps CPU et un envoi à chaque image, tandis que TSL et les morph targets ne coûtent presque rien sur le CPU.
Dispositif. 02-string-vibration dessine des cordes de 429 sommets à leur vrai tirant et les déplace latéralement avec une fondamentale amortie, la même formule dans les trois méthodes : réécriture de l’attribut de position (cpu), un positionNode TSL (tsl, le choix de la leçon 13), ou une morph target de la forme à pleine amplitude avec une influence par instance (morph). Chaque image est un instant fixe, pour que les images puissent être comparées.
| Méthode | CPU ms, 6 | CPU ms, 600 | GPU ms, 600 |
|---|---|---|---|
| cpu | 0.405 | 1.800 | 0.030 |
| tsl | 0.355 | 0.360 | 0.051 |
| morph | 0.375 | 0.465 | 0.035 |
| Prédiction | Mesure | Verdict |
|---|---|---|
| 6 cordes : les trois à 0.3 ms près | à 0.05 ms près | juste |
| 600 cordes : cpu au moins 5 fois tsl ; morph à moins de 2 fois tsl | 5.0 fois ; 1.3 fois | juste |
| 600 cordes : GPU à 30 % près | tsl 1.7 fois cpu | fausse |
| Pixels différents entre cpu et tsl, 6 cordes : moins de 0.5 % | 0 pixel (morph contre tsl : 0 ; 600 cordes : 0 et 1) | juste |
Ce que cela signifie pour GA. Les cordes TSL de la leçon 13 sont le bon choix pour le temps CPU, et elles coûtent un peu plus de temps GPU que des sommets déplacés, puisque le déplacement est calculé par sommet à chaque image au lieu d’être envoyé : toujours 0.05 ms pour 600 cordes. Les morph targets sur un InstancedMesh ont demandé deux corrections, rapportées plus bas : dans r186, leur cible doit être marquée morphTargetsRelative, sinon le maillage de base rétrécit avec l’influence, et un InstancedMesh d’une seule instance échoue sans morphTargetInfluences, tandis qu’un InstancedMesh de plusieurs instances échoue avec.
3. Sélectionner une note parmi 10 000
Section intitulée « 3. Sélectionner une note parmi 10 000 »Hypothèse. Raycaster teste chaque instance sur le CPU et croît avec le nombre de notes ; une passe d’identifiants GPU coûte une relecture qui, elle, ne croît pas. À 10 000 notes, la sélection GPU est plus rapide.
Dispositif. 03-picking dispose les notes en petits icosaèdres de 80 triangles dans un seul InstancedMesh, et sélectionne 200 points pseudo-aléatoires fixes deux fois : avec Raycaster.intersectObject, et en rendant une vue de 1 × 1 pixel (camera.setViewOffset) des instances colorées par instanceIndex + 1 dans un render target, relu avec readRenderTargetPixelsAsync.
| Notes | Raycaster, ms par sélection | Passe d’identifiants GPU, ms par sélection | Accord |
|---|---|---|---|
| 1 000 | 0.070 | 3.000 | 200/200 |
| 10 000 | 0.465 | 3.395 | 200/200 |
| 100 000 | 4.475 | 3.925 | 200/200 |
| 10 000, WebGL 2 | 0.495 | 16.925 | 200/200 |
| Prédiction | Mesure | Verdict |
|---|---|---|
| Raycaster, 10 000 notes : 3 à 8 ms | 0.465 ms | fausse |
| Passe d’identifiants GPU, 10 000 notes, WebGPU : 1 à 3 ms | 3.4 ms | fausse, de peu |
| Accord d’au moins 98 % | 100 % | juste |
| Raycaster, 1 000 notes : moins d’un quart de 10 000 | 15 % | juste |
Ce que cela signifie pour GA. Gardez Raycaster pour un manche : même 10 000 notes prennent une demi-milliseconde, sept fois moins que la relecture GPU, qui paie un aller-retour vers le GPU quel que soit le nombre. Les deux se rejoignent vers 100 000 notes. Sur WebGL 2, la relecture a pris 17 ms, une image : une passe d’identifiants y ferait attendre chaque clic une image.
4. Bracelets de classes de hauteurs, transposés sur le CPU ou en TSL
Section intitulée « 4. Bracelets de classes de hauteurs, transposés sur le CPU ou en TSL »Hypothèse. Transposer 4 096 bracelets sur le CPU paie 49 152 matrices et leur envoi à chaque image ; en TSL, on envoie un seul nombre.
Dispositif. 04-bracelet dessine chaque ensemble de classes de hauteurs comme un anneau de 12 perles, allumées pour ses membres, et fait tourner chaque anneau d’un pas de transposition qui change à chaque image : en écrivant les matrices de l’InstancedMesh (cpu), ou avec un uniform de pas dans un positionNode sur des attributs par perle (tsl). L’arithmétique des ensembles est dans pcs.ts, avec des tests unitaires.
| Bracelets | CPU ms, cpu | CPU ms, tsl | GPU ms, cpu | GPU ms, tsl |
|---|---|---|---|---|
| 352 | 0.495 | 0.335 | 0.103 | 0.102 |
| 4 096 | 2.455 | 0.290 | 1.012 | 1.024 |
| Prédiction | Mesure | Verdict |
|---|---|---|
| Chemin CPU, 4 096 : au moins 4 ms | 2.5 ms | fausse |
| Chemin TSL, 4 096 : moins de 0.5 ms | 0.3 ms | juste |
| GPU à 30 % près | à 1 % près | juste |
| Pixels différents entre les chemins : moins de 1 % | 0 pixel, pour 352 et pour 4 096 | juste |
| Classes par transposition, et avec inversion : 352 et 224 | 352 et 224 (test unitaire) | juste |
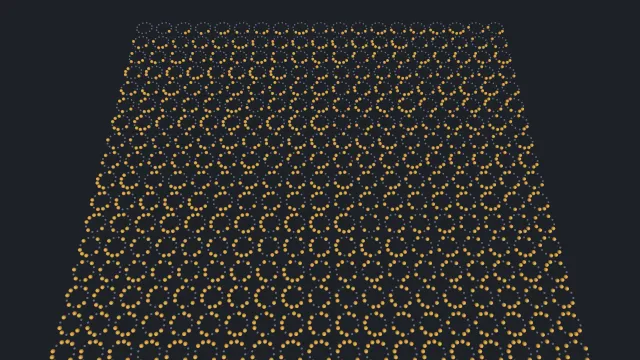
Ce que cela signifie pour GA. Une animation qui déplace chaque instance de la même façon a sa place dans le shader : 8 fois moins de CPU pour les 4 096 ensembles. Pour les 352 classes de transposition qu’une vue de GA montrerait, les deux chemins restent sous la demi-milliseconde.
5. Le nuage de voicings OPTIC-K, jusqu’à 1 000 000 de points
Section intitulée « 5. Le nuage de voicings OPTIC-K, jusqu’à 1 000 000 de points »Hypothèse. Des points d’un pixel restent bon marché jusqu’à 1 000 000 ; les octaèdres décrochent ; animer 1 000 000 de points sur le CPU est limité par la boucle et l’envoi, ce qu’un compute shader supprime.
Dispositif. scripts/optick-project.ts ouvre en lecture seule le vrai index OPTIC-K de GA, dans la disposition OPTK version 4 de OptickIndexReader.cs : 313 047 voicings (297 910 pour guitare, 7 795 pour basse, 7 342 pour ukulélé) de 124 dimensions, pas les 112 que supposait la question de l’expérience. Une analyse en composantes principales de 62 610 d’entre eux donne deux projections 3D, les composantes 1 à 3 (23.4 % de la variance) et 4 à 6 (14.5 %), en 1.3 s. 05-optick-cloud les dessine en 1280 × 720 sous forme de Points, d’octaèdres instanciés, et fond une projection dans l’autre à chaque image sur le CPU ou dans un compute shader. Au-delà de 313 047 points, elle répète les voicings avec un petit décalage.
| Exécution | CPU ms | GPU ms | Wall ms |
|---|---|---|---|
| Points, 1 000 | 0.330 | 0.013 | 3.595 |
| Points, 313 000 | 0.260 | 0.067 | 3.365 |
| Points, 1 000 000 | 0.300 | 0.173 | 3.565 |
| Octaèdres, 1 000 000 | 0.300 | 3.753 | 5.690 |
| Morph CPU, 1 000 000 | 4.055 | 0.170 | 9.430 |
| Morph compute, 1 000 000 | 0.335 | 0.511 | 3.580 |
| Morph compute, 1 000 000, WebGL 2 | 0.280 | 2.785 | 3.490 |
| Prédiction | Mesure | Verdict |
|---|---|---|
| Points, 1 000 000 : GPU sous 3 ms | 0.17 ms | juste |
| Octaèdres, 1 000 000 : au moins 5 fois Points | 22 fois | juste |
| Morph CPU, 1 000 000 : CPU d’au moins 8 ms | 4.1 ms (wall 9.4 ms) | fausse |
| Morph compute, 1 000 000 : CPU sous 1 ms | 0.34 ms | juste |
| Le compute ne tourne pas sur WebGL 2 | il tourne : 2 appels de compute, 2.8 GPU ms | fausse |
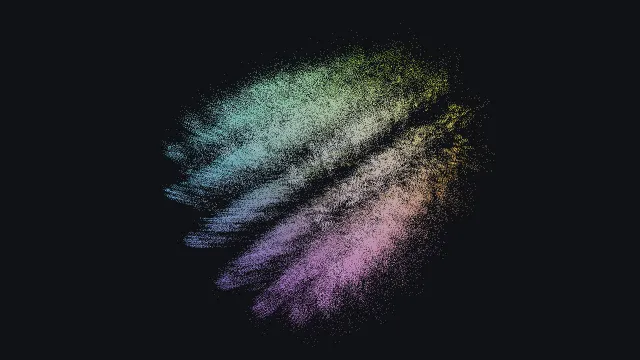
Ce que cela signifie pour GA. Tous les voicings de GA tiennent en un seul draw call de points à 0.07 GPU ms, et un morph de 1 000 000 de points dans un compute shader coûte une demi-milliseconde. r186 exécute aussi le compute TSL sur WebGL 2, par transform feedback, à 5 fois le temps GPU : une vue fondée sur le compute n’a pas à se replier sur le CPU sur les machines sans WebGPU. Les deux premières composantes principales portent moins d’un quart de la variance : la forme du nuage est une vue, pas une carte des distances, et une réponse de plus proches voisins doit venir de l’index, pas de l’image.
6. Le bois de la touche : textures, KTX2 et un bois procédural
Section intitulée « 6. Le bois de la touche : textures, KTX2 et un bois procédural »Hypothèse. Une texture RGBA8 de 2048 × 2048 avec mipmaps occupe environ 22 Mo ; compressée en KTX2 (BC7 sur ce GPU), un quart ; un bois procédural n’occupe rien mais coûte du bruit par pixel.
Dispositif. 06-wood-textures remplit une image de 1920 × 1080 avec la touche, vue d’en haut, texturée avec un PNG de bois de 2048 × 2048 issu de wood-texture.ts (1 217 318 octets), le même compressé par KTX-Software 4.4.2 en UASTC avec zstd (1 018 936 octets) et en Basis LZ (145 002 octets), un bois TSL fait de mx_noise_float, ou une couleur unie. Les bois ComfyUI (l’expérience 4 du labo GA ComfyUI) n’existaient pas lors de cette exécution : cette exécution est en attente. La mémoire des textures est renderer.info.memory.texturesSize moins les 23.73 Mo de l’exécution en couleur unie, qui sont les render targets.
| Exécution | Textures, Mo | GPU ms |
|---|---|---|
| PNG | 21.33 | 0.052 |
| KTX2 UASTC, transcodé en BC7 (format 36492), 12 niveaux de mip | 0 compté | 0.050 |
| KTX2 Basis LZ, transcodé en BC7 | 0 compté | 0.049 |
| TSL procédural | 0 | 0.116 |
| Couleur unie | 0 | 0.038 |
| ComfyUI | en attente | en attente |
| Prédiction | Mesure | Verdict |
|---|---|---|
| RGBA8 avec mipmaps : environ 22 Mo | 21.33 Mo | juste |
| KTX2 en BC7 : environ 5.6 Mo | non mesurable : renderer.info compte 0 octet pour les textures compressées |
non mesurée |
| Procédural : au moins 2 fois le temps GPU de la texture | 2.2 fois | juste |
| Textures ComfyUI en attente | en attente | juste |
Ce que cela signifie pour GA. Basis LZ livre le bois en 145 ko au lieu de 1.2 Mo, et devient du BC7 sur ce GPU, 1 octet par texel, environ 5.6 Mo avec mipmaps par le calcul (à vérifier avec un outil de mémoire GPU, puisque renderer.info ne le compte pas). Le bois procédural coûte 0.06 ms de plus par image 1080p et aucun téléchargement. Les deux sont moins chers que le PNG en mémoire.
7. Une grille PBR pour les cordes et les frettes
Section intitulée « 7. Une grille PBR pour les cordes et les frettes »Hypothèse. Des matériaux d’un même type avec des valeurs différentes partagent un seul programme ; MeshPhysicalMaterial ajoute des programmes et du travail d’ombrage.
Dispositif. 07-pbr-grid dessine 36 sphères en 1920 × 1080, la métallicité croissant de gauche à droite et la rugosité de haut en bas, sous un RoomEnvironment passé par PMREM : 36 MeshStandardMaterial, un seul partagé, ou 36 MeshPhysicalMaterial avec le clearcoat 0.35 et le sheen 0.3 de GA.
| Exécution | Programmes | Compilation, ms | GPU ms |
|---|---|---|---|
| 36 standard | 16 | 206 | 0.059 |
| 1 standard, partagé | 16 | 198 | 0.058 |
| 36 physical | 16 | 299 | 0.086 |
| Prédiction | Mesure | Verdict |
|---|---|---|
| 36 matériaux standard : autant de programmes qu’un seul | 16 et 16 | juste |
| Physical : au moins 1.3 fois le temps GPU de standard | 1.46 fois | juste |
| Les frettes se lisent comme du nickel poli à une métallicité de 1, une rugosité de 0.2 à 0.35 | jugé sur la capture d’écran, pas mesuré | non mesurée |
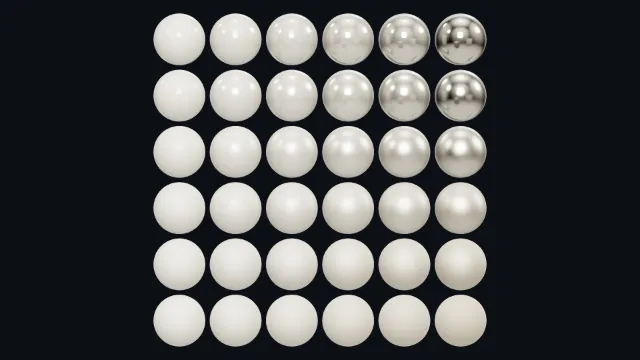
Ce que cela signifie pour GA. Des valeurs différentes de métallicité et de rugosité ne multiplient pas les programmes : ce sont des uniforms. Les programmes viennent du type et des fonctionnalités du matériau, donc le clearcoat et le sheen de GA coûtent du temps d’ombrage, pas de la compilation. Les 16 programmes d’une scène à un seul type de sphère sont ceux du renderer lui-même : passes d’environnement, de PMREM et de sortie.
8. Les ombres sous les cordes
Section intitulée « 8. Les ombres sous les cordes »Hypothèse. Une shadow map dynamique double les draw calls des objets qui projettent une ombre ; la rendre une seule fois ne coûte rien par image ; une texture précalculée coûte un précalcul sur le CPU ; une ombre de contact coûte une passe et un flou.
Dispositif. 08-shadows rend le manche en 1920 × 1080 avec la shadow map d’une lumière directionnelle (1024, 2048 et 4096 texels, mise à jour à chaque image ou une seule fois), une texture d’occlusion ambiante précalculée sur le CPU en lançant 16 rayons par texel d’une grille de 512 × 128, ou une ombre de contact : une vue orthographique, depuis le dessus, des parties situées au-dessus de la touche dans un render target de 512 × 128, floutée avec 25 échantillons en TSL.
| Exécution | Draw calls | GPU ms | Coût unique |
|---|---|---|---|
| Aucune | 8 | 0.046 | |
| Shadow map 1024 | 13 | 0.051 | |
| Shadow map 4096 | 13 | 0.051 | |
| Shadow map rendue une fois | 13, puis 8 | 0.046 | |
| AO précalculée | 8 | 0.046 | précalcul de 398 ms |
| Ombre de contact | 14 | 0.068 |
| Prédiction | Mesure | Verdict |
|---|---|---|
| Shadow map : environ 2 fois les draw calls | 13 contre 8, 1.6 fois | à peu près juste |
| 4096 contre 1024 : au plus 1.5 fois le temps GPU | 1.0 fois | juste |
| Rendue une fois : après la première image, les draw calls de la version sans ombre | 8 | juste |
| Précalcul : 100 à 500 ms | 398 ms | juste |
| Ombre de contact : moins de +0.5 ms GPU | +0.022 ms | juste |
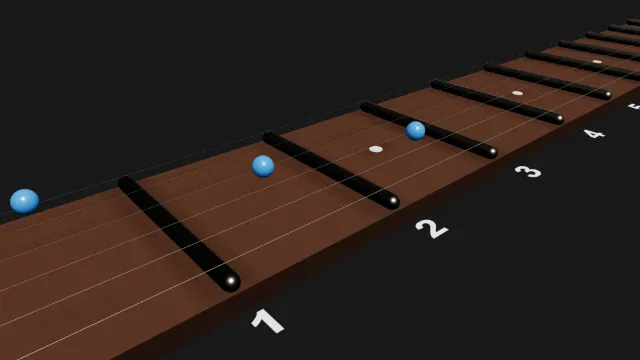
Ce que cela signifie pour GA. La shadow map d’un manche dessine peu de triangles, donc sa taille compte à peine sur ce GPU ; le choix porte sur la mémoire et la netteté. Un manche statique devrait rendre son ombre une seule fois (shadow.autoUpdate = false), et une texture précalculée supprime même cela, pour 0.4 s au chargement.
9. Du bloom sur les notes actives
Section intitulée « 9. Du bloom sur les notes actives »Hypothèse. Le bloom ajoute une chaîne fixe d’environ 10 à 12 passes dont le coût suit la résolution ; le bloom sélectif ajoute une sortie de couleur.
Dispositif. 09-bloom rend le manche en 1920 × 1080 avec une intensité émissive des marqueurs de 4, sans bloom, avec bloom() sur toute l’image en pleine et en demi-résolution, et sur une seule sortie MRT émissive (selective).
| Exécution | Draw calls | Render targets | GPU ms |
|---|---|---|---|
| Aucun | 7 | 1 | 0.034 |
| Complet | 19 | 12 | 0.169 |
| Demi-résolution | 19 | 12 | 0.106 |
| Sélectif (MRT) | 19 | 12 | 0.191 |
| Prédiction | Mesure | Verdict |
|---|---|---|
| Le bloom ajoute environ 10 à 12 draw calls | 12 | juste |
| Le bloom ajoute 0.5 à 1.5 GPU ms en 1080p | +0.135 ms | fausse |
| Sélectif à moins de +20 % du complet | +13 % | juste |
| Demi-résolution : au plus 0.6 fois le temps ajouté | 0.53 fois | juste |
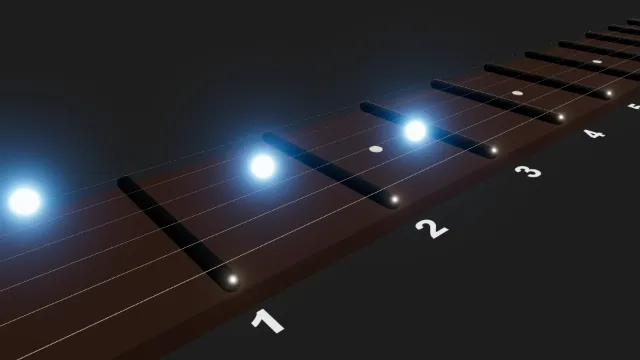
Ce que cela signifie pour GA. Le bloom sur les notes actives coûte 0.14 ms par image 1080p sur ce GPU, quatre fois moins que prévu, et le bloom sélectif par MRT coûte à peu près autant que le bloom sur tout, tout en laissant le bois et les frettes nets.
10. Un mur de guitares : LOD et culling
Section intitulée « 10. Un mur de guitares : LOD et culling »Hypothèse. La plupart de 1 000 corps sont loin ou hors de la vue : le LOD divise les triangles par 10, et désactiver le culling les dessine tous.
Dispositif. guitar-body.ts construit un corps de guitare de façon procédurale, l’extrude, et le simplifie avec meshoptimizer en un fichier glTF de trois niveaux : 14 360, 3 590 et 718 triangles. 10-lod-culling en accroche 1 000 sur un mur, déplace la caméra le long de celui-ci, et fait la moyenne des compteurs sur les 240 images du parcours.
| Exécution | Draw calls, moyenne du parcours | Triangles, moyenne du parcours | CPU ms | GPU ms |
|---|---|---|---|---|
| Détail complet, culling activé | 334 | 4 780 804 | 0.970 | 0.210 |
| LOD, culling activé | 334 | 428 091 | 2.365 | 0.068 |
| Détail complet, culling désactivé | 1 001 | 14 360 001 | 1.560 | 0.607 |
| LOD, culling désactivé | 1 001 | 1 326 075 | 3.450 | 0.139 |
| Prédiction | Mesure | Verdict |
|---|---|---|
| LOD : au plus 1/10 des triangles | 1/11.2 | juste |
| Culling désactivé : au moins 2 fois les draw calls | 3 fois | juste |
| LOD : au plus 1/3 du temps GPU | 0.32 | juste |
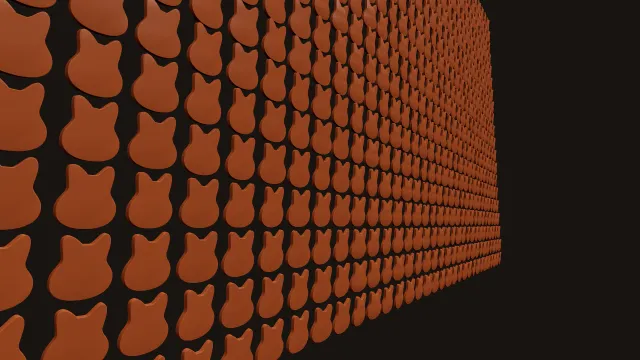
Ce que cela signifie pour GA. Le LOD rapporte sur le GPU et coûte sur le CPU : THREE.LOD mesure la distance de chaque corps à chaque image, 2.4 fois le temps CPU ici. Avec quelques guitares à l’écran, cela n’en vaut pas la peine ; pour une galerie de centaines, si.
11. Rapier : un médiator qui frappe une corde
Section intitulée « 11. Rapier : un médiator qui frappe une corde »Hypothèse. Sans détection de collision continue (CCD), un médiator qui avance de 33 mm par pas à 1/60 s traverse une corde de 0.5 mm ; la CCD l’empêche ; les articulations s’étirent moins quand le pas diminue.
Dispositif. e11-rapier-pick.ts exécute Rapier 0.20 (build déterministe) dans Node.js : une corde de 64 capsules de 10 mm reliées par des articulations sphériques entre le sillet et le chevalet, et un médiator cinématique qui la traverse à 2 m/s, à 30 à 960 pas par seconde, avec la CCD désactivée, sur le médiator, ou sur la corde.
| Pas par seconde | Déplacement du médiator par pas | Contact | La corde a bougé | Plus grand étirement | CPU ms par seconde simulée |
|---|---|---|---|---|---|
| 30 | 66.7 mm | non | non | 0 % | 9.5 |
| 60 | 33.3 mm | oui | non | 0 % | 14.0 |
| 120 | 16.7 mm | oui | oui | 33.6 % | 43.1 |
| 240 | 8.3 mm | oui | oui | 24.0 % | 65.3 |
| 480 | 4.2 mm | oui | oui | 12.9 % | 111.2 |
| 960 | 2.1 mm | oui | oui | 7.3 % | 204.0 |
Ce sont les exécutions avec la CCD désactivée ; avec la CCD sur le médiator ou sur la corde, les contacts étaient les mêmes à chaque fréquence, et l’étirement à quelques points près.
| Prédiction | Mesure | Verdict |
|---|---|---|
| CCD désactivée : traverse à 1/30 et 1/60 s, pas à 1/480 s | oui, oui (un événement de contact à 1/60, la corde ne bouge pas), non | juste |
| CCD activée : ne traverse jamais | traverse à 1/30 et 1/60 s | fausse |
| Étirement à 1/240 s : moins de 1 % | 24 % | fausse |
| À 1/30 s : plus de 5 % d’étirement ou NaN | aucun contact, rien ne bouge | fausse |
| Temps CPU proportionnel aux pas, à 30 % près | 0.21 à 0.36 ms par pas | à peu près juste |
Ce que cela signifie pour GA. La CCD de Rapier s’applique aux corps dynamiques ; un médiator cinématique déplacé en fixant sa prochaine position n’en profite pas, et une corde qu’il frappe non plus. Un médiator a besoin d’au moins 120 pas par seconde pour toucher une corde, et une chaîne d’articulations s’étire d’un quart à 240 : une corde jouable se modélise mieux par une équation de ressort (la formule de l’expérience 2), avec Rapier seulement pour détecter la frappe.
12. WebXR à l’échelle 1:1
Section intitulée « 12. WebXR à l’échelle 1:1 »Hypothèse. Cette machine n’a pas de casque ; sous l’émulation d’IWER, la distance du sillet à la 12e frette est de 0.324 m.
Dispositif. 12-webxr-scale met le manche à l’échelle en mètres (une unité vaut 10 mm), demande une session matérielle immersive-vr, puis en démarre une sur le Meta Quest 3 émulé d’IWER, comme l’a fait la leçon 11.
| Mesure | Valeur |
|---|---|
| Session matérielle | impossible à exécuter : isSessionSupported("immersive-vr") vaut false |
| Session émulée | en présentation, fonctionnalités local-floor, viewer, local |
| Vues par image XR | 2, à 63 mm l’une de l’autre |
| Du sillet à la 12e frette dans l’espace de référence | 0.324 m, diapason de 0.648 m |
| Position de la tête donnée, puis rapportée | (−0.1, 1.55, 0.45), puis (−0.1, 1.5751, 0.4751) |
| Prédiction | Mesure | Verdict |
|---|---|---|
| Matériel : impossible à exécuter | impossible à exécuter | juste |
| Du sillet à la 12e frette : 0.324 m à 1 mm près | 0.324 m | juste |
| 2 vues par image | 2 | juste |
Ce que cela signifie pour GA. Un manche à taille réelle est une question d’unités, et l’émulateur le confirme ; la sensation en main est à vérifier sur un casque. La tête émulée a été rapportée 25 mm plus haut et plus loin que la position donnée, un décalage de la pose d’IWER (à vérifier) qu’une étape de calibration devrait absorber.
13. WebAudio et la vibration de la corde
Section intitulée « 13. WebAudio et la vibration de la corde »Hypothèse. Une vibration lancée sur l’image du clic apparaît avant que le son ne sorte des haut-parleurs, de baseLatency plus outputLatency ; planifier à partir de getOutputTimestamp() ramène l’écart sous une image.
Dispositif. 13-audio-sync pince une corde 20 fois, avec un gain muet, avec la cadence d’images de Chromium activée (60 Hz), et mesure de combien la première image vibrante précède le moment où la note est audible, en la lançant tout de suite (naïf) ou au moment auquel AudioContext.getOutputTimestamp() fait correspondre la note (compensé). Elle a été exécutée en headless et avec fenêtre.
| Exécution | baseLatency | outputLatency | Image | Avance naïve | Avance compensée |
|---|---|---|---|---|---|
| Headless | 10 ms | 40 ms | 16.66 ms | 31.0 ms | −2.3 ms |
| Avec fenêtre | 10 ms | 40 ms | 16.66 ms | 31.8 ms | −1.5 ms |
| Prédiction | Mesure | Verdict |
|---|---|---|
| baseLatency + outputLatency, avec fenêtre : 20 à 60 ms | 50 ms | juste |
| Avance naïve : cette somme à une image près | 31.8 ms, 18 ms de moins | fausse, de peu |
| Avance compensée : moins de 17 ms | 1.5 ms | juste |
| Headless : outputLatency de 0 ou pas de périphérique | les mêmes 10 et 40 ms | fausse |
Ce que cela signifie pour GA. Sans compensation, la corde bouge environ 30 ms, deux images, avant que la note ne soit entendue : perceptible sur un grattage rapide. Retarder le début de l’animation jusqu’au timestamp de sortie supprime cet écart. Les latences sont celles que Chromium rapporte pour le périphérique par défaut, pas une mesure acoustique : un test au microphone est à vérifier.
14. React Three Fiber contre vanilla
Section intitulée « 14. React Three Fiber contre vanilla »Hypothèse. Le coût par image de R3F est faible à côté de renderer.render() ; son coût est au démarrage et dans le bundle.
Dispositif. 14-r3f-vs-vanilla charge soit le Fretboard3D de la leçon 13 dans un Canvas piloté par advance(), soit les mêmes objets instanciés construits sans React, chacun avec un import dynamique, depuis le serveur de développement de Vite. bundle-sizes.mjs construit chaque module seul pour la production.
| Mesure | R3F | Vanilla |
|---|---|---|
| CPU ms par image | 0.400 | 0.355 |
| Première image depuis la navigation (serveur de développement) | 958 ms | 528 ms |
| Tas JavaScript après les images | 36.96 Mo | 26.98 Mo |
| Draw calls, triangles | 7, 11 919 | 7, 11 919 |
| Bundle de production, gzip | 565 ko | 210 ko |
| Dont hors three.js | 195 ko | 2 ko |
| Prédiction | Mesure | Verdict |
|---|---|---|
| CPU par image : R3F à moins de +0.3 ms | +0.045 ms | juste |
| Première image : R3F +30 à 150 ms | +430 ms (serveur de développement) | fausse |
| Bundle hors three.js : R3F +50 à 90 ko gzip | +193 ko | fausse |
| Draw calls égaux | 7 et 7 | juste |
Ce que cela signifie pour GA. R3F ne coûte rien par image. Il coûte au chargement : 430 ms sur le serveur de développement (à vérifier sur un build de production) et 10 Mo de tas. Son bundle a aussi apporté three.js deux fois : R3F importe three, le build WebGL (three.module.js, 89 ko gzip), à côté de three/webgpu, et le build R3F pesait 565 ko contre 210. Un alias de three vers three/webgpu dans la configuration de Vite devrait supprimer le doublon (à vérifier).
15. Un GPU faible
Section intitulée « 15. Un GPU faible »Hypothèse. Le temps GPU suit le nombre de pixels, donc un pixel ratio de 3 coûte environ 9 fois celui de 1 sur un GPU faible ; powerPreference ne change rien sur une machine à un seul adaptateur ; un contrôleur adaptatif se stabilise en 60 images.
Dispositif. 15-weak-gpu dessine le manche instancié en 1200 × 400 pixels CSS, sur la RTX 5080 et dans chromium-headless-shell, qui n’a pas d’adaptateur WebGPU et se replie sur WebGL 2 avec SwiftShader, le rastériseur CPU de Chromium, qui tient lieu de GPU faible. Le contrôleur adaptatif démarre à un pixel ratio de 2 et, toutes les 10 images, le multiplie par 0.8 quand le temps wall médian dépasse 95 % de 16.7 ms, ou par 1.1 sous 60 %, entre 0.5 et 2.
| Pixel ratio | RTX 5080, GPU ms | SwiftShader, wall ms |
|---|---|---|
| 0.5 | 9.0 | |
| 1 | 0.014 | 26.7 |
| 2 | 95.4 | |
| 3 | 0.037 | 208.2 |
Contrôleur adaptatif sur SwiftShader, pixel ratio à chaque vérification : 2 (111.5 ms), 1.6 (74.6 ms), 1.28 (47.7 ms), 1.024 (31.2 ms), 0.819 (20.6 ms), 0.655 (14.5 ms), puis 0.655 jusqu’à l’image 120. Sur la RTX 5080, il est resté à 2, avec des médianes de 3.5 à 4.3 ms.
| Prédiction | Mesure | Verdict |
|---|---|---|
| SwiftShader, ratio 3 contre 1 : au moins 5 fois | 7.8 fois | juste |
low-power et high-performance : la même RTX 5080 |
la même, et Chromium avertit que l’option est ignorée sous Windows | juste |
| Contrôleur après 60 images : RTX 2 ; SwiftShader 1 ou moins | 2 ; 0.655 | juste |
Ce que cela signifie pour GA. Le pixel ratio de 3 de GA fait d’un manche 208 ms par image sur un rastériseur logiciel, et un contrôleur qui se stabilise à 0.655 le ramène à 60 images par seconde en 60 images. powerPreference ne peut pas choisir un GPU sous Windows : ce sont les paramètres graphiques du système d’exploitation qui le font (à vérifier sur un portable à deux GPU).
Ce que le labo a trouvé dans three.js r186
Section intitulée « Ce que le labo a trouvé dans three.js r186 »InstancedMeshavec des morph targets : avec une seule instance, le nœud de morph litmorphTargetInfluences, queInstancedMeshne crée pas, et échoue surnull; avec plusieurs, les définir échoue dansUniformArrayNode.updateBuffer. Une morph target de déplacements a aussi besoin degeometry.morphTargetsRelative = true.BatchedMeshdessine un appel par objet sur le backend WebGPU (44 pour un manche), et 3 sur WebGL 2 avecWEBGL_multi_draw.- Le compute TSL tourne sur le backend WebGL 2.
renderer.info.memory.texturesSizecompte 0 octet pour les textures compressées, et inclut les render targets.GPUQueue.onSubmittedWorkDone()ne se résout pas avant environ 3.5 ms dans Chromium 153 sous Windows, ce qui met un plancher sous tout temps wall mesuré avec.
À retenir
Section intitulée « À retenir »- Écrivez la prédiction avant l’exécution : 19 des 61 prédictions de ce labo étaient fausses en tout ou en partie, plusieurs d’un facteur, 2 n’ont pas pu être mesurées, et les fausses ont changé les conseils.
- Sur un GPU rapide, un manche ne coûte rien ; ce qui croît, ce sont le nombre d’objets, le pixel ratio et le temps de chargement.
- Gardez
Raycasterpour un manche, et TSL pour les animations qui déplacent chaque instance. - Tout l’index OPTIC-K de GA tient en un draw call de points ; un compute shader en anime un million, même sur WebGL 2.
- KTX2 Basis LZ divise le téléchargement du bois par 8 ;
renderer.infone peut pas vous dire sa mémoire GPU. - Un médiator cinématique traverse une corde quoi qu’en dise la CCD : détectez la frappe, simulez la corde avec une formule.
- Compensez la latence audio avec
getOutputTimestamp(), et plafonnez le pixel ratio avec un contrôleur, pas une constante.
Exercices
Section intitulée « Exercices »- Partagez les matériaux entre 16 manches
Fretboard3Det prédisez les draw calls et les programmes avant de mesurer avecrun.mjs 01-neck --run instanced-16. - Prouvez le plancher de la passe d’identifiants GPU : exécutez l’expérience 3 avec 1 000 000 de notes. Prédisez d’abord les deux temps de sélection.
- Ajoutez à
vite.config.tsun alias dethreeversthree/webgpupour le build R3F et relancezbundle-sizes.mjs. Combien devrait disparaître ? - Pourquoi le contrôleur adaptatif s’est-il stabilisé à 0.655 et pas à 0.8 ? Calculez, à partir du tableau à ratio fixe, le ratio auquel SwiftShader prendrait 15.9 ms.
- Expliquez pourquoi la CCD sur le médiator ne l’a pas arrêté à 60 pas par seconde, et modifiez
e11-rapier-pick.tspour qu’elle le fasse. - La prédiction de l’expérience 13 pour l’avance naïve s’est trompée de 18 ms. Que mesure l’avance naïve que la somme des latences ne mesure pas ?
Solution 1
Les 16 manches ont 97 draw calls et 73 programmes parce que chaque manche crée ses propres matériaux et sa propre texture d’étiquettes. Avec un seul jeu de matériaux et une seule texture pour tous les manches, le renderer ne peut pas fusionner les draw calls entre des InstancedMesh distincts : les draw calls restent à 6 par manche plus la passe de sortie, 97, tandis que les programmes devraient tomber aux 13 environ d’un seul manche, et les textures à 4. Pour dessiner moins d’appels, les manches devraient partager chaque InstancedMesh (un seul maillage instancié de frettes pour tous les manches), ce qui donne les 19 de la stratégie merged. Une prédiction, pas une exécution mesurée (à vérifier).
Solution 2
Raycaster a crû à peu près linéairement : 0.07, 0.465 et 4.475 ms pour 1 000, 10 000 et 100 000 notes, donc environ 45 ms pour 1 000 000. La passe d’identifiants est passée de 3.0 à 3.9 ms, tandis que son rendu passait de 0.04 à 1.3 GPU ms : à 1 000 000 de notes, le rendu d’un pixel dessine toujours chaque instance, environ 13 ms de GPU, donc environ 16 ms par sélection. La sélection GPU devrait gagner d’environ 3 fois. Exécutez node ga-lab/scripts/run.mjs 03-picking après avoir ajouté une exécution avec notes=1000000 ; les nombres ci-dessus sont extrapolés (à vérifier).
Solution 3
Dans ga-lab/vite.config.ts, resolve.alias avec { find: /^three$/, replacement: 'three/webgpu' } fait charger le build WebGPU par le import * as THREE from 'three' de R3F. three.module.js (89 ko gzip) devrait quitter le bundle, et le total de R3F descendre de 565 ko vers 476 ko. R3F 9 utilise des classes que les deux builds exportent, comme Vector3, Raycaster et Object3D, donc il devrait continuer à fonctionner (à vérifier : relancez l’expérience 14 et comparez les draw calls).
Solution 4
Le contrôleur multiplie par 0.8 au-dessus de 15.9 ms et par 1.1 sous 10 ms. À 0.819, il a mesuré 20.6 ms, au-dessus : 0.655. À 0.655, il a mesuré 14.5 ms, entre 10 et 15.9 : il reste. Le temps wall est à peu près proportionnel au nombre de pixels, le carré du ratio : 26.7 ms à 1 donne 15.9 ms à la racine carrée de 15.9 / 26.7, 0.77. Le contrôleur ne peut pas y arriver : depuis 0.819, son seul pas vers le bas est 0.655, et à 0.655 ses 14.5 ms sont au-dessus des 10 ms sous lesquels il remonterait. Des pas plus fins près du budget, ou un ratio calculé à partir du temps mesuré (le ratio courant multiplié par la racine carrée du budget divisé par le temps), se stabiliseraient plus près.
Solution 5
La CCD de Rapier balaie le mouvement d’un corps entre sa position et la suivante, donnée par sa vitesse. Un corps cinématique déplacé avec setNextKinematicTranslation a un mouvement, mais la CCD résout les pénétrations pour les corps dynamiques, en les repoussant le long du balayage ; elle n’arrête pas un corps cinématique, et un segment de corde dynamique de 10 mm n’est pas balayé contre un médiator qui saute 33 mm au-delà. Deux façons qui fonctionnent : subdiviser le mouvement du médiator (plusieurs appels à world.step() avec des déplacements plus courts par image rendue), ou lancer la forme du médiator le long de son mouvement avec world.castShape et appliquer une impulsion au segment qu’elle touche. Une conception, pas du code exécuté (à vérifier).
Solution 6
La somme des latences est le temps que met l’audio entre l’horloge du contexte et le haut-parleur. L’avance naïve se mesure entre des images : la vibration apparaît sur l’image qui suit le clic, et le temps de sortie de la note est échantillonné à 60 Hz, donc l’avance est la latence moins le temps jusqu’à la présentation de cette image, jusqu’à une image, et moins ce dont l’horloge audio avait déjà avancé dans son render quantum de 10 ms. 50 ms moins une image et un quantum, cela fait 23 à 33 ms : les 31.8 ms mesurés s’y trouvent. La prédiction aurait dû être « la somme moins jusqu’à une image et un render quantum ».
- three.js r186 :
WebGPURenderer,BatchedMesh,InstancedMesh,LOD,KTX2Loader, TSL - W3C : WebGPU (
timestamp-query,GPUQueue.onSubmittedWorkDone(),GPURequestAdapterOptions.powerPreference), Web Audio API (baseLatency,outputLatency,getOutputTimestamp()), WebXR Device API - Khronos : KTX 2.0, KTX-Software 4.4.2,
EXT_disjoint_timer_query_webgl2 - Chromium : ticket 369219127,
powerPreferenceignoré sous Windows - Rapier, détection de collision continue ; IWER ; meshoptimizer ; React Three Fiber
- GuitarAlchemist/ga à
66bdd04:OptickIndexReader.cs