8. Modèles récents et leurs licences, quantification et VRAM
Sections
Réglages de lecture
Aucune voix pour cette langue dans ce navigateur.
Plus de voix
Code et termes techniques en anglais
Désactivé : la voix de la page lit tout, sans pause entre deux voix.
Aucune voix pour cette langue dans ce navigateur.
Plus de voix
D’autres voix : Microsoft Edge propose des voix naturelles en ligne, et Windows (Paramètres › Heure et langue › Voix), macOS et Android en installent d’autres.
Code : les workflows 08-z-image-turbo.api.json et 08-flux2-klein.api.json ; le lecteur d’en-têtes dans csharp/Safetensors.cs.
SDXL est sorti en juillet 2023, et les modèles de 2025 et 2026 sont construits autrement. Leur réseau de débruitage est un transformer au lieu d’un UNet, entraîné par flow matching, qui apprend un chemin en ligne droite du bruit vers l’image. Un modèle de langage lit le prompt à la place de CLIP. Et ils sont plus gros. Cette leçon en exécute deux qui sont libres d’usage commercial, lit leurs licences et leurs fichiers, et les fait tenir dans 16 Go.
Deux modèles
Section intitulée « Deux modèles »| Z-Image-Turbo | FLUX.2 klein 4B | |
|---|---|---|
| Éditeur | Tongyi-MAI, chez Alibaba | Black Forest Labs |
| Réseau de débruitage | 6 milliards de paramètres, un « Scalable Single-Stream DiT » | 4 milliards de paramètres, un « rectified flow transformer » |
| Encodeur de texte | Qwen3 4B | Qwen3 4B, le même fichier |
| Étapes et CFG | 8 étapes, CFG 1 | 4 étapes, CFG 1, pour le modèle distillé |
| Licence | Apache 2.0 | Apache 2.0 |
| Fichiers pour ComfyUI | Comfy-Org/z_image_turbo | Comfy-Org/flux2-klein-4B |
Les deux sont distillés, comme les LoRA de la leçon 7. Z-Image-Turbo « matches or exceeds leading competitors with only 8 NFEs », égale ou dépasse ses principaux concurrents avec seulement 8 évaluations du réseau, et sa fiche dit qu’il « fits comfortably within 16G VRAM consumer devices », qu’il tient sans peine sur les cartes grand public de 16 Go de VRAM. La fiche de klein dit « Runs on consumer GPUs (~13GB VRAM) », qu’il tourne sur des GPU grand public avec environ 13 Go de VRAM. L’encodeur de texte Qwen3 4B est le même fichier de 8,0 Go dans les deux dépôts Comfy-Org, avec le même SHA-256.
Leurs graphes
Section intitulée « Leurs graphes »Les workflows copient le blueprint de ComfyUI Text to Image (Z-Image-Turbo), et la branche distillée du modèle de workflow qu’utilise le tutoriel FLUX.2 klein. Il n’y a pas de fichier checkpoint : chaque partie a son propre loader.
| Rôle | Z-Image-Turbo | FLUX.2 klein 4B |
|---|---|---|
| Réseau de débruitage | UNETLoader, puis ModelSamplingAuraFlow avec shift 3 |
UNETLoader |
| Encodeur de texte | CLIPLoader, type lumina2 |
CLIPLoader, type flux2 |
| Prompt négatif | ConditioningZeroOut du positif |
un CLIPTextEncode vide |
| Latent vide | EmptySD3LatentImage |
EmptyFlux2LatentImage |
| Échantillonnage | KSampler, 8 étapes, CFG 1, res_multistep, simple |
SamplerCustomAdvanced avec RandomNoise, CFGGuider à CFG 1, KSamplerSelect euler, et Flux2Scheduler avec 4 étapes |
| VAE | ae.safetensors, enregistré ici sous z_image_ae.safetensors |
flux2-vae.safetensors |
CLIPLoader charge ici un modèle de langage. Dans les noms de nœuds de ComfyUI, « CLIP » désigne désormais n’importe quel encodeur de texte, et type indique à ComfyUI comment l’utiliser. Avec un CFG de 1, le prompt négatif n’est jamais évalué (leçon 2), c’est pourquoi les deux graphes lui donnent un conditionnement vide ou mis à zéro. shift déplace le planning d’un modèle de flow vers l’extrémité bruitée : time_snr_shift transforme un temps t en 3t / (1 + 2t), donc le milieu du planning, t = 0,5, devient un niveau de bruit de 0,75.
Les licences
Section intitulée « Les licences »La licence d’un modèle est la licence d’une dépendance. Elle dit ce que tu as le droit de faire avec les poids, et parfois avec les images, et elle varie davantage que pour du code :
| Modèle | Licence | Ce qu’elle dit |
|---|---|---|
| SDXL base 1.0 | CreativeML Open RAIL++-M | usage ouvert, avec une liste d’usages interdits qui doit être transmise avec le modèle |
| Pixel Art XL, leçon 7 | CreativeML Open RAIL-M | la même idée, dans sa version plus ancienne |
| Stable Diffusion 3.5 Large | Stability AI Community License | « Free for research, non-commercial, and commercial use for organizations or individuals with less than $1M in total annual revenue. », gratuit pour la recherche, l’usage non commercial et l’usage commercial des organisations ou des personnes dont le chiffre d’affaires annuel total est inférieur à un million de dollars |
| FLUX.1 dev | FLUX.1 dev Non-Commercial License | les poids pour un usage non commercial, mais « Generated outputs can be used for personal, scientific, and commercial purposes », les images générées peuvent servir à des fins personnelles, scientifiques et commerciales |
| FLUX.1 schnell | Apache 2.0 | « can be used for personal, scientific, and commercial purposes », utilisable à des fins personnelles, scientifiques et commerciales |
| Qwen-Image | Apache 2.0 | « Qwen-Image is licensed under Apache 2.0. », Qwen-Image est sous licence Apache 2.0 |
| Z-Image-Turbo | Apache 2.0 | |
| FLUX.2 klein 4B | Apache 2.0 | « Open weights available for commercial use », des poids ouverts utilisables commercialement |
| FLUX.2 klein 9B | FLUX Non-Commercial License | d’après la fiche du 4B : « Filters or manual review must be used with the FLUX.2 [klein] 9B models under the terms of the FLUX Non-Commercial License », des filtres ou une relecture manuelle sont obligatoires avec les modèles 9B, selon les termes de cette licence non commerciale |
Ce tableau montre trois pièges. La licence peut changer au sein d’une même famille : klein 4B et klein 9B n’ont pas la même. Elle peut dépendre de qui tu es, comme avec le seuil de chiffre d’affaires de Stability AI. Et un fichier reconditionné, comme ceux de Comfy-Org, relève de la licence du modèle d’origine, que tu lis sur la fiche d’origine. Le cours a lu chaque fiche au moment de télécharger le fichier, et son rapport liste chaque fichier avec sa licence et son SHA-256. Ceci n’est pas un avis juridique : lis la licence elle-même avant de livrer quoi que ce soit.
Lire la licence avant de publier une sortie
Section intitulée « Lire la licence avant de publier une sortie »Une licence peut restreindre l’endroit où ses sorties peuvent être vues, et pas seulement ce que vous faites des poids. Ce cours l’a appris à ses dépens, avec les modèles image vers 3D ; le journal raconte l’épisode.
ComfyUI v0.36.0 exécute Hunyuan3D 2 avec les nœuds du cœur. Sa licence, la Tencent Hunyuan 3D 2.0 Community License, commence par :
THIS LICENSE AGREEMENT DOES NOT APPLY IN THE EUROPEAN UNION, UNITED KINGDOM AND SOUTH KOREA AND IS EXPRESSLY LIMITED TO THE TERRITORY, AS DEFINED BELOW.
(« Le présent contrat de licence ne s’applique pas dans l’Union européenne, au Royaume-Uni ni en Corée du Sud, et est expressément limité au Territoire, tel que défini ci-dessous. ») La clause 1.l définit le Territoire : « the worldwide territory, excluding the territory of the European Union, United Kingdom and South Korea. », le territoire mondial à l’exclusion de l’Union européenne, du Royaume-Uni et de la Corée du Sud. La clause 5.c va plus loin :
You must not use, reproduce, modify, distribute, or display the Tencent Hunyuan 3D 2.0 Works, Output or results of the Tencent Hunyuan 3D 2.0 Works outside the Territory. Any such use outside the Territory is unlicensed and unauthorized under this Agreement.
(« Vous ne devez pas utiliser, reproduire, modifier, distribuer ni afficher les Œuvres Tencent Hunyuan 3D 2.0, leurs Sorties ou leurs résultats en dehors du Territoire. Toute utilisation de ce type en dehors du Territoire n’est ni licenciée ni autorisée par le présent contrat. ») La licence de Hunyuan3D 2.1 contient les mêmes clauses. Trois conséquences pour un site public :
- Être soi-même dans le Territoire ne suffit pas. Générer un maillage depuis un pays du Territoire est permis. Le mettre sur un site web n’est pas un usage limité à ce pays : une page publique est affichée aussi dans l’Union européenne, au Royaume-Uni et en Corée du Sud.
- Un rendu est une sortie. « Output or results » couvre plus que le fichier
.glb: une image tournante du maillage, rendue dans Blender, affiche encore le résultat. - Une licence est un fichier daté. Lisez-la à une révision épinglée et gardez son empreinte. Le cours lit la licence de Hunyuan3D 2.0 au commit
9cd649ba, SHA-256eca02cc10abaf520…. Certaines licences changent d’elles-mêmes : celle de DINOv3, datée du 19 août 2025, dit à sa clause 8 que « Your continued use of the DINO Materials after any modification to this Agreement constitutes your agreement to such modification. », que continuer à utiliser les DINO Materials après une modification vaut acceptation de cette modification.
Le cours a comparé trois façons d’obtenir le modèle 3D d’un petit objet pour ses pages :
| Hunyuan3D 2.0 ou 2.1, dans ComfyUI | TRELLIS.2 4B, dans ComfyUI | Modélisation procédurale avec bpy dans Blender |
|
|---|---|---|---|
| Licence | Tencent Hunyuan 3D Community License : pas dans l’UE, au Royaume-Uni ni en Corée du Sud, sorties non affichées dans ces territoires, demande à Tencent au-delà d’un million d’utilisateurs actifs mensuels | MIT, mais son encodeur d’image est DINOv3, sous la DINOv3 License : citer DINOv3 dans une publication (1.b.ii), fournir une copie de la licence avec les poids (1.b.i), accepter les modifications à venir en continuant de les utiliser (8) | Blender est sous GPL, et sa page de licence dit « What you create with Blender is your sole property. » : ce que vous créez avec Blender vous appartient |
| RAM et VRAM libres sur cette machine | 19 Go de RAM libre pour la 2.0 avec SDXL ; 9,4 Go de VRAM mesurés pendant l’échantillonnage | environ 23 Go de RAM libre pour le modèle int8 avec SDXL ; le README amont demande « at least 24GB » de VRAM, et 16 Go reste à vérifier | aucun GPU nécessaire |
| Qualité observée | 890 140 et 1 017 760 triangles pour deux objets simples, 19 084 et 189 748 arêtes non manifold, ni UV ni texture, un arrière inventé, du détail peint lu comme du relief, et la ligne de sol de l’image devenue une dalle | non testé | 3 370 triangles pour le métronome et 5 950 pour le gramophone, aucune arête non manifold à la relecture du glTF exporté, pièces nommées, matériaux séparés et animations, pour environ 510 lignes de modélisation et 120 de plus qui les vérifient à chaque commit ; le détail s’arrête où s’arrête le code |
| Publiable sur ce site | non | oui, avec DINOv3 cité | oui |
Le paquet TRELLIS.2 de Comfy-Org est étiqueté MIT et distribue clip_vision/dino_v3_vit_l.safetensors sans copie de la DINOv3 License. La licence du fichier s’applique quand même : un reconditionnement ne la change pas. Ceci n’est pas un avis juridique.
Ce que contient un fichier quantifié
Section intitulée « Ce que contient un fichier quantifié »Les 6 milliards de paramètres de Z-Image-Turbo occupent 12,3 Go en bf16, 2 octets chacun, et l’encodeur de texte Qwen3 prend 8,0 Go de plus : 20,3 Go, pour une carte de 16 Go. Comfy-Org publie les deux dans des formats plus petits. L’outil du cours lit leurs en-têtes :
> comfy safetensors-info z_image_turbo_bf16.safetensorsz_image_turbo_bf16.safetensors: header 48920 bytes, 453 tensors, 12.31 GB of tensor data  BF16       453 tensors,  12.31 GB
> comfy safetensors-info z_image_turbo_int8_convrot.safetensorsz_image_turbo_int8_convrot.safetensors: header 91000 bytes, 857 tensors, 6.20 GB of tensor data  I8         202 tensors,   6.14 GB  F32        453 tensors,   58.9 MB  U8         202 tensors, 14544 bytesquantized layers (.comfy_quant): 202  202 x {"format": "int8_tensorwise", "convrot": true, "convrot_groupsize": 256}
> comfy safetensors-info z_image_turbo_nvfp4.safetensorsz_image_turbo_nvfp4.safetensors: header 113080 bytes, 993 tensors, 4.51 GB of tensor data U8 180 tensors, 2.71 GB BF16 273 tensors, 1.46 GB F8_E4M3 180 tensors, 0.34 GB F32 360 tensors, 1440 bytesquantized layers (_quantization_metadata): 180 nvfp4- int8 : 202 couches stockent un octet signé par poids, plus une échelle
F32par couche : poids ≈ échelle × octet. Chacune de ces couches a aussi un minuscule tenseurU8nommécomfy_quant, qui contient son format en JSON. L’indicateurconvrotet sa taille de groupe de 256 sélectionnent une variante dont les noyaux,quantize_int8_convrot_weightetdequantize_int8_convrot_weight, sont dans comfy-kitchen, la bibliothèque de quantification de ComfyUI. Le noyau a depuis été lu, dans comfy-kitchen 0.2.34. La rotation est une matrice de Hadamard régulière : les puissances de Kronecker d’un bloc 4 × 4 symétrique, divisées par la racine carrée de sa taille — d’où l’obligation que la taille de groupe soit une puissance de 4 (tensor/int8_utils.py). Chaque groupe de 256 canaux d’entrée est tourné par elle : le poids une fois, hors ligne, enW @ H.T, et les activations à chaque appel, enx @ H, fusionné dans le quantificateur par ligne (backends/cuda/__init__.py). Cette matrice est symétrique et orthogonale, donc elle est sa propre inverse : les deux rotations s’annulent et la couche calcule le même produit. Ce qui change, c’est ce que l’int8 doit contenir.data/convrot.pyreconstruit la même matrice — identique à celle de comfy-kitchen pour les tailles de groupe 16, 64 et 256 — et quantifie un poids dont chaque ligne a un canal quarante fois plus grand que les autres : l’erreur d’aller-retour par ligne vaut 5,7 % sans la rotation et 0,76 % avec, sept fois et demie moins. La rotation mélange la valeur aberrante à tout son groupe, de sorte que l’unique échelle de la ligne n’a plus à la couvrir seule. - nvfp4 : 180 couches stockent 4 bits par poids, deux par octet, en
U8. Le format NVFP4 de NVIDIA a « 1 sign bit, 2 exponent bits, and 1 mantissa bit », un bit de signe, deux bits d’exposant et un bit de mantisse : 16 valeurs possibles. Chaque bloc de 16 poids a sa propre échelle de 8 bits enF8_E4M3, c’est pourquoi 2,71 Go de poids s’accompagnent de 0,34 Go d’échelles, et chaque couche a deux scalairesF32. Le format n’est pas stocké ici dans des tenseurs par couche, mais dans l’entrée_quantization_metadatade l’en-tête. - Les tenseurs
BF16du fichier nvfp4 ne sont pas seulement de petits poids de normalisation. La lecture de leurs noms montre que les 30 blocs principaux sont quantifiés, mais que les quatre blocs refiner, qui traitent d’abord l’image et le texte, restent entiers en bf16, soit 1,43 Go des 1,46 Go.
Les fichiers plus petits de l’encodeur de texte mélangent les formats, ce que leurs noms ne disent qu’à moitié :
> comfy safetensors-info qwen_3_4b_fp8_mixed.safetensorsqwen_3_4b_fp8_mixed.safetensors: header 87608 bytes, 788 tensors, 5.63 GB of tensor data  BF16       209 tensors,   3.27 GB  F8_E4M3    189 tensors,   2.33 GB  U8         201 tensors,   31.5 MB  F32        189 tensors, 756 bytesquantized layers (.comfy_quant): 189  177 x {"format": "float8_e4m3fn"}  12 x {"format": "nvfp4"}
> comfy safetensors-info qwen_3_4b_fp4_mixed.safetensorsqwen_3_4b_fp4_mixed.safetensors: header 121208 bytes, 1081 tensors, 3.48 GB of tensor data  F8_E4M3    247 tensors,   1.24 GB  U8         436 tensors,   1.21 GB  BF16       151 tensors,   1.03 GB  F32        247 tensors, 988 bytesquantized layers (.comfy_quant): 247  189 x {"format": "nvfp4"}  58 x {"format": "float8_e4m3fn"}
Le fichier « fp8 » a 12 couches nvfp4, et le fichier « fp4 » garde 58 couches en fp8. float8_e4m3fn représente un octet par poids avec 4 bits d’exposant et 3 bits de mantisse, et une échelle par couche. Sur un GPU sans noyaux fp4, le fichier « fp8 » n’est donc pas entièrement natif non plus.
Trois façons d’écrire les mêmes nombres passent par un seul loader. convert_old_quants transforme l’entrée de l’en-tête en tenseurs comfy_quant au chargement du fichier, et pick_operations donne ensuite au modèle les couches à précision mixte de ComfyUI.
Natif ou émulé
Section intitulée « Natif ou émulé »Un format n’est rapide que sur un GPU qui a des noyaux pour lui. get_disabled_quant_formats interroge model_management.py sur le périphérique :
| Format | Natif sur | Ailleurs |
|---|---|---|
float8_e4m3fn, float8_e5m2 |
NVIDIA avec une capacité de calcul de 8.9 ou plus : série RTX 40 et suivantes | émulé |
nvfp4 |
NVIDIA avec une capacité de calcul de 10 ou plus : série RTX 50 | émulé |
int8_tensorwise |
tout périphérique sauf MPS d’Apple, Intel XPU et DirectML | émulé |
Émulé ne veut pas dire refusé. La couche est marquée _full_precision_mm, et à chaque passe avant son poids est déquantifié vers le type de calcul, puis multiplié comme d’habitude :
if self._full_precision_mm and isinstance(weight, QuantizedTensor): weight = weight.dequantize()return self._forward(input, weight, bias)Le fichier reste petit, sur le disque et en mémoire, et le calcul coûte plus cher qu’en bf16. Le serveur écrit son choix dans le log quand un modèle se charge. Sur la RTX 5080 de l’auteur, de capacité de calcul 12.0, avec PyTorch compilé pour CUDA 13.0, tous les formats étaient natifs :
Using mixed precision operationsNative ops: asym_w4a8_int8, float8_e5m2, convrot_w4a4, float8_e4m3fn, mxfp8, nvfp4, int8_tensorwiseÀ vérifier : le chemin émulé sur un GPU plus ancien ; la machine du cours n’en a pas.
Tenir dans 16 Go
Section intitulée « Tenir dans 16 Go »La VRAM dynamique
Section intitulée « La VRAM dynamique »Les poids de Z-Image-Turbo en bf16 et de son encodeur de texte ne tiennent pas dans 16 Go, et le workflow s’est quand même exécuté. Dans la v0.36.0 sur NVIDIA, ComfyUI gère la mémoire avec la VRAM dynamique, activée par défaut : main.py remplace le patcher de modèle par ModelPatcherDynamic quand PyTorch est en version 2.8 ou ultérieure. Chaque modèle est préparé : ses poids restent en mémoire système, et passent sur le GPU à mesure que le calcul en a besoin, dans la limite de la mémoire libre. Le log donne la taille préparée de chaque modèle :
Model ZImageTEModel_ prepared for dynamic VRAM loading. 7671MB Staged. 0 patches attached. Force pre-loaded 145 weights: 383 KB.Model Lumina2 prepared for dynamic VRAM loading. 11738MB Staged. 0 patches attached. Force pre-loaded 205 weights: 1045 KB.Cela change ce que t’apprend nvidia-smi. Le pic de mémoire du GPU était entre 12,5 et 15,3 Go pour chaque configuration ci-dessous, avec 2,4 à 2,8 Go déjà utilisés par d’autres programmes : ComfyUI remplit ce qui est libre, quelle que soit la taille du modèle. Ce sont les tailles préparées et la vitesse qui montrent la différence.
Les mesures
Section intitulée « Les mesures »Un serveur par configuration, trois rendus chacun : la graine 42 sur un serveur neuf, puis les graines 43 et 44 avec les modèles chargés. Le prompt est celui de la leçon 1, en 1024 pixels sur 1024. Les temps sont les lignes « Prompt executed » du serveur, et la vitesse est le nombre d’étapes par seconde du sampler sur les rendus à chaud.
| Réseau de débruitage | Encodeur de texte | Taille préparée, réseau + encodeur | Premier rendu | Rendus à chaud | Étapes par seconde |
|---|---|---|---|---|---|
| Z-Image-Turbo bf16 | Qwen3 bf16 | 11 738 + 7 671 Mo | 63,93 s | 8,72 s, 5,93 s | 1,5 |
| Z-Image-Turbo int8 convrot | Qwen3 fp8 mixed | 5 888 + 5 370 Mo | 37,42 s | 3,03 s, 3,05 s | 3,1 |
| Z-Image-Turbo nvfp4 | Qwen3 fp4 mixed | 4 299 + 3 317 Mo | 28,06 s | 2,68 s, 2,79 s | 3,7 |
| Z-Image-Turbo nvfp4 | Qwen3 bf16 | 4 299 + 7 671 Mo | 32,32 s | 2,41 s, 2,50 s | 4,1 |
| FLUX.2 klein 4B bf16, 4 étapes | Qwen3 bf16 | 7 392 + 7 671 Mo | 32,26 s | 2,00 s, 2,39 s | 3,5 |
Le premier rendu comprend la lecture des fichiers sur un SSD externe, et c’est surtout du chargement. Les rendus à chaud montrent les formats. Le bf16 a tourné à la moitié de la vitesse de l’int8 : 11,7 Go de réseau, plus la mémoire de travail d’une image de 1024 sur 1024, ne tenaient pas à côté des autres programmes, donc une partie des poids passait sur le GPU à chaque étape. L’int8 et le nvfp4 tenaient, et les noyaux nvfp4 ont été les plus rapides. Le réseau nvfp4 a aussi tourné plus vite avec l’encodeur de texte bf16 qu’avec le fp4, 4,1 étapes par seconde contre 3,7. À vérifier : le cours n’a pas d’explication, puisque l’encodeur de texte ne sert pas pendant l’échantillonnage.
Un mode qui charge les modèles en entier n’a pas pu être mesuré sur cette machine. Avec --disable-dynamic-vram, ComfyUI estime la mémoire dont il a besoin et charge chaque modèle entièrement. Le premier rendu a pris 78,87 secondes, et ses pixels étaient identiques à ceux du rendu en VRAM dynamique avec la même graine. Pendant le deuxième rendu, la machine, avec 64 Go de RAM partagés avec d’autres travaux, a manqué de mémoire, et l’exécution a été arrêtée. C’est un résultat en soi : la VRAM dynamique est ce qui permet à un modèle de 20 Go de tourner à côté d’autres programmes.
Ce que la quantification a changé
Section intitulée « Ce que la quantification a changé »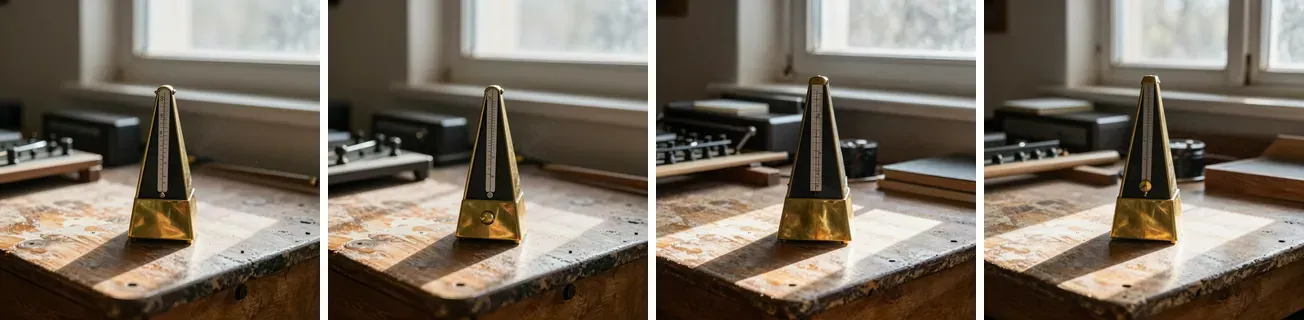
Rendu par ComfyUI v0.36.0 : Z-Image-Turbo, graine 42, 8 étapes, CFG 1, res_multistep, simple, shift 3, prompt « a brass metronome on an old wooden workbench, morning light through a window, dust in the air, photograph », workflow 08-z-image-turbo.api.json. De gauche à droite : réseau bf16 avec l’encodeur de texte bf16 ; int8 convrot avec fp8 mixed ; nvfp4 avec fp4 mixed ; nvfp4 avec bf16.
Comparés au rendu bf16 de la même graine, pixel par pixel :
| Configuration | Graine 42 | Graine 43 | Graine 44 |
|---|---|---|---|
| int8 + fp8 mixed | moyenne 3,96, 13,13 % des pixels de plus de 8 | moyenne 3,27, 9,49 % | moyenne 4,78, 15,33 % |
| nvfp4 + fp4 mixed | moyenne 23,80, 71,98 % | moyenne 24,31, 66,18 % | moyenne 30,50, 74,48 % |
| nvfp4 + bf16 | moyenne 27,10, 71,35 % | moyenne 28,74, 72,73 % | moyenne 18,54, 62,58 % |
L’int8 a donné la même image, avec de petites différences de texture. Le nvfp4 a donné une autre image de la même scène : les objets ont bougé, et environ trois quarts des pixels ont changé. La précision de l’encodeur de texte a compté aussi : le nvfp4 avec l’encodeur fp4 et avec l’encodeur bf16 différaient en moyenne de 20 à 23 niveaux. Aucune de ces images n’est fausse, et différent ne veut pas dire moins bon. Un modèle quantifié est un autre modèle, proche de l’original, et une graine choisie avec l’un ne se transpose pas à l’autre.
FLUX.2 klein
Section intitulée « FLUX.2 klein »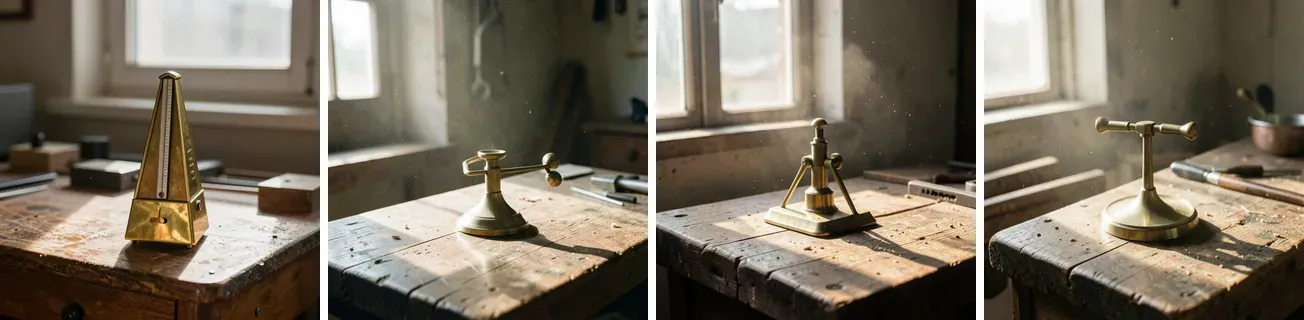
Rendu par ComfyUI v0.36.0. D’abord : Z-Image-Turbo bf16, graine 43, réglages comme ci-dessus. Ensuite : FLUX.2 klein 4B distillé, bf16, avec l’encodeur de texte Qwen3 4B, graines 42, 43 et 44, 4 étapes, CFG 1, euler, Flux2Scheduler, même prompt, workflow 08-flux2-klein.api.json.
Avec le même prompt, Z-Image-Turbo a dessiné un métronome avec chaque graine, et klein 4B a dessiné trois fois un support en laiton, dans une scène qui correspond bien au reste du prompt. Le SDXL de la leçon 1 a dessiné quelque chose comme un sablier. Reconnaître un objet à partir de son nom est ce qui a le plus distingué les modèles sur ce prompt, mais trois graines ne font pas un benchmark.
GGUF et --lowvram
Section intitulée « GGUF et --lowvram »Les guides écrits pour les anciennes versions de ComfyUI recommandent souvent les fichiers GGUF, le format de llama.cpp, et l’option --lowvram. Dans la v0.36.0, ni l’un ni l’autre n’est le chemin par défaut. Le cœur de ComfyUI n’a pas de loader GGUF : ComfyUI-GGUF est un nœud personnalisé, et son README dit « Simply use the GGUF Unet loader found under the bootleg category. », c’est-à-dire d’utiliser le loader GGUF Unet de la catégorie bootleg. L’avertissement de démarrage de ComfyUI lui-même, affiché avec --disable-dynamic-vram, le déconseille : « If you use gguf we recommend keeping dynamic vram enabled and using native ComfyUI model formats instead. ComfyUI native formats like fp8, int8 and w4a8 will be faster even if they are larger than your memory. », c’est-à-dire qu’avec GGUF il vaut mieux garder la VRAM dynamique activée et utiliser plutôt les formats natifs de ComfyUI, comme fp8, int8 et w4a8, qui seront plus rapides même s’ils dépassent ta mémoire. Et l’aide de --lowvram dit : « Doesn’t do anything if dynamic vram is enabled. », l’option ne fait rien si la VRAM dynamique est activée.
Points clés
Section intitulée « Points clés »- Les modèles récents se découpent en un transformer de débruitage, un encodeur de texte qui est un modèle de langage et un VAE, chacun avec son propre loader, et sont souvent distillés à quelques étapes avec un CFG de 1.
- Lis la licence sur la fiche du modèle d’origine, pour le modèle et la taille exacts : klein 4B est sous Apache 2.0, klein 9B ne l’est pas.
- L’en-tête d’un fichier quantifié dit ce qu’il contient : des couches int8 et nvfp4 avec leurs échelles, des couches laissées en bf16, et des formats mélangés dans un même fichier, quoi qu’en dise son nom.
- Un format ne s’exécute nativement que sur les GPU qui ont ses noyaux. Ailleurs, ComfyUI déquantifie à chaque étape : le fichier reste petit, et la vitesse est perdue.
- La VRAM dynamique, activée par défaut sur NVIDIA, exécute des modèles plus gros que le GPU.
nvidia-smimontre alors ce qui est libre, pas ce dont le modèle a besoin, et--lowvramne fait rien. - L’int8 a gardé l’image proche du bf16 ici ; le nvfp4 a fait une autre image de la même scène, à deux fois la vitesse du bf16.
À toi de jouer
Section intitulée « À toi de jouer »Choisis un modèle que tu comptes vraiment utiliser et fais les deux lectures que fait cette leçon. Lis son en-tête et compte les octets par format : combien en int8 ou en fp4, combien restés en bf16, et de combien le fichier s’écarte de la taille que son nom suggère. Lis ensuite sa licence sur la fiche du modèle d’origine, pour la taille exacte que tu as téléchargée — pas pour la famille — et décide avant de générer si ce qui en sortira pourra être publié là où tu comptes le publier.
Exercices
Section intitulée « Exercices »- Un réseau de 4 milliards de paramètres est stocké en bf16, puis en int8 avec une échelle par couche, puis en nvfp4 avec tous les poids quantifiés. Estime la taille de chaque fichier.
- Tu exécutes
z_image_turbo_nvfp4.safetensorssur une RTX 4090, de capacité de calcul 8.9. Que liste la ligne de log « Native ops », et qu’arrive-t-il aux couches nvfp4 ? - Un client veut des images de produits pour une boutique en ligne, rendues par FLUX.2 klein. Quel modèle klein peux-tu utiliser, et que vérifies-tu d’abord ?
Solution 1
Le bf16 fait 2 octets par poids : environ 8 Go. L’int8 fait 1 octet : environ 4 Go, plus quelques scalaires. Le nvfp4 fait un demi-octet par poids, plus une échelle d’un octet par bloc de 16 poids, soit un seizième d’octet par poids : environ 4 × 0,5625 = 2,25 Go. Les vrais fichiers sont plus gros, parce que des couches comme les normalisations, les embeddings et, dans le cas de Z-Image-Turbo, les blocs refiner restent en bf16 : le fichier bf16 de klein 4B fait 7,75 Go, et le fichier nvfp4 de Z-Image-Turbo garde 1,46 Go en bf16.
Solution 2
supports_nvfp4_compute exige une capacité de calcul de 10 ou plus, donc nvfp4 passe dans la liste des formats émulés : la ligne liste float8_e4m3fn, float8_e5m2, int8_tensorwise et les autres formats comme natifs, et nvfp4 après « emulated ops ». Le modèle se charge, et chaque couche nvfp4 est déquantifiée en bf16 à chaque passe avant : le gain de mémoire demeure, et la vitesse des noyaux fp4 est perdue. À vérifier : la machine du cours n’a pas de GPU de la série RTX 40 ; cela découle du code.
Solution 3
klein 4B, sous Apache 2.0, autorise l’usage commercial ; klein 9B est sous la FLUX Non-Commercial License. Vérifie la licence sur la fiche de Black Forest Labs pour le fichier exact que tu télécharges, y compris s’il est reconditionné, et garde-en une trace avec l’empreinte du fichier. Vérifie ensuite ce que dit la licence sur les images produites, et les règles propres de la boutique pour les images générées. Ceci n’est pas un avis juridique.
- Z-Image Team, Z-Image: An Efficient Image Generation Foundation Model with Single-Stream Diffusion Transformer, 2025.
- NVIDIA, Introducing NVFP4 for Efficient and Accurate Low-Precision Inference, 2025.
- Documentation de ComfyUI : Z-Image-Turbo, FLUX.2 klein.
- ComfyUI à la v0.36.0 :
QUANTIZATION.md,comfy/ops.py,comfy/quant_ops.py,comfy/model_management.py,comfy/utils.py,comfy/cli_args.py,main.py. - Fiches de modèles : Tongyi-MAI/Z-Image-Turbo, Comfy-Org/z_image_turbo, black-forest-labs/FLUX.2-klein-4B, Comfy-Org/flux2-klein-4B, et, pour la comparaison des licences, stabilityai/stable-diffusion-3.5-large, black-forest-labs/FLUX.1-dev, black-forest-labs/FLUX.1-schnell, Qwen/Qwen-Image.
- city96/ComfyUI-GGUF.