6. ControlNet : contours et profondeur
Sections
Réglages de lecture
Aucune voix pour cette langue dans ce navigateur.
Plus de voix
Code et termes techniques en anglais
Désactivé : la voix de la page lit tout, sans pause entre deux voix.
Aucune voix pour cette langue dans ce navigateur.
Plus de voix
D’autres voix : Microsoft Edge propose des voix naturelles en ligne, et Windows (Paramètres › Heure et langue › Voix), macOS et Android en installent d’autres.
Code : les workflows 06-canny.api.json et 06-depth.api.json.
La leçon 5 partait d’une image existante, et denoise décidait quelle part en survivait. Cela lie les couleurs et les textures à l’ancienne image autant que sa disposition. ControlNet ne garde que la disposition : une carte de contours ou une carte de profondeur guide le sampler à chaque étape, et le sampler part d’un bruit pur. Le point de départ est de nouveau le métronome de la leçon 1, graine 42.
Un second réseau à côté du UNet
Section intitulée « Un second réseau à côté du UNet »L’article de ControlNet (L. Zhang, A. Rao et M. Agrawala, 2023) copie la moitié encodeur d’un UNet entraîné et entraîne la copie sur des paires formées d’une image de condition et d’une image. Le modèle d’origine ne change pas : « ControlNet locks the production-ready large diffusion models, and reuses their deep and robust encoding layers », c’est-à-dire que ControlNet fige les grands modèles de diffusion prêts pour la production, et réutilise leurs couches d’encodage profondes et robustes. Les sorties de la copie passent par des convolutions initialisées à zéro, et sont ajoutées aux activations du UNet lui-même. Avant l’entraînement, le ControlNet n’ajoute donc rien.
Dans ComfyUI, l’addition se trouve dans control_merge. Chaque sortie du ControlNet est multipliée par strength, puis ajoutée à la sortie du ControlNet précédent, s’il y en a un :
if x not in applied_to: #memory saving strategy, allow shared tensors and only apply strength to shared tensors once applied_to.add(x) if self.strength_type == StrengthType.CONSTANT: x *= self.strength... o[i] = prev_val + o[i] #TODO: change back to inplace add if shared tensors stop being an issueEnchaîner deux nœuds ControlNetApplyAdvanced additionne donc leurs effets : une carte de contours et une carte de profondeur peuvent guider la même image, chacune avec sa propre force.
Le workflow
Section intitulée « Le workflow »| Nœud | Ce qu’il fait ici |
|---|---|
LoadImage |
l’image d’où vient la disposition |
Canny, ou les nœuds Lotus |
la transforment en carte de contours, ou en carte de profondeur |
ControlNetLoader |
charge le ControlNet depuis models/controlnet |
SetUnionControlNetType |
indique à un ControlNet union quelle sorte de carte il reçoit |
ControlNetApplyAdvanced |
attache le ControlNet, la carte, strength, start_percent et end_percent au conditionnement positif et négatif |
KSampler |
échantillonne à partir d’un latent vide, comme dans la leçon 1 |
ControlNetApplyAdvanced n’exécute rien. Il copie le conditionnement et y ajoute le ControlNet, pour le prompt positif et pour le négatif, et le sampler l’appelle à chaque étape. Avec un strength de 0, il renvoie le conditionnement inchangé. L’ancien nœud ControlNetApply est marqué obsolète, et n’applique le ControlNet qu’à un seul conditionnement.
Un modèle pour plusieurs sortes de cartes
Section intitulée « Un modèle pour plusieurs sortes de cartes »Les ControlNets pour SDXL ont d’abord été entraînés un par condition : un pour les contours Canny, un pour la profondeur, et ainsi de suite. Le cours utilise plutôt le modèle union ControlNet++ de xinsir, dans sa version ProMax : un seul fichier de 2,5 Go, sous licence Apache 2.0, dont la fiche dit qu’il prend en charge « 10+ control conditions, no obvious performance drop on any single condition compared with training independently », c’est-à-dire plus de dix conditions de contrôle, sans baisse de performance notable sur aucune d’elles par rapport à un entraînement séparé.
Un modèle union doit savoir quelle sorte de carte il reçoit. SetUnionControlNetType la règle, à partir d’une liste de 8 types dans control_types.py :
UNION_CONTROLNET_TYPES = { "openpose": 0, "depth": 1, "hed/pidi/scribble/ted": 2, "canny/lineart/anime_lineart/mlsd": 3, "normal": 4, "segment": 5, "tile": 6, "repaint": 7,}La page de documentation du nœud liste 13 options, avec des noms comme canny, lineart et normalbae que le nœud ne propose pas : les 12 conditions du modèle partagent 8 emplacements, et plusieurs détecteurs de contours en partagent un. Le JSON du workflow doit utiliser les noms du code, sinon le serveur rejette le prompt.
Les contours, avec le nœud Canny
Section intitulée « Les contours, avec le nœud Canny »Le cœur de ComfyUI a peu de préprocesseurs, les nœuds qui transforment une image en carte. Le tutoriel ControlNet le dit : « Since the current Comfy Core nodes do not include all types of preprocessors, in the actual examples in this documentation, we will provide pre-processed images. », c’est-à-dire que, comme les nœuds actuels du cœur n’incluent pas tous les types de préprocesseurs, les exemples de la documentation fournissent des images déjà prétraitées. Un squelette de pose, par exemple, demande un nœud personnalisé ou une image faite ailleurs ; les nœuds personnalisés sont le sujet de la leçon 11. Les contours sont dans le cœur : Canny appelle la fonction canny de Kornia sur le GPU :
output = canny(image[..., :3].to(device=comfy.model_management.get_torch_device(), dtype=torch.float32).movedim(-1, 1), low_threshold, high_threshold)Ses seuils vont de 0,01 à 0,99, à l’échelle des valeurs de l’image. cv2.Canny d’OpenCV, utilisé dans la plupart des fiches de modèles, prend des seuils de 0 à 255 : les valeurs 100 et 200 d’une fiche correspondent ici à environ 0,4 et 0,8, les valeurs par défaut du nœud.
La profondeur, avec Lotus
Section intitulée « La profondeur, avec Lotus »Une carte de profondeur indique à quelle distance se trouve chaque pixel, et ne dit rien des contours à l’intérieur d’une surface. ComfyUI v0.36.0 peut en calculer une sans nœud personnalisé, avec Lotus, un modèle dérivé de Stable Diffusion 2 qui prédit la profondeur en une seule étape. LotusConditioning n’a pas d’entrée : il renvoie un embedding fixe, comme l’explique le commentaire du code, « lotus uses a frozen encoder and null conditioning, i’m just inlining the results », c’est-à-dire que Lotus utilise un encodeur figé et un conditionnement nul, et que le code se contente d’en recopier les résultats.
Le workflow du cours copie les nœuds du blueprint de ComfyUI Image Depth Estimation (Lotus Depth) : l’image est encodée avec le VAE de Stable Diffusion 1.x, échantillonnée pendant une étape sans bruit ajouté et avec le premier niveau de bruit fixé à 999, décodée, puis inversée avec ImageInvert pour que le proche soit clair. Les trois fichiers de la leçon :
| Fichier | Taille | Licence |
|---|---|---|
lotus-depth-d-v1-1.safetensors |
1,7 Go | Apache 2.0 |
vae-ft-mse-840000-ema-pruned.safetensors |
335 Mo | MIT |
xinsir_controlnet_union_sdxl_promax.safetensors |
2,5 Go | Apache 2.0 |
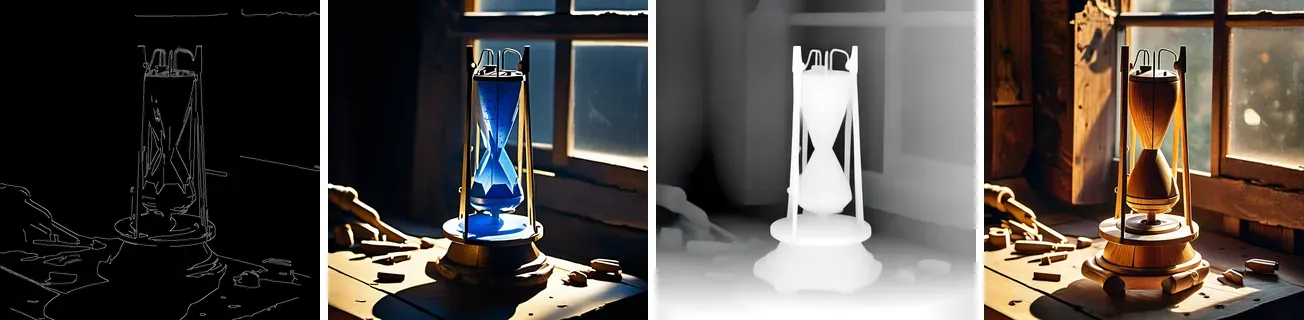
Rendu par ComfyUI v0.36.0 : Stable Diffusion XL base 1.0 avec le ControlNet union SDXL ProMax de xinsir à un strength de 0,8, graine 42, 25 étapes, CFG 7, euler, normal. De gauche à droite : les contours de l’image de la leçon 1, Canny 0,4 et 0,8 ; le rendu de 06-canny.api.json, prompt « a metronome carved from blue ice on an old wooden workbench, morning light through a window, photograph » ; la carte de profondeur de Lotus ; le rendu de 06-depth.api.json, prompt « a small robot made of polished wood on an old wooden workbench, morning light through a window, photograph ».
Les deux rendus ont gardé la silhouette de l’objet et sa place. Le prompt demandait un métronome en glace et un robot, et a obtenu la forme de l’ancien objet en glace et en bois : la carte l’emporte sur les mots là où ils ne sont pas d’accord. Les contours ont aussi gardé les barreaux de la fenêtre et les outils sur l’établi ; la carte de profondeur a gardé l’établi et la fenêtre comme des surfaces, et a laissé le sampler inventer le reste des détails.
Le premier rendu de chaque workflow a pris 17,0 secondes, mesurées par le client, surtout pour charger le ControlNet, et Lotus pour le workflow de profondeur. Les rendus Canny suivants ont pris environ 7,0 secondes chacun.
Force, début et fin
Section intitulée « Force, début et fin »strength met à l’échelle les résidus du ControlNet. start_percent et end_percent disent quand le ControlNet est actif, mais pas en fraction des étapes. percent_to_sigma les convertit en niveaux de bruit sur les 1000 pas de temps d’entraînement du modèle :
def percent_to_sigma(self, percent): if percent <= 0.0: return 999999999.9 if percent >= 1.0: return 0.0 percent = 1.0 - percent return self.sigma(torch.tensor(percent * 999.0)).item()et get_control saute le ControlNet quand le niveau de bruit courant est hors de cette plage. Pour SDXL, un end_percent de 0,3 correspond au niveau de bruit 3,33. Avec 25 étapes et le scheduler normal, les 8 premières étapes commencent au-dessus (14,6, 11,4, 9,08, 7,30, 5,95, 4,90, 4,09 et 3,44), donc le ControlNet guide 8 étapes sur 25, et non 7,5.
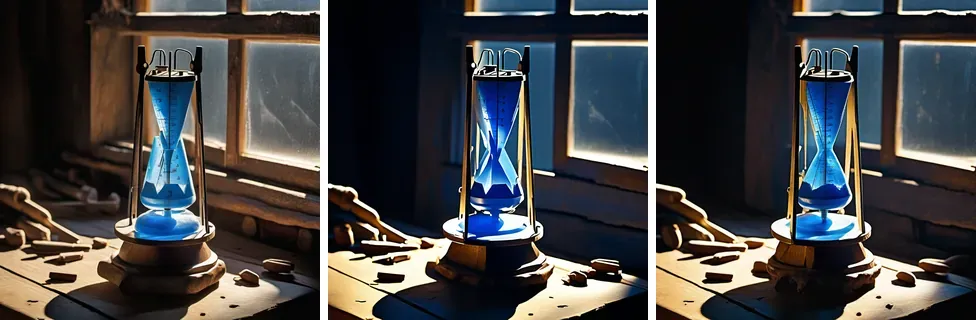
Rendu par ComfyUI v0.36.0 : Stable Diffusion XL base 1.0 avec le ControlNet union SDXL ProMax de xinsir, graine 42, 25 étapes, CFG 7, euler, normal, workflow 06-canny.api.json. De gauche à droite : strength 0,3, strength 1,0, et strength 0,8 avec end_percent 0,3.
Deux observations sur cette image, qui peuvent ne pas valoir pour d’autres :
- À un
strengthde 0,3, la silhouette de l’objet est toujours celle de la carte de contours. C’est la pièce autour qui a bougé. - Arrêter le ControlNet après 8 étapes n’a presque rien changé. La disposition se fixe dans les premières étapes, les plus bruitées, comme l’a décrit la leçon 2 ; les étapes suivantes ajoutent des détails, et la carte n’a pas de détails à donner.
Un start_percent tardif fait l’inverse : le prompt choisit la disposition, et la carte ne fait que la corriger. À vérifier : pas rendu pour cette leçon.
Canny en CI, et quatre empreintes différentes
Section intitulée « Canny en CI, et quatre empreintes différentes »La CI exécute le nœud Canny sur le CPU, sur la mire de 64 sur 48 de la leçon 5, avec des seuils de 0,05 et 0,15. La première exécution comparait son empreinte de pixels comme les sorties des autres nœuds, et a échoué sur chaque système. La CI affiche maintenant l’empreinte, et le nombre de pixels plus clairs que 127, à titre d’information :
| Machine | SHA-256 des pixels | Pixels de contour |
|---|---|---|
| celle de l’auteur, Windows 11 | 77af5cb1b7e93a5c |
464 sur 3072 |
CI, ubuntu-latest |
bb92bc1020c06a83 |
467 sur 3072 |
CI, macos-latest |
4db7c3194e9fe1e2 |
467 sur 3072 |
CI, windows-latest |
8e3e55838a7c9d46 |
467 sur 3072 |
Le même ComfyUI, le même graphe PyTorch et les mêmes pixels ont donné quatre images différentes. Les trois runners ont trouvé le même nombre de pixels de contour, mais pas aux mêmes endroits. Canny lisse l’image, calcule des gradients, amincit les contours et les garde en comparant des valeurs à des seuils. Un gradient qui tombe juste au-dessus d’un seuil dans un calcul en virgule flottante et juste en dessous dans un autre ajoute ou retire un pixel de contour, et chaque CPU et chaque bibliothèque mathématique arrondit un peu différemment. La leçon 2 a trouvé le même genre de différence dans le bruit de deux périphériques.
L’étape où ça cesse de coïncider
Section intitulée « L’étape où ça cesse de coïncider »data/canny-steps.py appelle les fonctions de Kornia dans l’ordre où canny les applique et affiche une empreinte par étape. Son motif de 64 sur 48 est construit en arithmétique entière, donc l’entrée fait les mêmes octets sur toutes les machines — la première ligne du tableau le montre. check.sh l’exécute sur les trois machines de CI à chaque commit ; la première colonne est celle de l’auteur, dont PyTorch est la version CUDA, qui tourne ici sur le CPU.
| Étape | celle de l’auteur, 2.13.0+cu130 |
windows-latest, +cpu |
ubuntu-latest, +cpu |
macos-latest, 2.13.0 |
|---|---|---|---|---|
| entrée | 1907433ac4d80c9f |
1907433ac4d80c9f |
1907433ac4d80c9f |
1907433ac4d80c9f |
| flou gaussien | 769c45e000258c56 |
ee71eaac28f8cc27 |
ee71eaac28f8cc27 |
96d1452970dc7b72 |
| gradient spatial | b06a49b51ebc7fa1 |
bf069945ff2cd851 |
17564ac6064fd8d8 |
5d47abc9d0ba75f4 |
| magnitude | 0af967b932bcb57c |
bda4e821a72c09ed |
208a0f39607e1ae0 |
bf05d8003b885379 |
| contours | 08e9b5af22548246 |
08e9b5af22548246 |
08e9b5af22548246 |
08e9b5af22548246 |
La divergence commence dès la première étape en virgule flottante. Le flou sépare déjà la machine de l’auteur des runners, et le runner Apple Silicon des deux x86. Le gradient diffère ensuite sur les quatre, alors que Windows et Linux coïncidaient une étape plus tôt : la même convolution emprunte un chemin différent selon la compilation. Toutes les magnitudes diffèrent, et pourtant leur somme s’affiche 2729.489258 sur les quatre — les différences sont dans les derniers bits. Cette somme est un piège en soi : imprimée à six décimales, elle additionne les écarts et les efface, si bien que qui aurait comparé des sommes aurait conclu que les quatre machines coïncident et se serait arrêté là. Un total n’est pas une empreinte. C’est pourquoi tous les contrôles de ce cours hachent des octets.
La précision est l’autre moitié de l’histoire. La sonde de Hadamard de la leçon 8 tourne sur les mêmes trois machines de CI et calcule en float64 : elle affiche les mêmes cinq décimales sur les trois, 0.05674 et 0.00761, et seule sa borne d’exactitude bouge, entre 1,11e-14 et 1,20e-14. La divergence n’est pas une fatalité — elle dépend de la précision où l’on travaille, et la diffusion travaille en float32 ou plus étroit.
La dernière ligne est la surprise : les contours sont identiques partout, 1 461 pixels sur 3 072, la même empreinte sur les quatre machines. Ce motif n’est fait que d’aplats et de bords francs, donc aucun gradient ne passe assez près d’un seuil pour qu’une différence de dernier bit le fasse basculer. Un rendu n’a pas cette marge, et c’est pourquoi le motif de la leçon 5, passé dans Canny à l’intérieur de ComfyUI, donne quatre empreintes. La réponse a donc deux moitiés : la virgule flottante diverge dès la première convolution, sur toutes les machines, toujours ; que cela atteigne la sortie dépend du nombre de pixels que l’image laisse près du seuil.
Points clés
Section intitulée « Points clés »- Un ControlNet est une copie entraînée de l’encodeur du UNet. Ses sorties, multipliées par
strength, sont ajoutées aux activations du UNet, et des ControlNets enchaînés s’additionnent. - Un ControlNet union a besoin de
SetUnionControlNetType, avec les noms de types du code de ComfyUI, pas de sa documentation. - Le cœur a
Cannypour les contours et Lotus pour la profondeur. Les autres cartes demandent un nœud personnalisé ou une image faite ailleurs. start_percentetend_percentsont des fractions de la plage de bruit, pas des étapes.- La disposition se décide dans les premières étapes : un ControlNet actif seulement pendant celles-ci a gardé presque toute la composition.
- Les filtres d’image sont eux aussi du code en virgule flottante : ne compare pas leur sortie bit à bit d’une machine à l’autre. La divergence commence à la première convolution ; qu’elle atteigne la sortie dépend de la proximité de l’image au seuil.
- Un total n’est pas une empreinte : une somme additionne les écarts qu’une empreinte montrerait.
À toi de jouer
Section intitulée « À toi de jouer »Dessine toi-même une mise en place grossière — trois boîtes et un horizon dans n’importe quel éditeur d’images — et sers-t’en comme image de contrôle. Passe-la au Canny avec deux paires de seuils, puis fais varier strength de 0,2 à 1,2 et trouve la valeur où ta mise en place cesse d’être suivie. Termine avec end_percent à 0,3 : la composition doit tenir pendant que le détail s’émancipe.
Exercices
Section intitulée « Exercices »- Les seuils
Cannyd’une fiche de modèle sont 50 et 150, pour OpenCV. Quelles valeurs mettre dans le nœud ? - Enchaîne les ControlNets Canny et profondeur, chacun à un
strengthde 0,5, dans un seul workflow. Quels nœuds changent, et que prennent en entrée les deux nœudsControlNetApplyAdvanced? - Avec 25 étapes, le scheduler
normalet SDXL, combien d’étapes guide un ControlNet avec unstart_percentde 0,5 et unend_percentde 1,0 ? Utilise la liste des niveaux de bruit de cette leçon et le fait quepercent_to_sigma(0.5)vaut 1,616.
Solution 1
Les valeurs du nœud sont sur l’échelle de 0 à 1 des pixels de l’image : 50 / 255 vaut environ 0,2, et 150 / 255 environ 0,59. À vérifier : cela suppose que l’image de la fiche était en 8 bits et que les seuils de Kornia comparent les mêmes normes de gradient que ceux d’OpenCV, ce que cette leçon n’a pas mesuré.
Solution 2
Charge le ControlNet une seule fois, et donne-le à deux nœuds SetUnionControlNetType, l’un avec canny/lineart/anime_lineart/mlsd et l’autre avec depth. Le premier ControlNetApplyAdvanced prend le conditionnement des prompts, les contours Canny et un strength de 0,5. Le second prend les sorties du premier comme positive et negative, la carte de profondeur et un strength de 0,5. KSampler prend les sorties du second. À vérifier : pas rendu pour cette leçon.
Solution 3
Le ControlNet est sauté tant que le niveau de bruit est au-dessus de percent_to_sigma(0.5), 1,616, et un end_percent de 1,0 se convertit en 0, donc il ne s’arrête jamais. Dans la liste, les 13 dernières étapes commencent à 1,616 ou en dessous : 1,616, 1,408, 1,228, 1,071, 0,932, 0,808, 0,695, 0,591, 0,494, 0,400, 0,306, 0,203 et 0,029. Le ControlNet guide 13 étapes sur 25, après que les 12 premières ont choisi la disposition.
Le niveau de la treizième étape vaut exactement 1,616 en double précision Python, parce que le scheduler normal place les étapes sur des pas de temps régulièrement espacés et que 0,5 tombe sur l’un d’eux. La comparaison est sigma > 1.616, donc cette étape est incluse. À vérifier : le sampler compare un tenseur PyTorch, dont la précision peut faire tomber l’étape de l’autre côté.
- L. Zhang, A. Rao, M. Agrawala, Adding Conditional Control to Text-to-Image Diffusion Models, 2023.
- J. He et al., Lotus: Diffusion-based Visual Foundation Model for High-quality Dense Prediction, 2024.
- Documentation de ComfyUI : tutoriel ControlNet, combiner des ControlNets,
SetUnionControlNetType,Canny,LotusConditioning. - ComfyUI à la v0.36.0 :
nodes.py,comfy/controlnet.py,comfy/cldm/control_types.py,comfy_extras/nodes_canny.py,comfy_extras/nodes_lotus.py,comfy/model_sampling.py. - Fiches de modèles : xinsir/controlnet-union-sdxl-1.0, Comfy-Org/lotus, jingheya/lotus-depth-d-v1-1, stabilityai/sd-vae-ft-mse-original.