7. LoRA : chargement, empilement, et ce qu'implique d'en entraîner un
Sections
Réglages de lecture
Aucune voix pour cette langue dans ce navigateur.
Plus de voix
Code et termes techniques en anglais
Désactivé : la voix de la page lit tout, sans pause entre deux voix.
Aucune voix pour cette langue dans ce navigateur.
Plus de voix
D’autres voix : Microsoft Edge propose des voix naturelles en ligne, et Windows (Paramètres › Heure et langue › Voix), macOS et Android en installent d’autres.
Code : les workflows 07-lora.api.json, 07-lcm.api.json, 07-lightning.api.json et 07-lora-stack.api.json ; le lecteur d’en-têtes dans csharp/Safetensors.cs.
Un checkpoint, ce sont plusieurs gigaoctets de poids. Les affiner tous pour un style ou un sujet produit un autre checkpoint de la même taille. Un LoRA ne stocke qu’une modification de certains poids, dans un fichier qui fait souvent quelques centaines de mégaoctets, et ComfyUI l’ajoute au checkpoint quand il charge le modèle. En termes de C# ou de Java, c’est un plugin qui modifie les données de l’hôte, pas son code.
L’adaptation de rang faible
Section intitulée « L’adaptation de rang faible »LoRA (E. Hu et al., 2021) « freezes the pre-trained model weights and injects trainable rank decomposition matrices into each layer », c’est-à-dire fige les poids du modèle pré-entraîné et injecte dans chaque couche des matrices de décomposition de rang entraînables. Pour une matrice de poids W à n sorties et m entrées, l’entraînement apprend deux petites matrices au lieu d’un nouveau W : B, de n sur r, et A, de r sur m, où r, le rang, est petit, par exemple 32. Leur produit B·A a la forme de W, et lui est ajouté :
W’ = W + strength × (alpha / r) × B·A
alpha est un nombre stocké dans le fichier pour chaque couche, et strength est la valeur que tu règles dans ComfyUI. Pour une matrice d’attention de 1280 sur 1280, un LoRA de rang 32 stocke 2 × 32 × 1280 = 81 920 nombres au lieu de 1 638 400. Une fois ajoutée, la modification ne coûte rien pendant l’échantillonnage : l’article insiste sur « no additional inference latency », aucune latence d’inférence supplémentaire.
Lire l’en-tête d’un LoRA
Section intitulée « Lire l’en-tête d’un LoRA »L’outil du cours lit l’en-tête d’un fichier .safetensors, le JSON qui donne le nom, le type et la forme de chaque tenseur, sans charger les poids. Pour un LoRA, il compte les couches adaptées à partir de leurs matrices lora_down, dont la première dimension est le rang, et lit les scalaires alpha :
> comfy safetensors-info pixel-art-xl.safetensorspixel-art-xl.safetensors: header 311840 bytes, 2166 tensors, 0.17 GB of tensor data  BF16      2166 tensors,   0.17 GBLoRA: 722 adapted layers (722 in the UNet, 0 in the text encoders), rank 32  alpha: 32 (the weight change is scaled by alpha / rank)metadata ss_sd_model_name: sd_xl_base_0.9.safetensorsmetadata ss_base_model_version: sdxl_base_v0-9metadata ss_network_module: networks.lorametadata ss_network_dim: 32metadata ss_network_alpha: 32.0
> comfy safetensors-info lcm_lora_sdxl.safetensorslcm_lora_sdxl.safetensors: header 350920 bytes, 2364 tensors, 0.39 GB of tensor data  F16       2364 tensors,   0.39 GBLoRA: 788 adapted layers (788 in the UNet, 0 in the text encoders), rank 64  alpha: 8 (the weight change is scaled by alpha / rank)metadata ss_base_model_version: sdxl_base_v1-0metadata ss_network_module: networks.lorametadata ss_network_dim: 1metadata ss_network_alpha: 1metadata modelspec.architecture: stable-diffusion-xl-v1-base/lorametadata modelspec.title: sdxl_LCM_lora_rank1
Trois choses apparaissent ici qu’aucun loader ne te dit :
- Les deux LoRA ne modifient que le UNet. Le
strength_clipdeLoraLoadern’a aucun effet avec eux. - Le LoRA pixel art a été entraîné sur SDXL 0.9, et est utilisé ici sur la 1.0.
- Les métadonnées du LCM-LoRA indiquent un rang de 1 et un alpha de 1, et son titre dit
rank1. Les tenseurs indiquent un rang de 64 et un alpha de 8 : ses modifications sont mises à l’échelle par 8 / 64 = 0,125. ComfyUI lit les tenseurs, pas les métadonnées, donc le loader n’est pas affecté, mais un outil qui se fie aux métadonnées se trompe sur ce fichier.
La CI ne peut pas télécharger de LoRA, donc elle exécute la même commande sur deux fichiers minuscules écrits par data/tiny-safetensors.py, un LoRA de 2 couches et une couche quantifiée pour la leçon 8, et compare la sortie sur les trois systèmes.
Où ComfyUI applique le patch
Section intitulée « Où ComfyUI applique le patch »LoraLoader prend le modèle et les encodeurs de texte CLIP du loader de checkpoint, et en renvoie de nouveaux. Il lit le fichier une fois par nœud, et le garde pour l’exécution suivante. Il ne calcule aucun poids. load_lora_for_models fait correspondre les noms du fichier aux couches du modèle, clone le patcher du modèle, et enregistre les patchs avec leur force :
lora = comfy.lora_convert.convert_lora(lora)loaded = comfy.lora.load_lora(lora, key_map)if model is not None: new_modelpatcher = model.clone() k = new_modelpatcher.add_patches(loaded, strength_model)Le clone partage les poids du modèle d’origine. Les patchs sont appliqués quand le sampler a besoin du modèle, par calculate_weight dans weight_adapter/lora.py, qui est la formule ci-dessus :
if v[2] is not None: alpha = v[2] / mat2.shape[0]else: alpha = 1.0... weight += function(((strength * alpha) * lora_diff).type(weight.dtype))v[2] est l’alpha du fichier, et mat2.shape[0] le rang. Le log du serveur affiche le nombre de patchs quand le modèle se charge, 722 pour le LoRA pixel art :
Model SDXL prepared for dynamic VRAM loading. 4896MB Staged. 722 patches attached. Force pre-loaded 512 weights: 1197 KB.Un fichier dont les noms ne correspondent à rien dans le modèle n’échoue pas. load_lora écrit lora key not loaded dans le log pour chaque nom et continue : un LoRA fait pour un autre modèle de base, comme Stable Diffusion 1.5 appliqué à SDXL, ne change rien, sans rien dire. Cherche cette ligne, ou 0 patches attached, quand un LoRA semble ne rien faire.
Un LoRA de style, à trois forces
Section intitulée « Un LoRA de style, à trois forces »Pixel Art XL est un LoRA de 171 Mo sous la licence CreativeML Open RAIL-M, l’ancienne licence de Stable Diffusion 1.x, sans le « ++ » de celle de SDXL. Sa fiche se contredit : ses conseils disent « No trigger keyword require », qu’aucun mot-clé déclencheur n’est nécessaire, mais ses métadonnées fixent instance_prompt: pixel art, et son exemple de prompt commence par « pixel art ». Le prompt du cours commence aussi par « pixel art ».
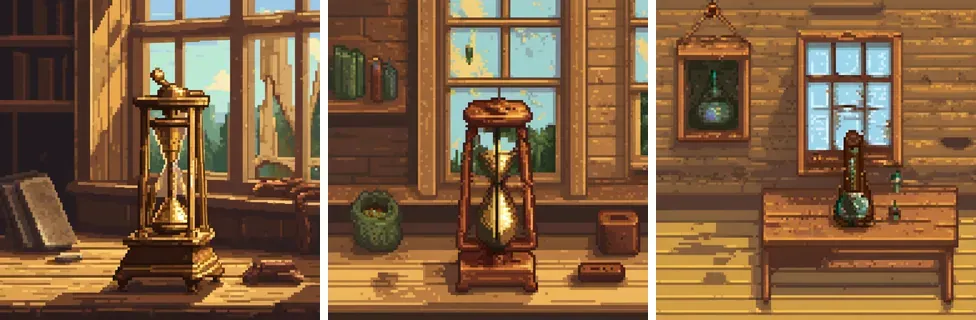
Rendu par ComfyUI v0.36.0 : Stable Diffusion XL base 1.0 avec Pixel Art XL, graine 42, 25 étapes, CFG 7, euler, normal, prompt « pixel art, a brass metronome on an old wooden workbench, morning light through a window », workflow 07-lora.api.json. De gauche à droite : strength_model et strength_clip à 0,5, 1,0 et 1,5.
La force du LoRA est un curseur entre le checkpoint et le style, et les deux extrêmes perdent quelque chose. À 0,5, l’objet est toujours là, avec les détails du modèle de base dessinés en petits pixels. À 1,5, les pixels sont grands et uniformes, et le sujet a disparu : les poids modifiés ne suivent plus le prompt. Les entrées de force vont de −100 à 100, et la page de LoraLoader dit que les valeurs sont « typically used between 0~1 for daily image generation », c’est-à-dire habituellement entre 0 et 1 pour la génération d’images courante.
Moins d’étapes : LCM-LoRA et SDXL-Lightning
Section intitulée « Moins d’étapes : LCM-LoRA et SDXL-Lightning »Certains LoRA changent la façon dont le modèle échantillonne plutôt que ce qu’il dessine. Ces deux-là sont distillés : entraînés pour que le modèle atteigne une image nette en quelques grandes étapes, comme le ferait un modèle enseignant en beaucoup de petites étapes.
| LoRA | Article | Taille | Licence | Réglages de la fiche |
|---|---|---|---|---|
| LCM-LoRA SDXL | arXiv 2311.05556 | 394 Mo | CreativeML Open RAIL++-M | « only between 2 - 8 steps », seulement entre 2 et 8 étapes, guidance « between 1.0 and 2.0 », entre 1,0 et 2,0 |
| SDXL-Lightning 4-step | arXiv 2402.13929 | 394 Mo | CreativeML Open RAIL++-M | « Euler sampler with sgm_uniform scheduler », CFG 0 dans diffusers |
Les fiches des modèles donnent leurs réglages pour la bibliothèque diffusers. Dans diffusers, une guidance de 0 ou de 1 désactive la classifier-free guidance ; dans ComfyUI, c’est un CFG de 1 qui le fait, et le sampler saute alors la passe du prompt négatif (leçon 2). Les workflows utilisent 4 étapes et un CFG de 1, le sampler lcm pour LCM-LoRA, et euler pour Lightning, tous deux avec le scheduler sgm_uniform. La fiche de Lightning conseille aussi d’utiliser son checkpoint complet plutôt que le LoRA sur SDXL base : « Use LoRA only if you are using non-SDXL base models. », c’est-à-dire de n’utiliser le LoRA qu’avec des modèles de base autres que SDXL.
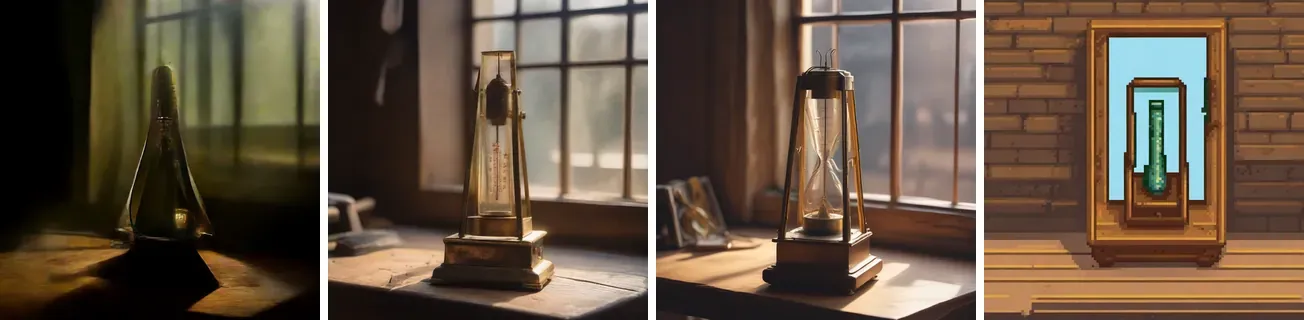
Rendu par ComfyUI v0.36.0 : Stable Diffusion XL base 1.0, graine 42, prompt « a brass metronome on an old wooden workbench, morning light through a window, dust in the air, photograph » pour les trois premières. De gauche à droite : 01-txt2img.api.json avec 4 étapes, CFG 7, euler, normal et sans LoRA ; 07-lcm.api.json, LCM-LoRA, 4 étapes, CFG 1, lcm, sgm_uniform ; 07-lightning.api.json, LoRA SDXL-Lightning 4-step, 4 étapes, CFG 1, euler, sgm_uniform ; 07-lora-stack.api.json, LCM-LoRA à 1,0 et Pixel Art XL à 1,2, 8 étapes, CFG 1,5, lcm, sgm_uniform, prompt « pixel art, a brass metronome on an old wooden workbench, morning light through a window ».
Le modèle de base avec 4 étapes s’est arrêté loin d’une image nette, comme l’a montré la comparaison des étapes de la leçon 2. Les deux LoRA ont donné une image nette avec les mêmes 4 étapes. Aucun n’a dessiné de métronome reconnaissable, mais le modèle de base non plus avec ce prompt : l’image de la leçon 1, avec 25 étapes, ressemble plutôt à un sablier.
Un empilement de deux
Section intitulée « Un empilement de deux »LoraLoader renvoie un modèle, et un autre LoraLoader peut le prendre : la description du nœud dit « Multiple LoRA nodes can be linked together. », c’est-à-dire que plusieurs nœuds LoRA peuvent être enchaînés. Le second loader clone de nouveau le patcher, et ajoute ses propres patchs aux mêmes couches. Quand les poids sont calculés, chaque patch ajoute son terme à W, donc pour de simples LoRA le résultat est
W’ = W + s₁ × (α₁ / r₁) × B₁·A₁ + s₂ × (α₂ / r₂) × B₂·A₂
et l’ordre des loaders ne le change pas. La dernière image ci-dessus empile LCM-LoRA et Pixel Art XL avec les réglages de la fiche de Pixel Art XL : « Use 8 steps and guidance scale of 1.5 », 8 étapes et une guidance de 1,5, et « 1.2 Lora strength for the Pixel Art XL works better », une force de 1,2 pour Pixel Art XL. Le log a affiché 788 patches attached, et non 722 + 788 : les 722 couches du LoRA pixel art font partie des 788 du LCM-LoRA, et les patchs de chaque couche ne comptent qu’une fois.
Ce que coûtent les patchs
Section intitulée « Ce que coûtent les patchs »Un serveur, fraîchement démarré, a exécuté ce qui suit dans l’ordre. Les temps sont les lignes « Prompt executed » du serveur, et chaque exécution « nouvelle graine » ne changeait que la graine, donc les résultats des encodeurs de texte venaient du cache :
| Exécution | Étapes | Première exécution | Nouvelle graine |
|---|---|---|---|
| SDXL base, sans LoRA | 25 | 13,49 s, avec le chargement du checkpoint | 4,93 s |
| LCM-LoRA | 4 | 6,42 s | 1,16 s |
| LoRA SDXL-Lightning | 4 | 7,40 s | 1,09 s |
| LCM-LoRA de nouveau, après Lightning | 4 | 5,37 s |
Changer de LoRA a coûté environ 4 à 5 secondes à la première exécution : lire le fichier de 394 Mo sur le disque et calculer 788 couches modifiées. Ensuite, une image en 4 étapes a pris à peine plus d’une seconde, contre 4,9 secondes pour 25 étapes sans LoRA : le patch ne coûte rien par étape, et le gain vient des étapes. Revenir à LCM-LoRA a coûté de nouveau, parce que LoraLoader ne garde que le dernier fichier qu’il a lu, et les patchs ont été recalculés. nvidia-smi a montré le même pic de mémoire avec et sans LoRA, environ 12,2 Go sur une carte où 2,7 Go étaient déjà utilisés.
La vitesse du sampler lui-même le confirme. Dans les barres de progression d’une série antérieure sur la même machine, les 25 étapes des rendus pixel art ont tourné à 5,5 à 5,9 étapes par seconde, aussi vite que sans LoRA. Le temps est passé dans la phase Model Initializing de la barre de progression, avant la première étape : 2,4 à 4,9 secondes avec le LoRA pixel art, 19,3 secondes la première fois que le fichier de Lightning a été lu sur le disque.
Entraîner un LoRA
Section intitulée « Entraîner un LoRA »L’entraînement apprend A et B à partir d’images d’exemple pendant que le checkpoint reste figé. Les outils habituels sont hors de ComfyUI : kohya-ss/sd-scripts, qui a écrit les métadonnées ss_ ci-dessus, et le guide d’entraînement LoRA de diffusers. ComfyUI v0.36.0 a aussi des nœuds d’entraînement expérimentaux dans nodes_train.py. TrainLoraNode prend le modèle, les latents des images d’entraînement et leur conditionnement, et ses entrées sont les décisions que demande n’importe quel outil d’entraînement :
| Entrée | Valeur par défaut | Ce qu’elle décide |
|---|---|---|
rank |
8 | la taille de A et de B, et du fichier |
steps, batch_size, grad_accumulation_steps |
16, 1, 1 | la durée de l’entraînement, et combien d’images voit chaque mise à jour |
learning_rate, optimizer |
0,0005, AdamW | de combien chaque mise à jour déplace A et B |
loss_function |
MSE | comment le bruit prédit est comparé au vrai |
training_dtype, lora_dtype |
bf16, bf16 | la précision du modèle figé et du LoRA |
gradient_checkpointing, offloading |
activé, désactivé | la mémoire contre le temps |
algorithm |
LoRA | ou LoHa, LoKr, OFT, d’autres méthodes de rang faible |
SaveLoRA écrit le résultat dans un fichier .safetensors, et LoraModelLoader l’applique sans l’enregistrer. Le nœud est marqué expérimental et n’a pas de tutoriel dans la documentation. Ce cours n’entraîne pas de LoRA : la part des 16 Go que prend l’entraînement de SDXL avec ces nœuds est à vérifier.
Points clés
Section intitulée « Points clés »- Un LoRA ajoute strength × (alpha / rang) × B·A à certains poids du checkpoint. Une fois ajouté, il ne ralentit pas le sampler.
- Lis l’en-tête avant de faire confiance à un LoRA : son rang et son alpha sont dans les tenseurs, qui sont justes, et dans les métadonnées, qui peuvent être fausses.
LoraLoaderenregistre des patchs. Ils sont calculés au chargement du modèle, et le log dit combien ont été attachés.- Un LoRA dont les noms ne correspondent pas au modèle ne fait rien, avec seulement un avertissement dans le log.
- Les LoRA à peu d’étapes viennent avec leur propre sampler, scheduler et CFG ; prends-les dans la fiche, et traduis la guidance 0 de diffusers en CFG 1 dans ComfyUI.
- Des LoRA empilés s’additionnent, quel que soit leur ordre.
À toi de jouer
Section intitulée « À toi de jouer »Prends un LoRA que tu as téléchargé et lis son en-tête avant de t’en servir, avec le lecteur safetensors du cours : son rang et son alpha d’après les tenseurs, puis d’après les métadonnées, et vois s’ils s’accordent. Charge-le à trois forces sur le modèle de base pour lequel il a été entraîné, puis délibérément sur un autre, et trouve dans le journal la ligne qui dit combien de patchs ont été attachés — ce nombre fait toute la différence entre un LoRA qui agit et un LoRA qui ne fait rien en silence.
Exercices
Section intitulée « Exercices »- L’en-tête d’un LoRA montre une couche avec un
lora_down.weightde forme 16 sur 640, unlora_up.weightde forme 640 sur 16, et unalphade 8. Avec unstrength_modelde 0,75, par quoi B·A est-il multiplié ? - Tu charges un LoRA fait pour Stable Diffusion 1.5 sur SDXL base. L’image est exactement la même que sans lui. Que cherches-tu dans le log du serveur ?
- Échange les deux nœuds
LoraLoaderde07-lora-stack. T’attends-tu aux mêmes pixels ?
Solution 1
Le rang est 16, la première dimension de lora_down. Le facteur vaut 0,75 × 8 / 16 = 0,375.
Solution 2
Des lignes lora key not loaded:, une par nom du fichier, et 0 patches attached quand le modèle SDXL se charge. Les noms et les formes des couches de SD 1.5 ne correspondent pas à ceux de SDXL, donc aucun patch n’est enregistré, et le sampler exécute le modèle inchangé. À vérifier : pas exécuté pour cette leçon.
Solution 3
La somme est la même en arithmétique exacte, mais l’addition en virgule flottante n’est pas associative : ajouter les deux termes à W dans l’autre ordre peut changer les derniers bits de certains poids, et la leçon 2 a montré comment de petites différences peuvent grossir au fil des étapes. ComfyUI arrondit aussi le résultat vers le type du modèle avec un arrondi stochastique, dont la graine vient du nom de la couche. Attends-toi à la même image à l’œil nu, et pas forcément à la même empreinte de pixels. À vérifier : pas rendu pour cette leçon.
- E. Hu et al., LoRA: Low-Rank Adaptation of Large Language Models, 2021.
- S. Luo et al., LCM-LoRA: A Universal Stable-Diffusion Acceleration Module, 2023.
- S. Lin, A. Wang, X. Yang, SDXL-Lightning: Progressive Adversarial Diffusion Distillation, 2024.
- Documentation de ComfyUI : LoRA, plusieurs LoRA,
LoraLoader,TrainLoraNode. - ComfyUI à la v0.36.0 :
nodes.py,comfy/sd.py,comfy/lora.py,comfy/weight_adapter/lora.py,comfy/model_patcher.py,comfy_extras/nodes_train.py. - Fiches de modèles : nerijs/pixel-art-xl, latent-consistency/lcm-lora-sdxl, ByteDance/SDXL-Lightning.