2. La diffusion, et ce qui rend une image reproductible
Sections
Réglages de lecture
Aucune voix pour cette langue dans ce navigateur.
Plus de voix
Code et termes techniques en anglais
Désactivé : la voix de la page lit tout, sans pause entre deux voix.
Aucune voix pour cette langue dans ce navigateur.
Plus de voix
D’autres voix : Microsoft Edge propose des voix naturelles en ligne, et Windows (Paramètres › Heure et langue › Voix), macOS et Android en installent d’autres.
Code : le workflow est celui de la leçon 1, workflows/01-txt2img.api.json, modifié une entrée à la fois. Les comparaisons utilisent la commande compare de l’outil C# du cours, dans csharp/Png.cs.
La diffusion en une page
Section intitulée « La diffusion en une page »Un modèle de diffusion est entraîné sur une tâche simple. On prend une image de l’ensemble d’entraînement, on y ajoute une quantité aléatoire de bruit gaussien, et on demande au réseau de prédire le bruit qui a été ajouté. En répétant cela sur un très grand nombre d’images et de niveaux de bruit, le réseau apprend à quoi ressemblent les images à chaque niveau de flou et de grain. La méthode vient de Denoising Diffusion Probabilistic Models (Ho, Jain et Abbeel, 2020).
Générer, c’est exécuter la tâche à l’envers. On part de bruit pur, on demande au réseau quelle part en est du bruit, on en retire une partie, et on recommence. Chaque répétition est une étape. Après assez d’étapes, ce qui reste ressemble à une image de la distribution d’entraînement. Un prompt textuel oriente la prédiction à chaque étape, si bien que l’image dérive vers ce que décrit le texte.
Trois raffinements rendent cela praticable, et chacun est un nœud du graphe de la leçon 1.
L’espace latent : le VAE. Débruiter des pixels RVB en 1024 × 1024 coûte cher. La diffusion latente (Rombach et al., 2021) entraîne d’abord un autoencodeur, le VAE, qui compresse une image en un tenseur latent beaucoup plus petit et la restitue, puis applique la diffusion aux latents. Pour SDXL, une image de 1024 × 1024 devient 4 canaux de 128 × 128 : 65 536 valeurs au lieu de 3 145 728, soit 48 fois moins. C’est pourquoi EmptyLatentImage crée torch.zeros([batch_size, 4, height // 8, width // 8]) (nodes.py, ligne 1265), et pourquoi VAEDecode vient en dernier. La compression est avec perte : la fiche du modèle dit « The autoencoding part of the model is lossy. », c’est-à-dire que la partie autoencodeur du modèle perd de l’information.
Les encodeurs de texte : CLIP. Le prompt atteint le réseau sous forme de vecteurs, pas de mots. CLIP (Radford et al., 2021) a été entraîné à placer une image et sa légende près l’une de l’autre dans le même espace vectoriel, donc sa moitié texte transforme un prompt en vecteurs qui ont un sens visuel. SDXL utilise deux encodeurs de texte, « OpenCLIP ViT-bigG in combination with CLIP ViT-L », soit OpenCLIP ViT-bigG combiné à CLIP ViT-L, et concatène leurs sorties (article de SDXL). Dans ComfyUI, les deux se cachent derrière une seule sortie CLIP et un seul nœud CLIPTextEncode.
Le réseau de débruitage. Celui de SDXL est un UNet, un réseau convolutif avec des couches d’attention par lesquelles entrent les vecteurs du texte. Son article décrit « a three times larger UNet backbone », un UNet trois fois plus grand que dans les versions précédentes de Stable Diffusion. Dans ComfyUI, c’est la sortie MODEL, et KSampler l’appelle une ou deux fois par étape.
| Dans l’article | Dans le graphe | Taille chargée sur cette machine |
|---|---|---|
| Encodeurs de texte, CLIP ViT-L et OpenCLIP ViT-bigG | CLIP → CLIPTextEncode |
1 560 Mo |
| UNet de débruitage | MODEL → KSampler |
4 896 Mo |
| Autoencodeur | VAE → VAEDecode |
159 Mo |
| Le bruit initial | créé dans KSampler, à partir de la graine |
— |
D’où vient le bruit
Section intitulée « D’où vient le bruit »Le nœud EmptyLatentImage ne crée pas de bruit ; son latent ne contient que des zéros. C’est KSampler qui crée le bruit, dans comfy/sample.py :
def prepare_noise_inner(latent_image, generator, noise_inds=None):    if noise_inds is None:        return torch.randn(latent_image.size(), dtype=torch.float32, layout=latent_image.layout, generator=generator, device="cpu").to(dtype=latent_image.dtype)
def prepare_noise(latent_image, seed, noise_inds=None):    generator = torch.manual_seed(seed)
La graine initialise le générateur de nombres aléatoires de PyTorch, et le bruit est tiré sur le CPU, puis déplacé vers le GPU. Le bruit de départ pour une graine et une taille de latent données ne dépend donc pas de la carte graphique. C’est comme new Random(42) en C# ou en Java : la même graine donne la même suite. Ce qui arrive ensuite à ce bruit s’exécute sur le GPU, et c’est là que la reproductibilité se complique, comme le montre la seconde moitié de cette leçon. Le tutoriel texte-vers-image de ComfyUI dit que EmptyLatentImage « constructs a pure noise latent space », c’est-à-dire construit un espace latent de bruit pur ; le code dit le contraire.
Les entrées du sampler, une à la fois
Section intitulée « Les entrées du sampler, une à la fois »Toutes les images ci-dessous ont été rendues par ComfyUI v0.36.0 à partir du workflow de la leçon 1 avec une seule entrée modifiée. Pour chaque image : Stable Diffusion XL base 1.0, 1024 × 1024, prompt positif « a brass metronome on an old wooden workbench, morning light through a window, dust in the air, photograph », prompt négatif « blurry, text, watermark », workflow 01-txt2img.api.json, réduites pour cette page. Sauf mention contraire dans la légende : graine 42, 25 étapes, CFG 7, sampler euler, scheduler normal.
Les étapes
Section intitulée « Les étapes »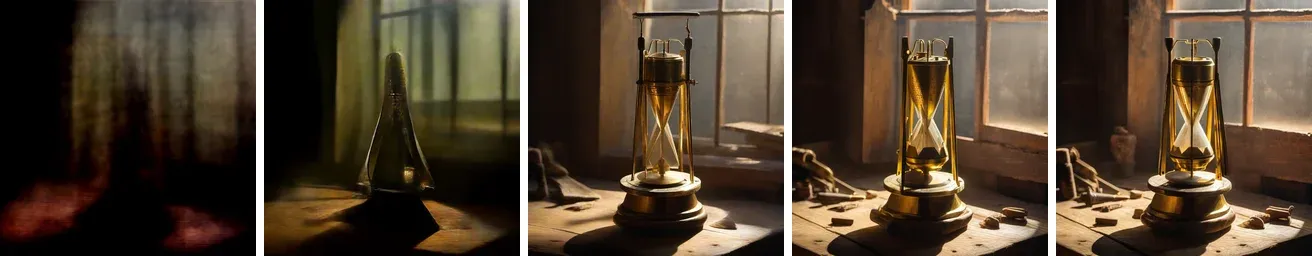
Graine 42 ; 1, 4, 10, 25 et 50 étapes.
Avec une étape, le sampler retire d’un seul coup tout le bruit qu’il prédit, et obtient un flou. La scène apparaît entre 4 et 10 étapes. De 25 à 50, la composition reste mais les détails changent : l’outil de comparaison trouve 99,37 % des pixels différents, dont 40,87 % de plus de 8 niveaux sur 255. Plus d’étapes n’est pas un affinage de la même image, c’est un autre chemin à travers le même modèle. Le temps d’exécution, avec les prompts déjà encodés, croît avec les étapes : 0,83 s pour 1 étape, 2,15 s pour 10, 4,6 s pour 25, 8,56 s pour 50.
Le CFG, classifier-free guidance
Section intitulée « Le CFG, classifier-free guidance »À chaque étape, le sampler exécute le réseau deux fois : une fois avec le prompt positif, une fois avec le négatif. Il s’éloigne ensuite de la prédiction négative et se rapproche de la positive, dans comfy/samplers.py :
cfg_result = uncond_pred + (cond_pred - uncond_pred) * cond_scalecond_scale est l’entrée cfg. Avec 1, le résultat est la prédiction positive seule. Avec 7, la différence entre les deux prédictions est multipliée par sept. La méthode vient de Classifier-Free Diffusion Guidance (Ho et Salimans, 2022).
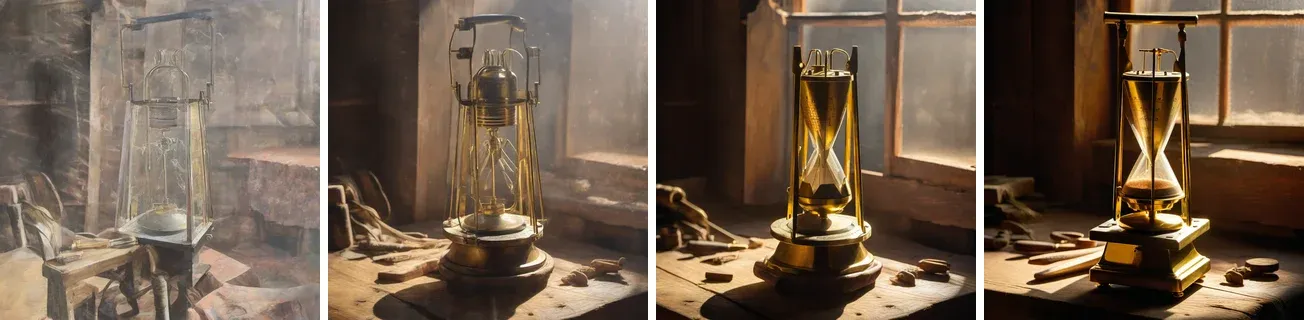
Graine 42 ; CFG 1, 3, 7 et 12.
Ici, un CFG bas a suivi le prompt de loin et donné des images pâles et brumeuses, et un CFG plus élevé a donné plus de contraste et de saturation. Le CFG 1 était aussi plus rapide : 3,29 s au lieu d’environ 4,6 s. Le sampler saute la prédiction négative quand l’échelle vaut 1 (samplers.py, lignes 609 à 613), puisqu’elle ne changerait pas le résultat, donc chaque étape exécute le réseau une fois au lieu de deux.
Sampler et scheduler
Section intitulée « Sampler et scheduler »Le scheduler décide du niveau de bruit à chaque étape : à quelle vitesse le bruit descend, du niveau le plus haut jusqu’à zéro. Le sampler est la méthode numérique qui passe d’un niveau au suivant, un peu comme choisir entre Euler et Runge-Kutta pour résoudre une équation différentielle. Karras et al. (2022) ont présenté les samplers de cette façon, et ont donné leur nom au scheduler karras, qui consacre plus d’étapes aux faibles niveaux de bruit. dpmpp_2m est un solveur du second ordre issu de DPM-Solver++ (Lu et al., 2022). ComfyUI 0.36.0 propose 45 samplers et 9 schedulers.
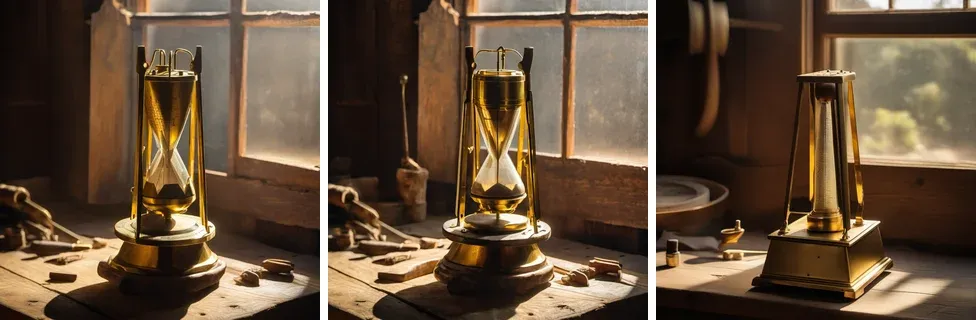
Graine 42 ; euler avec normal, dpmpp_2m avec karras, euler_ancestral avec normal.
euler et dpmpp_2m ont gardé la composition : l’outil a mesuré une différence moyenne de 14,2 niveaux, contre 39,2 pour euler_ancestral. euler_ancestral est un sampler ancestral : à chaque étape, il retire un peu plus de bruit que prédit et rajoute du bruit aléatoire neuf, ce qui lui permet de s’écarter davantage du chemin que suivent les deux autres. Le bruit neuf est lui aussi tiré à partir de la graine, donc une deuxième exécution du même graphe a donné les mêmes pixels. Mais regarde d’où vient ce bruit, dans comfy/k_diffusion/sampling.py :
def default_noise_sampler(x, seed=None):    if seed is not None:        if x.device == torch.device("cpu"):            seed += 1
        generator = torch.Generator(device=x.device)        generator.manual_seed(seed)
Contrairement au bruit initial, il est tiré sur x.device, le GPU quand il y en a un. Les générateurs de nombres aléatoires du CPU et de CUDA ne produisent pas les mêmes nombres pour la même graine, et le code décale même la graine sur le CPU. On s’attend donc à ce que l’image d’un sampler ancestral pour une graine donnée dépende du périphérique ; ce cours n’a pas rendu SDXL sur le CPU pour le mesurer, donc c’est à vérifier.
Graine et lot
Section intitulée « Graine et lot »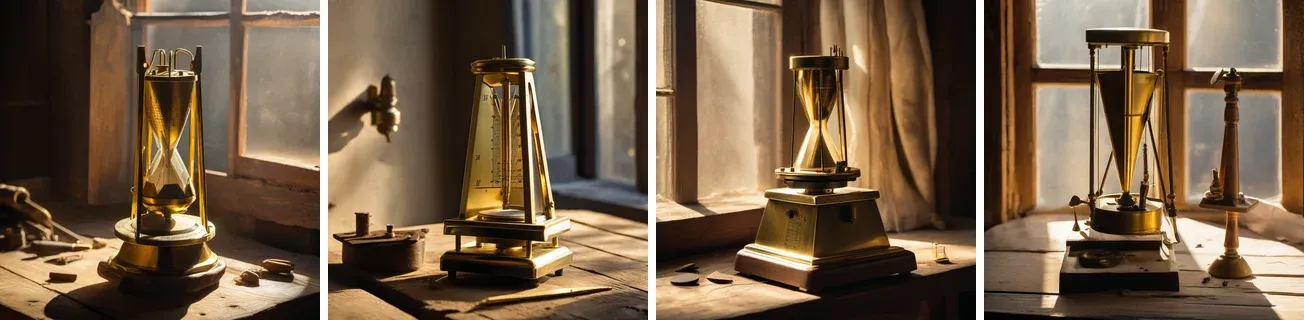
Graines 42, 43 et 7 ; puis la seconde image d’un lot de deux avec la graine 42 (batch_size 2).
Chaque graine est une image différente ; le prompt ne fixe que ce qu’elles ont en commun. Un lot de deux avec la graine 42 ne donne pas les images des graines 42 et 43 : prepare_noise tire un seul tenseur de bruit pour tout le lot à partir d’un seul générateur, donc la seconde image reçoit les nombres qui suivent ceux de la première dans la suite. La première image du lot ressemblait à l’image seule de graine 42, mais n’y était pas identique ; la section suivante explique pourquoi.
La reproductibilité, mesurée
Section intitulée « La reproductibilité, mesurée »La documentation de KSampler dit que la même graine « generates identical images », génère des images identiques. Les notes sur la reproductibilité de PyTorch sont plus prudentes : « Completely reproducible results are not guaranteed across PyTorch releases, individual commits, or different platforms. Furthermore, results may not be reproducible between CPU and GPU executions, even when using identical seeds. » Autrement dit, des résultats complètement reproductibles ne sont garantis ni entre versions de PyTorch, ni entre commits, ni entre plateformes, et peuvent différer entre CPU et GPU même avec des graines identiques.
Pour le vérifier sur une machine, chaque rendu de cette leçon a été haché : le SHA-256 de ses pixels décodés, ses 16 premiers chiffres hexadécimaux, affiché par l’outil C#. Les pixels, pas le fichier : deux PNG des mêmes pixels diffèrent dès que leurs métadonnées diffèrent, et la leçon 3 montre que même les octets compressés dépendent de la bibliothèque zlib.
| Même workflow, graine 42 | Empreinte des pixels |
|---|---|
| Première exécution après le démarrage du serveur | 698e7867e7fc04fb |
| Première exécution après un redémarrage, deux fois | 698e7867e7fc04fb |
Première exécution après un démarrage avec --deterministic |
698e7867e7fc04fb |
| Nouvelle exécution après avoir modifié le prompt négatif puis l’avoir rétabli | 5374ac40a393cf78 |
La même chose, après --deterministic |
5374ac40a393cf78 |
Première exécution après un démarrage avec --disable-dynamic-vram |
5374ac40a393cf78 |
| Mis en file d’attente depuis le navigateur, après des exécutions par l’API | 5374ac40a393cf78 |
| La première image d’un lot de deux | 3a5c00b46e6f4956 |
Ainsi, le même graphe, avec la même graine, le même modèle et le même serveur, a donné deux images différentes, chacune de façon reproductible. La différence ne vient pas de la graine :
> comfy compare default-cold_00001_.png default-warm2_00001_.pngidentical pixels: nolargest difference: 182 of 255, mean 0.922pixels that differ: 68.02 %, by more than 8: 2.63 %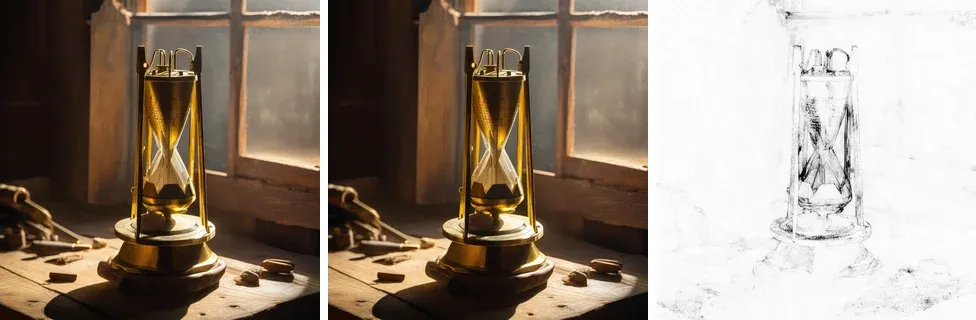
À gauche : première exécution après le démarrage du serveur. Au milieu : le même graphe exécuté de nouveau après le réencodage du prompt négatif. À droite : là où ils diffèrent, amplifié huit fois, sombre là où la différence est grande.
Les deux images diffèrent le long des contours et des détails fins, ce que produisent de petites différences numériques dans le débruitage. Ce qui départage les deux, c’est l’ordre dans lequel les réseaux ont été chargés :
- Sur un serveur neuf, les encodeurs de texte s’exécutent avant que l’UNet soit sur le GPU, et donnent
698e…. - Quand le prompt négatif est encodé de nouveau plus tard, l’UNet est déjà chargé, et le résultat est
5374…. - Avec
--disable-dynamic-vram, qui désactive le mode de chargement que le log signale parDynamicVRAM support detected and enabled, la première exécution donne déjà5374…. --deterministic, qui demande à PyTorch des algorithmes déterministes, n’a rien changé : son texte d’aide prévient qu’il « might not make images deterministic in all cases », qu’il pourrait ne pas rendre les images déterministes dans tous les cas.
Ce cours n’a pas retrouvé quelle opération diffère entre les deux états de chargement ; c’est à vérifier, et noté dans le journal du cours.
Le lot est un troisième cas. Sa première image a le même bruit de départ que l’image seule, mais le débruitage s’exécute sur un tenseur de deux images à la fois, et les noyaux GPU pour un lot de deux n’arrondissent pas exactement comme ceux pour une seule : différence moyenne de 0,739, et 1,49 % des pixels de plus de 8 niveaux.
Ce qui s’est reproduit exactement :
- le même graphe après un redémarrage du serveur, trois fois ;
- la graine 43, exécutée par le client Java de la leçon 4 sur un serveur démarré plus tard, comparée à la même graine rendue plus tôt : pixels identiques ;
euler_ancestral, exécuté deux fois de suite.
Ce que la reproductibilité veut dire en pratique :
- Garde le JSON du prompt avec l’image. ComfyUI l’écrit déjà dans le PNG.
- Note ce qui n’est pas dans le JSON : le SHA-256 du fichier de modèle, le commit de ComfyUI, les versions de PyTorch et du pilote, le GPU, et les options du serveur.
- Compare des pixels avec une tolérance, pas des fichiers avec une empreinte, quand un test vérifie un rendu. Une tolérance n’est pas un hachage perceptuel ; le cours n’a pas vérifié si un hachage perceptuel serait stable dans ces cas.
- Attends-toi à une image différente sur un autre GPU, une autre version de PyTorch ou un autre système. Rien de cela n’a été mesuré ici, donc c’est à vérifier.
Points clés
Section intitulée « Points clés »- Un checkpoint, ce sont trois réseaux : des encodeurs de texte qui transforment le prompt en vecteurs, un UNet de débruitage qui travaille dans un espace latent 48 fois plus petit, et un VAE qui convertit entre latents et pixels.
KSamplertire le bruit de départ à partir de la graine sur le CPU, puis débruite sur le GPU pendantstepsétapes, en appelant l’UNet deux fois par étape sauf si le CFG vaut 1.- Les étapes, le CFG, le sampler, le scheduler et la graine changent chacun l’image, pas seulement sa qualité ; les samplers ancestraux ajoutent à chaque étape un bruit issu de la graine, tiré sur le GPU.
- Sur une machine, le même graphe et la même graine ont donné des pixels identiques d’un redémarrage à l’autre, mais une image différente quand les encodeurs de texte s’exécutaient après le chargement de l’UNet, et dans un lot. Note tout l’environnement, et compare les pixels avec une tolérance.
À toi de jouer
Section intitulée « À toi de jouer »Prends une invite à toi et mesure, au lieu de regarder. Fais un rendu, redémarre le serveur, refais le rendu avec la même graine, et compare les deux PNG avec compare de l’outil C# du cours : ce sont les chiffres, pas tes yeux, qui disent si quelque chose a bougé. Refais ensuite la même graine dans un lot de quatre et compare la première image du lot à l’image seule. Note ce que fait ta machine, comme le fait cette leçon — c’est la réponse de ta machine, pas celle d’ici, sur laquelle tu t’appuieras plus tard.
Exercices
Section intitulée « Exercices »- Une image de 1344 × 768 a à peu près le même nombre de pixels qu’une de 1024 × 1024. Quelle est la taille de son latent, et le rapport entre les nombres de valeurs est-il le même ?
- Rends la graine 42 deux fois avec un CFG de 1 et compare les deux fichiers avec
comfy compare. Puis rends avec un CFG de 1 et de 1,01 : lequel est plus rapide, et pourquoi ? prepare_noiseprend un argumentnoise_inds, rempli à partir dubatch_indexdu latent. Lisprepare_noise_inner: que fait-elle du générateur pour les indices qui ne sont pas dans le lot, et quel problème cela résout-il ?
Solution 1
Le latent fait 4 canaux de 168 × 96, parce que EmptyLatentImage divise chaque côté par 8 : 64 512 valeurs. L’image a 3 × 1344 × 768 = 3 096 576 valeurs. Le rapport est de 48, comme pour 1024 × 1024 : 3 canaux de pixels contre 4 canaux sur un soixante-quatrième de la surface, 64 × 3 / 4 = 48, quelle que soit la taille.
Solution 2
Mets le second rendu à CFG 1 en file d’attente sans rien changer, et rien ne s’exécute : le serveur réutilise son résultat en cache et n’écrit aucun nouveau fichier, donc change le filename_prefix pour obtenir un second fichier. Seul SaveImage s’exécute alors, à partir de l’image en cache, et compare dit identical pixels: yes par construction ; pour comparer deux vrais rendus, redémarre le serveur entre les deux. Le CFG 1,01 est plus lent, comme le CFG 7 : math.isclose(cond_scale, 1.0) est faux pour 1.01, donc le sampler exécute de nouveau le réseau pour le prompt négatif à chaque étape. L’image change très peu, puisque la différence entre les prédictions est multipliée par 1,01 au lieu de 1.
Solution 3
unique_inds, inverse = np.unique(noise_inds, return_inverse=True)noises = []for i in range(unique_inds[-1]+1): noise = torch.randn([1] + list(latent_image.size())[1:], dtype=torch.float32, layout=latent_image.layout, generator=generator, device="cpu").to(dtype=latent_image.dtype) if i in unique_inds: noises.append(noise)Elle tire le bruit de chaque indice de 0 jusqu’au plus grand, et ne garde que les indices du lot. Tirer puis jeter fait avancer le générateur, donc l’image d’indice 3 d’un lot reçoit toujours le bruit qu’elle aurait eu comme quatrième image du lot complet. Cela permet de rendre de nouveau une image d’un lot toute seule, avec le même bruit.
- J. Ho, A. Jain, P. Abbeel, Denoising Diffusion Probabilistic Models, 2020.
- R. Rombach, A. Blattmann, D. Lorenz, P. Esser, B. Ommer, High-Resolution Image Synthesis with Latent Diffusion Models, 2021.
- A. Radford et al., Learning Transferable Visual Models From Natural Language Supervision, 2021.
- J. Ho, T. Salimans, Classifier-Free Diffusion Guidance, 2022.
- T. Karras, M. Aittala, T. Aila, S. Laine, Elucidating the Design Space of Diffusion-Based Generative Models, 2022.
- C. Lu et al., DPM-Solver++: Fast Solver for Guided Sampling of Diffusion Probabilistic Models, 2022.
- D. Podell et al., SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis, 2023.
- ComfyUI à la v0.36.0 :
comfy/sample.py,comfy/samplers.py,comfy/k_diffusion/sampling.py; documentation de KSampler. - PyTorch, Reproducibility.