Journal
Sections
Réglages de lecture
Aucune voix pour cette langue dans ce navigateur.
Plus de voix
Code et termes techniques en anglais
Désactivé : la voix de la page lit tout, sans pause entre deux voix.
Aucune voix pour cette langue dans ce navigateur.
Plus de voix
D’autres voix : Microsoft Edge propose des voix naturelles en ligne, et Windows (Paramètres › Heure et langue › Voix), macOS et Android en installent d’autres.
Avancement
Section intitulée « Avancement »- ComfyUI v0.36.0 (commit
ee71d5c), frontend 1.52.7, SDXL base 1.0 épinglé par l’empreinte du fichier -
check.sh: vérifications hors ligne des workflows, conversion du format de l’interface vers celui de l’API comparée à l’export du frontend, les clients C# et Java contre ComfyUI sur le CPU - CI sous Ubuntu, Windows et macOS, sans GPU ni modèle
- Leçon 1 : le graphe de nœuds, l’installation et une première image
- Leçon 2 : la diffusion, et ce qui rend une image reproductible
- Leçon 3 : les workflows en JSON
- Leçon 4 : l’API HTTP et WebSocket depuis C# et Java
- Traductions en français et en espagnol des leçons 1 à 4
- Leçon 5 : img2img, inpainting et outpainting
- Leçon 6 : ControlNet, contours et profondeur
- Leçon 7 : LoRA
- Leçon 8 : modèles récents, licences, quantification et VRAM
- Traductions en français et en espagnol des leçons 5 à 8
- Leçon 9 : agrandissement, textures raccordables et HDR
- Leçon 10 : vidéo
- Leçon 11 : les nœuds personnalisés, et leur sécurité
- Leçon 12 : ComfyUI en production
- Leçon 15 : audio, lu dans le code source
- Une section « à toi de jouer » sur chaque leçon écrite, et une galerie des trente images
- Leçon 13 : des textures pour ce site et pour GuitarAlchemist
- Leçon 14 : le laboratoire Guitar Alchemist
Ce que ce cours a trouvé dans ComfyUI v0.36.0, dans sa documentation et dans les fichiers qu’il charge, en les exécutant plutôt qu’en lisant ce qu’on en dit. Les liens de code pointent sur ee71d5c, le commit épinglé par le cours. Aucun de ces points n’est encore un rapport de bogue : c’est ce que les mesures ont montré.
| Attendu | Ce qui se passe | Où | Mesure | État |
|---|---|---|---|---|
| Un dossier de base neuf démarre le serveur | Le démarrage s’arrête sur FileNotFoundError : le serveur liste custom_nodes dans le nouveau dossier avant que quoi que ce soit ne le crée |
main.py:198-201 |
Reproduit à chaque dossier de base neuf | Reproduit ; server.sh crée le dossier vide d’abord |
--base-directory ne touche pas à l’installation |
Il a migré la base user/comfyui.db héritée de l’installation, laissé un .bak à côté et copié la base dans le dossier de test |
--base-directory sans --database-url |
L’original a été restauré depuis la sauvegarde ; les deux SHA-256 concordaient | Reproduit ; évité avec --database-url sqlite:///:memory: (Vérification ComfyUI pour la scène orbitale) |
Le tutoriel de démarrage décrit EmptyLatentImage |
Il dit que le nœud fabrique un latent de bruit. Le nœud fabrique des zéros, et c’est KSampler qui fait le bruit |
nodes.py, contre le tutoriel text-to-image |
Lu dans le code du nœud au commit épinglé | Reproduit. La documentation est fausse, le comportement est juste |
| Le même graphe et la même graine donnent les mêmes pixels | L’image change quand l’invite négative est réencodée alors que l’UNet est déjà chargé | nodes.py, CLIPTextEncode et KSampler |
698e7867… sur un serveur neuf, 5374ac40… à chaud : 0,92 niveau d’écart moyen, 2,63 % des pixels au-delà de 8. --deterministic n’a rien changé |
Reproduit. L’opération responsable n’est toujours pas identifiée (Une graine, deux images) |
| Une image dans un lot vaut la même graine rendue seule | La première image du lot diffère du rendu seul | nodes.py, EmptyLatentImage et KSampler |
0,74 niveau d’écart moyen | Reproduit |
| La validation liste tous les problèmes d’un prompt | Un lien vers un nœud absent lève un KeyError hors du bloc try, et le serveur répond une trace qui porte son chemin d’installation |
execution.py:932-933 |
Le serveur a signalé 2 erreurs là où la vérification hors ligne en trouvait 5 ; l’une était classée sous le nœud 3 avec le nom d’entrée du nœud 8, samples |
Reproduit |
| Le PNG enregistre ce que le client a envoyé | La validation convertit chaque entrée FLOAT avec float() et réécrit la valeur dans le prompt enregistré |
execution.py:995-997 |
Le frontend a envoyé 7 pour cfg ; le prompt inscrit dans le PNG contient "cfg": 7.0 |
Reproduit. Sans effet sur l’image, et suffisant pour casser une comparaison octet à octet de deux prompts |
| Les nœuds de sortie s’exécutent dans un ordre stable | Les sorties validées sont gardées dans un ensemble Python, dont l’ordre de parcours suit le hachage de chaînes randomisé | execution.py:1186-1282 |
check.sh a échoué à sa deuxième exécution : les deux SaveImage ont tourné dans l’autre ordre |
Reproduit ; réglé dans le cours par PYTHONHASHSEED=0 |
POST /upload/image a un comportement documenté |
Des octets identiques gardent le nom existant ; des octets différents reçoivent name (1).png |
server.py |
Les deux cas observés ; ni l’un ni l’autre n’est documenté | Reproduit. La documentation est muette |
La page de SetUnionControlNetType liste les types que le nœud a |
La page liste 13 types, le nœud en a 8 | nodes_controlnet.py, contre sa documentation |
Les 8 noms ont été lus dans le code du nœud | Reproduit. Prendre les noms dans le code |
| Les métadonnées d’un LoRA décrivent ses tenseurs | Les métadonnées du LCM-LoRA et son titre disent rang 1 et alpha 1 | sdxl_LCM_lora_rank1.safetensors |
Ses tenseurs donnent rang 64 et alpha 8 | Reproduit. Les métadonnées du fichier sont fausses ; lire les tenseurs (Les modèles des leçons 5 à 8) |
| Le nom d’un fichier quantifié dit ce qu’il contient | qwen_3_4b_fp8_mixed contient 12 couches nvfp4, et qwen_3_4b_fp4_mixed 58 couches fp8 |
Les encodeurs de texte Z-Image-Turbo de Comfy-Org | Comptées dans les en-têtes | Reproduit. « mixed » est l’avertissement : lire l’en-tête |
nvidia-smi montre ce dont un modèle a besoin |
La VRAM dynamique prend ce qui est libre, le chiffre ne dit donc rien du modèle | --disable-dynamic-vram et les lignes de mise en scène du journal |
12,5 à 15,3 Go utilisés pour toutes les configurations, de 19,4 Go de poids bf16 jusqu’au nvfp4 | Reproduit. Ce sont les tailles mises en scène dans le journal qui sont utiles |
| La documentation de l’API liste les routes que le serveur sert | Les routes /api/jobs, le préfixe /api sur toutes les routes et les messages binaires d’aperçu n’y sont pas |
server.py |
Lu dans la table de routage au commit épinglé | Reproduit. La documentation est incomplète |
execution_success signifie que le rendu est lisible dans /history |
Il est envoyé avant que l’historique ne soit écrit. Le même prompt_id posté deux fois s’exécute deux fois et écrase son entrée, et une reconnexion ne rejoue rien |
execution.py, server.py |
Chaque cas a été provoqué sur un serveur CPU et ses réponses enregistrées | Reproduit ; traité dans le worker du cours (ComfyUI en production) |
LoadImage liste les fichiers que le serveur sait lire |
Il liste ceux dont le type MIME commence par image, et cette table appartient à la machine, pas à ComfyUI |
folder_paths.py |
.exr n’a aucun type MIME sur cette machine Windows ni sur l’exécuteur macos-latest, et vaut image/aces sur ubuntu-latest, toutes en Python 3.13 |
Reproduit sur trois machines par data/mime-info.py. Un EXR écrit par SaveImageAdvanced ne peut pas être repris dans la liste sur deux des trois |
| La licence d’un repaquetage couvre les fichiers qu’il livre | Comfy-Org/TRELLIS.2 est étiqueté MIT et livre clip_vision/dino_v3_vit_l.safetensors, qui relève de la licence DINOv3, sans copie de cette licence |
L’arborescence du dépôt | Lu sur la fiche du modèle et dans l’arborescence | Reproduit. Un repaquetage ne change pas la licence d’un fichier. Ceci n’est pas un avis juridique |
| La licence d’un modèle régit ce qu’on fait des poids | La licence Hunyuan 3D 2.0 restreint aussi les lieux où ses sorties peuvent être affichées : clause 5.c, Territoire excluant l’Union européenne, le Royaume-Uni et la Corée du Sud | Clauses 1.l et 5.c, lues au commit 9cd649ba |
Deux rendus avaient déjà été publiés sur ce site, et ont été retirés | Reproduit. Le cours ne publie aucune sortie Hunyuan3D (Un modèle 3D publié avant d’avoir lu sa licence) |
| Un nœud qui prépare un latent d’inpainting laisse les pixels tranquilles | VAEEncodeForInpaint met chaque pixel masqué au gris moyen avant l’encodage, ce que le tutoriel d’inpainting ne dit pas |
nodes.py:443-447 |
À denoise 0,5 la zone masquée revenait en ellipse grise uniforme ; denoise 1 avec un bord adouci de 24 pixels, ou le UNet d’inpainting, donne un résultat utilisable |
Reproduit. Le nœud est fait pour denoise 1 |
| La fiche d’un LoRA décrit le fichier qu’elle livre | Pixel Art XL est publié sous CreativeML Open RAIL-M, et non sous la RAIL++-M du SDXL qu’il étend, et sa fiche dit qu’aucun mot déclencheur n’est nécessaire alors que l’en-tête du fichier fixe instance_prompt: pixel art |
nerijs/pixel-art-xl à 8bf4a4d9 |
Licence lue sur la fiche au moment du téléchargement, instance_prompt lu dans l’en-tête safetensors |
Reproduit. Lire l’en-tête, pas la fiche |
| Quelque chose inspecte un pack de nœuds personnalisés avant son exécution | Rien ne le fait. Chaque pack est importé avec exec_module avant que ses NODE_CLASS_MAPPINGS soient lus, un prestartup_script.py s’exécute plus tôt encore, et le JavaScript du WEB_DIRECTORY d’un pack s’exécute dans le navigateur |
nodes.py:2266 |
comfyui_manager 4.2.2 filtre les installations par niveau de sécurité, écouteur et deux drapeaux, et compare à des noms de paquets connus comme mauvais au démarrage ; aucune étape ne lit le code d’un pack. Les 42 fichiers de sa roue PyPI étaient identiques au tag 4.2.2, commit bd4ede22 |
Reproduit. Installer un pack, c’est exécuter son code |
| Charger un checkpoint n’exécute pas de code | Un pickle dont la charge appelle print s’est exécuté sous pickle.loads et sous torch.load(weights_only=False) ; torch.load(weights_only=True) l’a refusé sur PyTorch 2.13 |
comfyui_controlnet_aux, épinglé au 16 septembre 2026 — un pack, pas le cœur de ComfyUI |
72 appels à torch.load sans weights_only, dont la valeur par défaut n’est sûre qu’à partir de PyTorch 2.6 |
Reproduit |
| Installer un pack est la seule étape qui touche au réseau | ComfyUI-Impact-Pack installe onnxruntime avec pip au premier lancement d’un détecteur ONNX, et son install.py télécharge un .pth de SAM ; rgthree-comfy envoie le SHA-256 d’un fichier de modèle à Civitai quand l’interface demande les informations de ce modèle |
ComfyUI-Impact-Pack/install.py et rgthree-comfy, épinglés au 16 septembre 2026 |
Audit de six packs : ComfyUI-GGUF, comfyui_controlnet_aux, ComfyUI-Impact-Pack, ComfyUI-VideoHelperSuite, rgthree-comfy, ComfyUI_essentials | Reproduit. Rien là-dedans ne suggère une mauvaise intention ; c’est ce qu’un pack peut faire sans le dire |
| La condition d’arrêt du client d’exemple dit que le rendu s’est bien passé | websockets_api_example.py sort sur un message executing dont le nœud vaut null, ce qui dit seulement que plus rien ne tourne — pas si le rendu a réussi, échoué ou été interrompu |
script_examples/websockets_api_example.py:37-40 |
Ce message est envoyé après l’écriture de l’historique, contrairement à execution_success, donc relire les résultats ensuite est sûr ; les clients du cours s’arrêtent plutôt sur execution_success, execution_error ou execution_interrupted |
Pas un défaut, et trop grossier pour un worker : un rendu échoué doit se distinguer d’un rendu terminé |
| Un rendu entièrement mis en cache ne signale que ce qu’il a fait | Il envoie executed pour chaque nœud de sortie, avec les noms de fichiers du premier rendu, et n’écrit aucun fichier |
comfy_execution/asset_enrichment.py:102-115 |
Sur un prompt identique remis en file, le succès de cache à execution.py:446-451 appelle emit_cached_output, qui envoie le message avec la sortie mise en cache |
Reproduit. Un client qui compte les messages executed, ou qui se fie à leurs noms de fichiers, croira que des fichiers ont été écrits |
/object_info liste les entrées d’un nœud sous required et optional |
Une entrée COMFY_DYNAMICCOMBO_V3 porte ses enfants dans ses options, donc le format.codec de SaveVideo n’est dans aucune des deux tables |
/object_info pour SaveVideo, v0.36.0 |
Le vérificateur du cours a signalé « pas d’entrée format.codec » sur trois workflows, et il avait tort |
Pas un défaut : la forme est voulue et la documentation n’en dit rien. Le bug était le nôtre (Un workflow vérifié avant le GPU) |
QUANTIZATION.md désigne le code qu’il décrit |
Il donne MixedPrecisionOps comme « lines 542-648 in comfy/ops.py » ; la classe est ligne 1347, et elle est imbriquée dans la fabrique mixed_precision_ops() au lieu d’être une classe de module |
QUANTIZATION.md:83 contre comfy/ops.py:1346-1347 |
La ligne 542 contient self.weight_comfy_model_dtype = dtype, sans rapport |
Reproduit au commit épinglé (Quatre constats qui n’avaient jamais quitté le rapport) |
| La page du format API décrit les clés de nœuds du format UI | Son tableau donne « Node titles or labels » pour le format d’enregistrement contre « Numeric node IDs » pour le format API ; les deux identifient les nœuds par id | la page du format API des workflows, lue le 22 septembre 2026 | 01-txt2img.ui.json contient nodes en liste de 7 objets, chacun avec un id numérique, aucun avec un title, et links renvoie à ces nombres |
Reproduit. La différence est un tableau contre un objet indexé par l’id, pas des titres contre des ids (Quatre constats qui n’avaient jamais quitté le rapport) |
--lowvram garde moins de modèle en mémoire que par défaut |
Il met VRAMState.LOW_VRAM, mais le budget de chargement partiel prend la même branche pour LOW_VRAM et NORMAL_VRAM et calcule le même montant à partir de la mémoire libre |
comfy/model_management.py:1007-1011 |
Les rendus du 16 septembre n’ont mesuré aucune différence entre le drapeau et le défaut ; --novram, lui, diffère, en fixant le budget à 0,1 |
Reproduit (Quatre constats qui n’avaient jamais quitté le rapport) |
| Un CLI envoie ses commandes là où la ligne de commande le dit | comfy-cli détecte la cible tout seul : cloud si un identifiant cloud est configuré — clé d’API ou session OAuth active — sinon local. Se connecter une fois change la destination des commandes suivantes | comfy_cli/where.py, lu le 22 septembre 2026 sur main ; comfy-cli n’est pas épinglé par ce cours |
L’ordre de priorité est écrit dans la docstring du module, règle 5 | Reproduit. Bon à savoir avant qu’un script ne parte ailleurs que sur localhost (Quatre constats qui n’avaient jamais quitté le rapport) |
Expériences
Section intitulée « Expériences »Une ligne par expérience mesurée. La colonne hypothèse dit ce qui était prévu avant que le nombre n’existe ; là où le cours a mesuré d’abord et compris ensuite, elle le dit, plutôt que d’inventer une prédiction qui connaîtrait déjà la réponse.
| Question | Hypothèse | Résultat mesuré | Verdict | Preuves |
|---|---|---|---|---|
Un denoise inférieur à 1 raccourcit-il le rendu ? |
Non écrite à l’avance. Ce qui était testé, c’est la lecture qu’invite le mot : moins d’étapes pour moins de débruitage | 25 étapes ont tourné pour toutes les valeurs de 0,3 à 0,9, en 4,6 à 5,1 s | Réfutée : denoise fait démarrer l’échantillonneur en cours de route sur un calendrier de même longueur |
Img2img, inpainting, ControlNet et LoRA, 05-img2img.api.json |
| Les deux images de la graine 42 viennent-elles de la mise en scène de la VRAM dynamique ? | Écrite avant le rendu : désactiver la VRAM dynamique devrait ramener les pixels du démarrage à froid | --disable-dynamic-vram a donné l’empreinte à chaud 5374ac40… dès la première exécution, et les mêmes pixels qu’avec la VRAM dynamique, en 78,87 s contre 63,93 |
Non concluante : l’hypothèse a échoué et l’opération responsable reste inconnue | Une graine, deux images, Modèles récents et quantification |
Le modèle d’inpainting SD-XL exige-t-il un strength inférieur à 1,0, comme le dit sa fiche ? |
L’instruction de la fiche tenait lieu de prédiction | 1,0 et 0,99 diffèrent sur 0,01 % des pixels de plus de 8 niveaux | Réfutée sur cette image ; une image ne fait pas une réponse générale | Img2img, inpainting, ControlNet et LoRA, 05-inpaint-model.api.json |
| Que coûte la quantification en image, et que rapporte-t-elle en vitesse ? | Non écrite à l’avance | int8 avec l’encodeur fp8 : 9 à 15 % des pixels diffèrent du bf16 de plus de 8, à 3,1 étapes par seconde contre 1,5. nvfp4 avec fp4 : 62 à 74 %, à 3,7 à 4,1 | Confirmée pour int8, réfutée pour nvfp4 : ce n’est pas une image dégradée mais un autre agencement de la même scène | Modèles récents et quantification, 08-z-image-turbo.api.json |
| Un ControlNet sert-il encore après les premières étapes ? | Écrite dans la leçon avant le rendu : la mise en place se décide tôt, donc end_percent à 0,3 devrait conserver la composition |
Le ControlNet a guidé 8 étapes sur 25, et l’image était presque la même qu’avec lui actif tout du long | Confirmée | Img2img, inpainting, ControlNet et LoRA, 06-canny.api.json |
| Un LoRA ralentit-il l’échantillonnage ? | Non écrite à l’avance. L’hypothèse testée est que des poids ajoutés coûtent du temps à chaque étape | Changer de LoRA a coûté 4 à 5 s avant la première étape ; une image LCM-LoRA en 4 étapes a ensuite pris 1,16 s | Réfutée : le patch est calculé une fois, au chargement du modèle | Img2img, inpainting, ControlNet et LoRA, 07-lcm.api.json |
| Une croix plus large enlève-t-elle le raccord d’une texture décalée et repeinte ? | Écrite après le premier échec et avant le second rendu : 384 pixels de croix, 128 de fondu et denoise 1 devraient le fermer | La croix de 160 pixels a divisé le raccord par deux, de 13,4 à 5,2 niveaux sur la ligne médiane, mais a laissé une ligne mouchetée et un écart de ton. La croix large a enlevé la ligne ; l’écart de ton est resté | Confirmée, avec une réserve : le raccord a disparu, la différence de ton entre les moitiés non | Agrandissement, textures raccordables et HDR, 09-seamless.api.json |
| Un PNG 16 bits ou un EXR d’un rendu sont-ils vraiment HDR ? | Non écrite à l’avance. L’attente testée est qu’un conteneur plus large porte davantage | 256 niveaux par canal dans le PNG 16 bits d’un rendu 8 bits, et aucune valeur au-delà de 1,0 dans l’EXR : le VAE borne sa sortie entre 0 et 1 | Réfutée : le conteneur est HDR, le contenu ne l’est pas | Agrandissement, textures raccordables et HDR, 09-exr.api.json |
| Le décodage VAE par tuiles change-t-il l’image ? | Non écrite à l’avance | 0,93 niveau d’écart moyen en 2048 × 2048, là où un décodage simple tenait aussi sur le GPU | Confirmée : petit, et non nul — décoder simplement quand ça tient | Agrandissement, textures raccordables et HDR, 09-hires-fix.api.json |
La sortie du nœud Canny est-elle comparable d’une machine à l’autre ? |
Écrite avant le passage en CI : un filtre de contours à sortie d’apparence entière devrait donner les mêmes pixels partout | Quatre machines ont donné quatre empreintes de pixels ; les trois exécuteurs de CI ont trouvé 467 pixels de contour, la machine de l’auteur 464 | Réfutée : c’est du code à virgule flottante. La CI affiche les nombres à titre indicatif au lieu de les comparer | Img2img, inpainting, ControlNet et LoRA, check.sh |
Quelle étape du canny de Kornia cesse de coïncider d’une machine à l’autre ? |
Non écrite à l’avance : la leçon demandait l’étape sans en nommer une | L’entrée est identique sur quatre machines ; le flou gaussien sépare trois groupes, le gradient spatial les quatre, toutes les magnitudes diffèrent — et les contours seuillés sont identiques, 1 461 pixels sur 3 072 | Répondu, en deux moitiés : la divergence commence à la première convolution et elle est toujours là ; elle n’atteint la sortie que si des pixels passent près d’un seuil | data/canny-steps.py, leçon 6 |
Que fait l’indicateur convrot d’un checkpoint int8 ? |
Écrite dans la leçon 8 avant la lecture du noyau : une rotation de groupes de poids avant la quantification, pour étaler les grandes valeurs afin qu’une seule échelle leur convienne mieux | comfy-kitchen 0.2.34 tourne chaque groupe de 256 canaux d’entrée par une matrice de Hadamard régulière, symétrique et orthogonale : le poids hors ligne, les activations en ligne. Sur un poids ayant une valeur aberrante par ligne, l’erreur d’aller-retour int8 vaut 5,7 % sans rotation et 0,76 % avec | Confirmée, avec un chiffre. Étant sa propre inverse, la matrice laisse le produit intact ; elle ne change que ce que l’int8 doit contenir | data/convrot.py, leçon 8 |
| Que coûte un démarrage à froid par rapport à un démarrage à chaud ? | Non écrite à l’avance. L’hypothèse sous-jacente est que le temps d’un rendu est son temps d’échantillonnage | Le premier rendu SDXL a pris 14,71 s, dont environ 4 s pour les 25 étapes à 6,4 étapes par seconde ; les modèles chargés, une nouvelle graine a pris 4,6 s | Une dizaine de secondes d’un premier rendu sont du chargement, pas de l’échantillonnage | Premiers rendus, 01-txt2img.api.json |
| Que coûtent les aperçus de latents ? | Non écrite à l’avance. L’hypothèse sous-jacente est que décoder un aperçu en même temps que l’échantillonnage est négligeable | --preview-method taesd a fait passer l’échantillonnage de 6,4 à 4,9 étapes par seconde, environ 23 % |
Un aperçu n’est pas gratuit ; il se paie en vitesse d’échantillonnage | Premiers rendus, 01-txt2img.api.json |
| L’inpainting laisse-t-il les pixels non masqués tranquilles ? | Non écrite à l’avance. L’hypothèse sous-jacente est que un masque confine le changement à la région masquée | Le résultat décodé a changé 6,2 % des pixels hors du masque de plus de 8 niveaux ; le recoller avec ImageCompositeMasked les a laissés identiques |
Réfutée : l’aller-retour par le VAE touche toute l’image, et c’est le recollage qui la préserve | Img2img, inpainting, ControlNet et LoRA, 05-inpaint-model.api.json |
| Un prompt se transfère-t-il à un autre modèle ? | Non écrite à l’avance. L’hypothèse sous-jacente est que un prompt réglé sur un modèle se reporte sur un plus récent | FLUX.2 klein 4B a dessiné un support en laiton, pas un métronome, sur les graines 42, 43 et 44 — 0 sur 3 ; Z-Image-Turbo a dessiné un métronome 3 fois sur 3 | Réfutée : les mêmes mots ne sont pas la même instruction pour deux modèles | Modèles récents et quantification, 08-flux2-klein.api.json |
| Comment une étape d’échantillonnage évolue-t-elle avec la résolution ? | Non écrite à l’avance. L’hypothèse sous-jacente est que le coût suit le nombre de pixels | Environ 0,3 s par étape en 1024 × 1024, et 2,2 à 2,8 s en 2048 × 2048 — 7 à 9 fois le coût pour 4 fois les pixels | Pire que linéaire en nombre de pixels, et c’est la raison d’être du hires fix | Agrandissement, textures raccordables et HDR, 09-hires-fix.api.json |
| Que coûtent le chargement et l’exécution d’un pack de nœuds bien élevé ? | Antérieure pour une moitié seulement : les drapeaux ont été vérifiés contre du code lu au préalable. Pour les temps, Non écrite à l’avance. L’hypothèse sous-jacente est que un pack en Python pur ne coûte rien de mesurable | Sur le CPU, dans un dossier de base jetable : le pack s’est importé en 0,0 s et s’est exécuté en 0,06 s, SaveImage a écrit les mêmes pixels que le PNG attendu du test, et 14 tests unitaires sont passés avec NumPy et Pillow seulement |
Confirmée des deux côtés : les drapeaux se comportent comme la source le dit, et le coût est sous ce que la montre affiche | Les nœuds personnalisés et leur sécurité |
| Peut-on valider 26 workflows sans GPU et sans modèle ? | Non écrite à l’avance. L’hypothèse sous-jacente est que un workflow ne peut pas être vérifié avant que la mémoire existe pour l’exécuter | Un ComfyUI sans modèle sur le CPU a donné son /object_info — 957 classes de nœuds, 1,85 Mo — et les 26 workflows y sont valides. Le contrôle a d’abord signalé que SaveVideo n’a pas d’entrée format.codec sur trois d’entre eux, et il avait tort : le défaut était dans le validateur du cours |
Confirmée : la leçon 10 peut être lancée dès que la mémoire est là | Un workflow vérifié avant le GPU, check.sh |
2026-09-16 — Versions et installation
Section intitulée « 2026-09-16 — Versions et installation »- ComfyUI v0.36.0 est sortie la veille, le 15 septembre 2026, et c’est la dernière version ; son tag pointe vers le commit
ee71d5c. La version portable Windows pour NVIDIA fait 1 917 442 353 octets et embarque Python 3.13.14 et PyTorch 2.13.0 pour CUDA 13.0. - Le cours réutilise une version portable déjà installée sur la machine, et n’y écrit jamais : le serveur démarre avec
--base-directoryqui pointe ailleurs,--models-directoryqui pointe vers les modèles de l’installation, et--database-url sqlite:///:memory:. - Un répertoire de base neuf a fait s’arrêter le serveur au démarrage avec
FileNotFoundError, parce qu’il listecustom_nodesavant de créer quoi que ce soit.server.shcrée le dossier vide. sd_xl_base_1.0.safetensorssur la machine a le SHA-256 qu’indique Hugging Face,31e35c80…7e5b.- Les pages de prise en main et les exemples d’API de la documentation utilisent Stable Diffusion 1.5 en 512 × 512, pas SDXL. La page d’installation manuelle utilise conda ;
venvn’apparaît que sur la page de comfy-cli. Le tutoriel texte-vers-image dit queEmptyLatentImagecrée un latent de bruit ; il crée des zéros, et c’estKSamplerqui crée le bruit.
2026-09-16 — Premiers rendus
Section intitulée « 2026-09-16 — Premiers rendus »- Le premier rendu SDXL a pris 14,71 secondes, dont environ 4 pour les 25 étapes d’échantillonnage à 6,4 étapes par seconde. Avec les modèles chargés, une nouvelle graine a pris 4,6 secondes.
- Le prompt demandait un métronome en laiton ; la graine 42 a dessiné quelque chose comme un sablier. La graine 43 s’en est approchée.
nvidia-smia montré environ 7 Go de plus en usage pendant le rendu. Le log a préparé 1 560 Mo pour les encodeurs de texte, 4 896 Mo pour l’UNet et 159 Mo pour le VAE.- Les aperçus du latent de
--preview-method taesdont ralenti l’échantillonnage de 6,4 à 4,9 étapes par seconde.
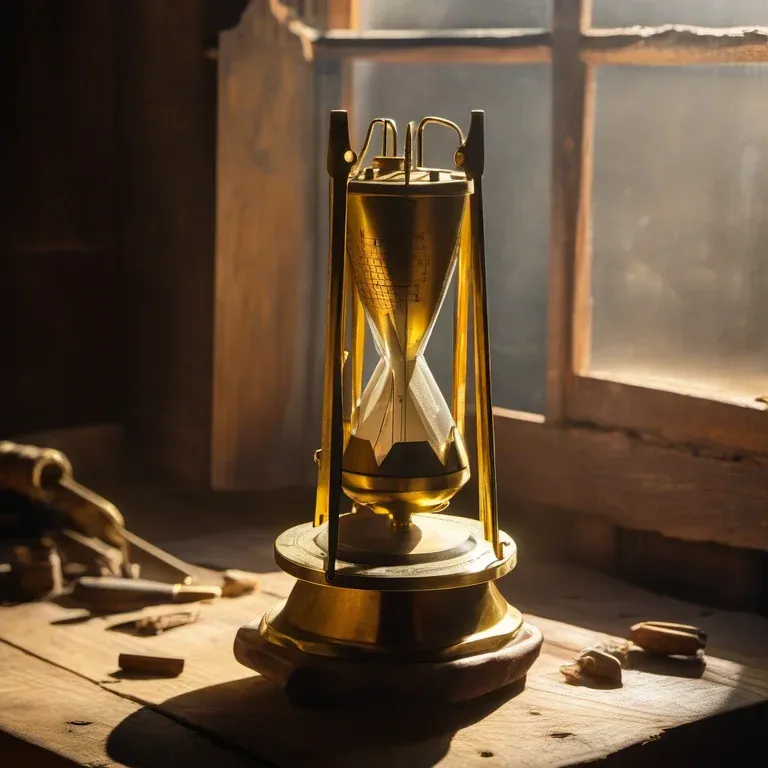
Le premier rendu. ComfyUI v0.36.0 : Stable Diffusion XL base 1.0, graine 42, 25 étapes, euler, normal, CFG 7, 1024 × 1024, workflow 01-txt2img.api.json.
2026-09-16 — Une graine, deux images
Section intitulée « 2026-09-16 — Une graine, deux images »- Le même workflow et la même graine ont donné
698e7867…sur un serveur fraîchement démarré, de nouveau après des redémarrages, et5374ac40…chaque fois que le prompt négatif était encodé de nouveau avec l’UNet déjà chargé. Les deux images diffèrent en moyenne de 0,92 niveau, et 2,63 % des pixels diffèrent de plus de 8. --disable-dynamic-vrama donné5374ac40…dès la première exécution aussi.--deterministicn’a changé aucun des deux résultats. Je n’ai pas trouvé quelle opération diffère.- La première image d’un lot de deux différait de l’image seule de même graine (moyenne 0,74), et la seconde image du lot n’est pas celle de la graine 43.
- Un rendu de graine 43 par le client Java, sur un autre démarrage du serveur 20 minutes plus tard, avait les mêmes pixels que le premier rendu de graine 43.
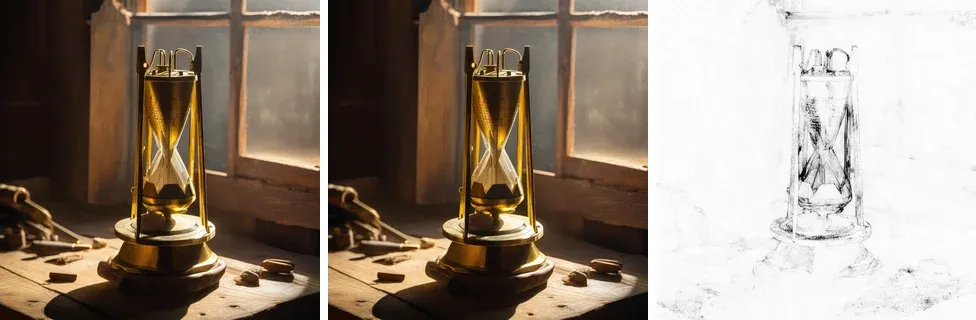
Les deux images de graine 42. ComfyUI v0.36.0 : Stable Diffusion XL base 1.0, graine 42, 25 étapes, euler, normal, CFG 7, workflow 01-txt2img.api.json. À gauche : première exécution après le démarrage du serveur. Au milieu : le même graphe après un nouvel encodage du prompt négatif. À droite : là où elles diffèrent, amplifié huit fois.
2026-09-16 — Les formats JSON et l’API
Section intitulée « 2026-09-16 — Les formats JSON et l’API »- Charger le fichier API dans le frontend et appeler
app.graphToPrompt()a donné un fichier d’interface et un export API. Le convertisseur C#, qui lit les noms des widgets dans l’input_orderde/object_infoet saute le widget de contrôle de la graine, produit l’export octet pour octet. - Un PNG mis en file d’attente depuis le navigateur a enregistré la graine 42 dans son chunk
workflow, et le frontend a changé la graine en 140956311522585 juste après la mise en file, parce que son widgetcontrol_after_generateétait réglé surrandomize. - Le serveur a écrit
"cfg": 7.0dans le prompt du PNG pour un frontend qui avait envoyé7: la validation convertit les entréesFLOATavecfloat()et les réécrit. - Un lien vers un nœud manquant a fait lever à la validation du serveur une
KeyErrorhors de son bloctry. Le serveur a signalé deux erreurs là où la vérification hors ligne en a trouvé cinq ; l’une était rangée sous le nœud 3 avec le nom d’entrée du nœud 8,samples, et une trace d’appels qui contient le chemin d’installation du serveur. check.sha échoué à sa deuxième exécution : les deux nœudsSaveImagese sont exécutés dans l’autre ordre. Le serveur garde les sorties validées dans un ensemble Python, et les hachages de chaînes sont rendus aléatoires à chaque démarrage.server.shfixe maintenantPYTHONHASHSEED=0.- Une exécution entièrement en cache envoie quand même
executedpour chaque nœud de sortie, avec les noms de fichiers de la première exécution, et n’écrit rien. - La première exécution de la CI a échoué sous Ubuntu seulement : le même PNG de 64 × 48 s’y est compressé en 84 octets, et en 88 sous Windows et macOS.
png-infoaffiche maintenant la taille décompressée. - L’exemple d’API en Python du dépôt de ComfyUI attend
executingavec un nœudnull. Le serveur l’envoie après avoir écrit l’historique ; les clients s’arrêtent plutôt surexecution_success,execution_errorouexecution_interrupted. - La documentation ne liste pas les routes
/api/jobs, le préfixe/apisur chaque route, ni les messages binaires d’aperçu.
2026-09-16 — Les modèles des leçons 5 à 8
Section intitulée « 2026-09-16 — Les modèles des leçons 5 à 8 »- Le disque de la machine du cours était presque plein, donc les nouveaux fichiers de modèles sont allés sur un autre disque, déclaré à ComfyUI avec
--extra-model-paths-config. Chaque fichier a été téléchargé depuis une révision Hugging Face épinglée et vérifié avec le SHA-256 qu’indique Hugging Face, et sa licence a été lue sur la fiche du modèle à ce moment-là. - Pixel Art XL est sous CreativeML Open RAIL-M, pas sous la RAIL++-M de SDXL. Sa fiche dit qu’aucun mot déclencheur n’est nécessaire, et ses métadonnées fixent
instance_prompt: pixel art. - Les métadonnées du LCM-LoRA indiquent un rang 1 et un alpha 1, et son titre
sdxl_LCM_lora_rank1; ses tenseurs ont un rang 64 et un alpha 8. - L’encodeur de texte Qwen3 4B a le même SHA-256 dans les dépôts Z-Image-Turbo et FLUX.2 klein de Comfy-Org.
2026-09-16 — Img2img, inpainting, ControlNet et LoRA
Section intitulée « 2026-09-16 — Img2img, inpainting, ControlNet et LoRA »denoisen’a pas changé le nombre d’étapes : 25 étapes se sont exécutées pour chaque valeur de 0,3 à 0,9, en 4,6 à 5,1 secondes.- Envoyer des octets identiques sous un nom déjà pris a renvoyé le nom existant ; des octets différents ont reçu
name (1).png. Aucun des deux comportements n’est documenté. VAEEncodeForInpaintgrise les pixels masqués, ce que le tutoriel ne dit pas. Avecdenoiseà 0,5, le résultat était une ellipse grise uniforme.
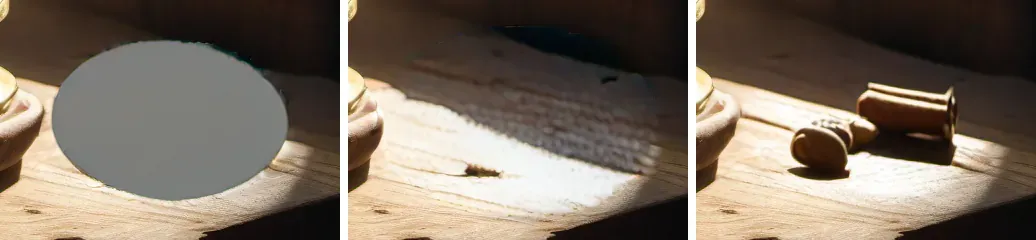
Deux échecs d’inpainting et la correction, avant de recoller le résultat. ComfyUI v0.36.0 : Stable Diffusion XL base 1.0, graine 42, 25 étapes, CFG 7, euler, normal. De gauche à droite : 05-inpaint-vaeencode.api.json avec denoise 0,5 ; le même workflow avec denoise 1 et un masque au bord adouci sur 24 pixels ; 05-inpaint-model.api.json, le UNet SD-XL inpainting 0.1 avec denoise 0,99, sur le même masque adouci.
- La fiche de SD-XL inpainting dit de garder
strengthsous 1,0 ; 1,0 et 0,99 ont donné ici presque la même image (0,01 % des pixels diffèrent de plus de 8). - Le résultat d’inpainting décodé a changé de plus de 8 niveaux 6,2 % des pixels hors du masque ; le recoller avec
ImageCompositeMaskedles a laissés identiques. - La page de documentation de
SetUnionControlNetTypeliste 13 types ; le nœud en a 8. - La première exécution en CI du nœud
Cannya échoué sous les trois systèmes : quatre machines ont donné quatre hachages de pixels. Les trois runners ont trouvé 467 pixels de contour, la machine de l’auteur 464. La CI les affiche maintenant à titre d’information.
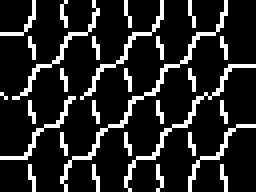
La sortie du nœud Canny sur la machine de l’auteur, hachage de pixels 77af5cb1b7e93a5c, 464 pixels de contour, agrandie quatre fois sans lissage. ComfyUI v0.36.0 sur le CPU, sans modèle, seuils 0,05 et 0,15, workflow 05-masks.api.json. Les trois runners de la CI ont chacun dessiné 467 pixels de contour, avec trois autres hachages.
- Avec
end_percentà 0,3, le ControlNet a guidé 8 étapes sur 25, et l’image était presque la même qu’avec lui actif à chaque étape. - Un LoRA coûte du temps avant la première étape, pas pendant l’échantillonnage : changer de LoRA a pris 4 à 5 secondes de plus, et une image en 4 étapes avec le LCM-LoRA a ensuite pris 1,16 seconde.
2026-09-16 — Modèles récents et quantification
Section intitulée « 2026-09-16 — Modèles récents et quantification »- Z-Image-Turbo en bf16 avec son encodeur de texte bf16, soit 19,4 Go de poids, a tourné sur le GPU de 16 Go grâce à la VRAM dynamique : 63,93 secondes pour le premier rendu, puis 5,93 secondes à 1,5 étape par seconde. int8 avec l’encodeur de texte fp8 a tourné à 3,1 étapes par seconde, nvfp4 de 3,7 à 4,1.
nvidia-smia montré de 12,5 à 15,3 Go en usage pour chaque configuration : la VRAM dynamique utilise ce qui est libre. Les tailles préparées dans le log sont les chiffres utiles.- Les images int8 sont restées proches de celles en bf16 (9 à 15 % des pixels diffèrent de plus de 8) ; les images nvfp4 montraient la même scène disposée autrement (62 à 74 %).
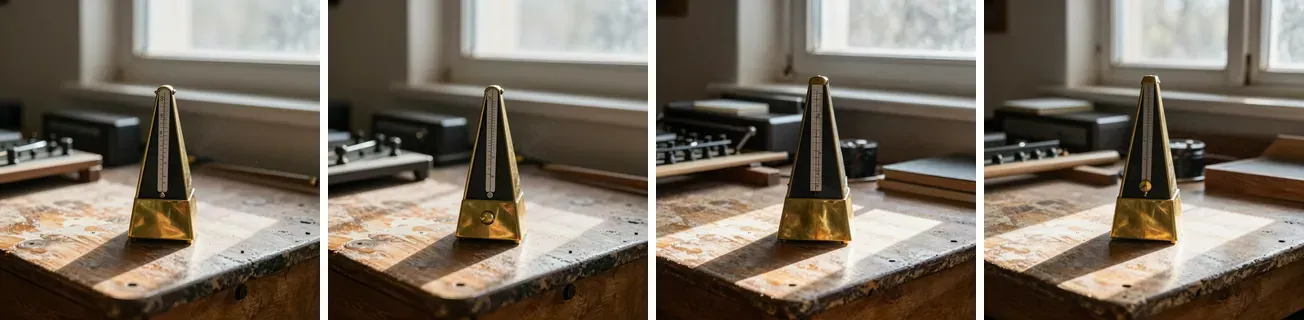
ComfyUI v0.36.0 : Z-Image-Turbo, graine 42, 8 étapes, CFG 1, res_multistep, simple, workflow 08-z-image-turbo.api.json. De gauche à droite : bf16 avec l’encodeur de texte bf16, int8 avec fp8, nvfp4 avec fp4, nvfp4 avec bf16.
qwen_3_4b_fp8_mixeda 12 couches nvfp4, etqwen_3_4b_fp4_mixeda 58 couches fp8. Le fichier Z-Image nvfp4 garde ses quatre blocs de raffinement en bf16.- Avec
--disable-dynamic-vram, le premier rendu bf16 a pris 78,87 secondes et a donné les mêmes pixels qu’avec la VRAM dynamique. Le deuxième rendu a été arrêté quand la machine, partagée avec d’autres travaux, a manqué de RAM. Un lot bf16 antérieur avait été arrêté de la même façon : le serveur occupait 14,5 Go de RAM. Chaque serveur ne démarre maintenant que si les poids de la configuration, plus une marge, tiennent dans la RAM libre. - FLUX.2 klein 4B a dessiné un support en laiton, pas un métronome, avec les graines 42, 43 et 44 ; Z-Image-Turbo a dessiné un métronome à chaque fois.
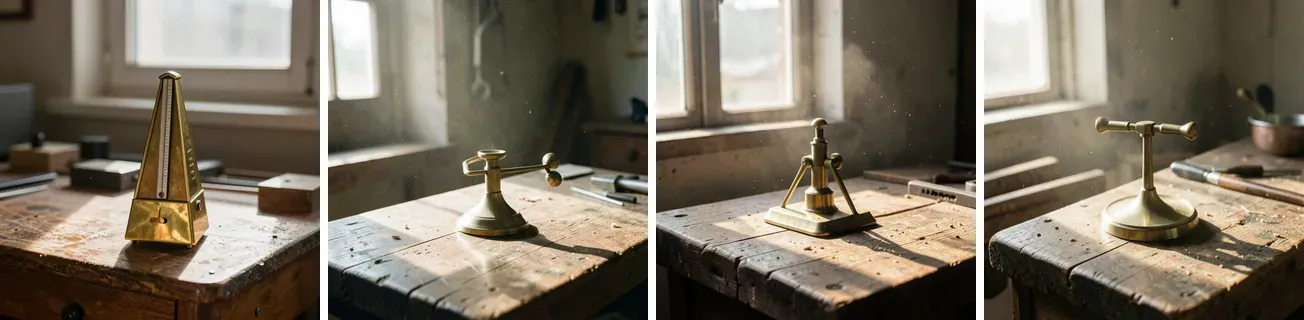
ComfyUI v0.36.0. D’abord : Z-Image-Turbo bf16, graine 43, workflow 08-z-image-turbo.api.json. Ensuite : FLUX.2 klein 4B, graines 42, 43 et 44, 4 étapes, CFG 1, euler, workflow 08-flux2-klein.api.json.
2026-09-16 — Les nœuds personnalisés et leur sécurité
Section intitulée « 2026-09-16 — Les nœuds personnalisés et leur sécurité »- ComfyUI v0.36.0 importe chaque pack avec
exec_moduleavant de lireNODE_CLASS_MAPPINGS;prestartup_script.pys’exécute plus tôt, et le JavaScript deWEB_DIRECTORYs’exécute dans le navigateur.hook_breaker_ac10a0.pyrestaure une fonction après le chargement des packs ; rien d’autre ne sépare un pack du processus. - ComfyUI-Manager est maintenant le paquet pip
comfyui_manager==4.2.2, épinglé dansmanager_requirements.txt. Les 42 fichiers.py,.jsonet.mdde sa wheel sur PyPI sont identiques au tag4.2.2, commitbd4ede22. Il filtre les installations selon le niveau de sécurité, l’adresse d’écoute et deux nouveaux drapeaux, et cherche au démarrage des noms de paquets malveillants connus ; rien ne lit le code d’un pack. - Le pack Guitar Alchemist (GA Chord Diagram, GA Fretboard Control Map, GA Scale Prompt) calcule à partir des tables d’accordage et de gammes de GA au commit
a826864f, dessine avec Pillow sans police, et passe 14 tests unitaires avec seulement NumPy et Pillow. Chargé dans un répertoire de base jetable, avec le Python de la version portable, sur le CPU, il s’est importé en 0,0 s, a tourné en 0,06 s, etSaveImagea écrit les mêmes pixels que le PNG attendu du test.--disable-all-custom-nodes,--whitelist-custom-nodes gaet un dossier.disabledse sont comportés comme le dit le code source. - Le script d’audit a tourné sur six packs épinglés le 16 septembre 2026 : ComfyUI-GGUF, comfyui_controlnet_aux, ComfyUI-Impact-Pack, ComfyUI-VideoHelperSuite, rgthree-comfy et ComfyUI_essentials. Aucun constat ne suggère une intention malveillante. Impact-Pack installe
onnxruntimeavec pip la première fois qu’un détecteur ONNX tourne, et soninstall.pytélécharge un.pthde SAM. rgthree-comfy envoie le SHA-256 d’un fichier de modèle à Civitai quand l’interface demande ses informations. comfyui_controlnet_aux contient 72 appels àtorch.loadsansweights_only, sûrs par défaut seulement avec PyTorch 2.6 ou plus récent. - Un pickle dont la charge appelle
prints’est exécuté avecpickle.loadset avectorch.load(weights_only=False);torch.load(weights_only=True)l’a refusé avec PyTorch 2.13.
2026-09-16 — ComfyUI en production
Section intitulée « 2026-09-16 — ComfyUI en production »- Lu dans ComfyUI v0.36.0 : un seul thread
prompt_workerexécute un prompt à la fois ; un client peut choisir unprompt_id, qui doit être un UUID en minuscules ; le même identifiant envoyé deux fois s’exécute deux fois et écrase son entrée d’historique ;execution_successest envoyé avant l’écriture de l’historique ;execution_interruptedest diffusé à tous ; une reconnexion ne rejoue rien. Un script d’enregistrement a provoqué ces cas sur un serveur CPU et sauvegardé les réponses. - Un worker en C# et en Java avec les mêmes lignes de log : une file en mémoire (un
Channelen C#, uneLinkedBlockingQueueet des threads virtuels en Java) ou RabbitMQ, l’identifiant du job commeprompt_id, un fichier de réservation etdone.jsonpour l’idempotence, un backoff exponentiel avec full jitter, les 400 et les erreurs d’exécution ordinaires aux lettres mortes, les manques de mémoire et les 5xx retentés, une interruption à l’expiration du délai, un pool de GPU qui choisit le serveur avec le moins de prompts devant, et la gestion de SIGTERM avec un délai de grâce. - Un faux ComfyUI en ASP.NET Core rejoue les réponses enregistrées selon un script de pannes. 11 tests xUnit et 9 tests JUnit passent, et les deux workers affichent les mêmes transcriptions sous Windows, Linux et macOS en CI. Contre un vrai ComfyUI sur CPU, le worker C# a exécuté quatre jobs (un doublon, une lettre morte), et le worker Java, sur le même serveur, a retrouvé les prompts terminés dans l’historique sans les exécuter à nouveau.
- La première exécution de la CI s’est bloquée sous Linux et macOS : les faux serveurs survivaient à
kill. Ils attendent maintenant SIGTERM avecPosixSignalRegistration. - L’expérience « accord vers manche » du labo GA tourne en vingt jobs avec un CSV de résultats contre le faux serveur. Les adaptateurs RabbitMQ, les notes de déploiement et une exécution sur GPU restent à vérifier.
2026-09-16 — Les modèles des leçons 9 et 10
Section intitulée « 2026-09-16 — Les modèles des leçons 9 et 10 »- Téléchargés sur le disque des modèles et vérifiés avec le SHA-256 de l’API d’arborescence de Hugging Face :
RealESRGAN_x4plus.safetensors(66 857 836 octets, BSD-3-Clause),film_net_fp16.safetensors(68 882 302 octets), et pour Wan 2.2 TI2V 5B, sous Apache 2.0,wan2.2_ti2v_5B_fp16.safetensors(9 999 658 848 octets),umt5_xxl_fp8_e4m3fn_scaled.safetensors(6 735 906 897 octets) etwan2.2_vae.safetensors(1 409 400 960 octets). Les 18,1 Go de Wan ont pris 10 minutes. - Le reconditionnement de Comfy-Org n’a pas de fichier fp8 de TI2V 5B, seulement fp16.
2026-09-16 — Agrandissement, textures raccordables et HDR
Section intitulée « 2026-09-16 — Agrandissement, textures raccordables et HDR »- La règle de RAM a choisi le modèle à chaque démarrage du serveur : Z-Image-Turbo nvfp4 avec 22 Go de RAM libre, int8 avec 24 Go. La RAM libre est descendue à 9 Go pendant les rendus int8.
- Une étape d’échantillonnage a pris environ 0,3 seconde en 1024 × 1024 et de 2,2 à 2,8 secondes en 2048 × 2048.
- Un
VAEDecodesimple du latent 2048 × 2048 a tenu sur le GPU ; son image diffère de celle deVAEDecodeTiledde 0,93 niveau en moyenne. - L’agrandissement dans l’espace latent a laissé un grain bruité et des cordes dédoublées à un denoise de 0,3.
- Le PNG 16 bits de
SaveImageAdvancedtiré d’un rendu 8 bits a 256 niveaux par canal, et son EXR n’a aucune valeur au-dessus de 1,0. Le client C# s’arrêtait au premier PNG 16 bits : il les décode maintenant, et liste les fichiers EXR et AVIF par taille. - Le premier essai de texture raccordable, avec une croix de 160 pixels, 64 pixels de fondu et un denoise de 0,7, a divisé les raccords par deux (de 13,4 à 5,2 niveaux sur la ligne du milieu) mais a laissé une ligne mouchetée et une marche de ton. Un denoise de 0,9 n’a pas aidé ; une croix de 384 pixels avec 128 pixels de fondu, si.
- « Pale maple » (érable pâle) a dessiné des feuilles d’érable sculptées dans le bois. « Pale maple wood, a planed board » (bois d’érable pâle, une planche rabotée) a dessiné une planche.
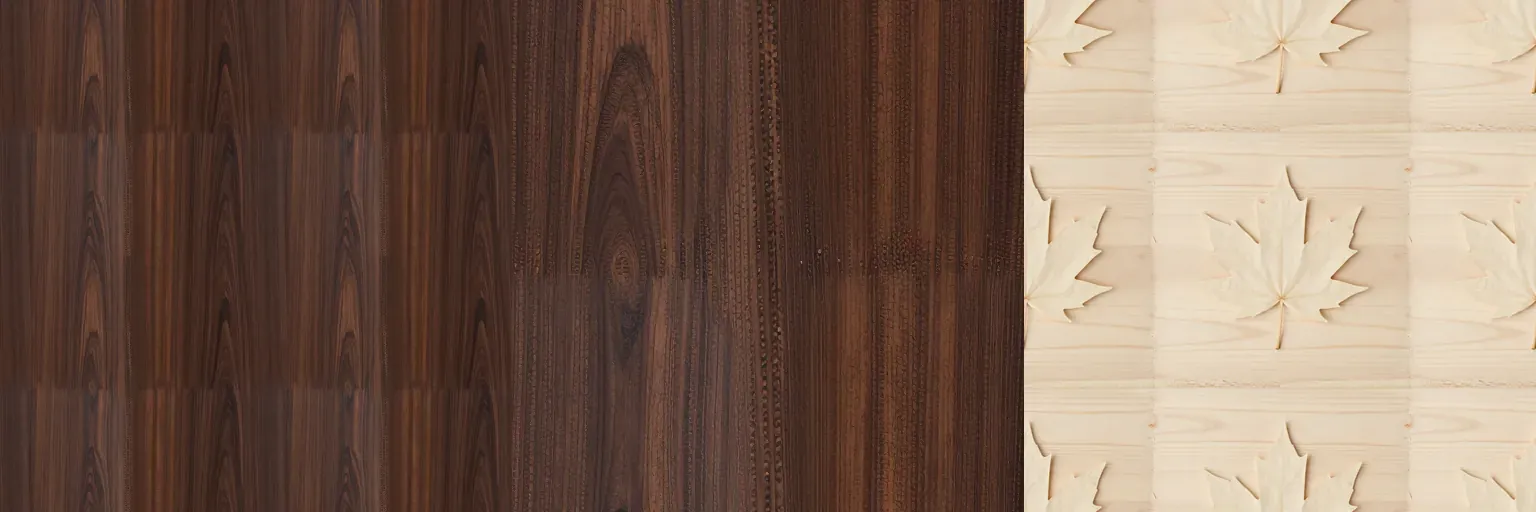
Les échecs, avant la correction. ComfyUI v0.36.0 : Z-Image-Turbo nvfp4 avec Qwen3 4B fp4 mixed, graine 42, 8 étapes, CFG 1, res_multistep, simple, workflow 09-seamless.api.json avec sa croix réglée à 160 pixels, 64 de fondu et un denoise de 0,7. De gauche à droite : le palissandre répété 2 × 2 ; les 512 × 512 pixels du milieu du palissandre ; le prompt « flat top-down photograph of pale maple, subtle straight grain, even soft lighting, no shadows, wood texture » (photo à plat, vue de dessus, d’érable pâle au fil fin et droit, sous un éclairage doux et uniforme, sans ombres, texture de bois), répété 2 × 2.
2026-09-17 — Un modèle 3D publié avant d’avoir lu sa licence
Section intitulée « 2026-09-17 — Un modèle 3D publié avant d’avoir lu sa licence »- Le 16 septembre, la session Atlas a généré un métronome et un gramophone sous forme de maillages 3D, à partir d’images SDXL, avec Hunyuan3D 2.0 et les nœuds du cœur de ComfyUI. Le journal du cours Blender a publié leurs rendus à 00 h 23 le 17 septembre, dans le commit
a165915. - En lisant la licence pour l’expérience image vers 3D du labo GA, la session learn-33 a trouvé la clause 5.c de la Tencent Hunyuan 3D 2.0 Community License : « You must not use, reproduce, modify, distribute, or display the Tencent Hunyuan 3D 2.0 Works, Output or results of the Tencent Hunyuan 3D 2.0 Works outside the Territory. Any such use outside the Territory is unlicensed and unauthorized under this Agreement. » Le Territoire exclut l’Union européenne, le Royaume-Uni et la Corée du Sud, et ce site est public. Notre erreur : les rendus ont été publiés avant que quiconque ait lu la clause 5.c.
- À 00 h 44, l’utilisateur a décidé : Hunyuan3D reste sur la machine locale, et tout ce qui est publié utilise TRELLIS.2 (MIT, avec DINOv3 sous sa propre licence) ou des modèles construits par du code. Le cours Blender a retiré les deux rendus dans le commit
c8a5a33et décrit avec des mots ce qu’ils montraient. - TRELLIS.2 demande ici environ 23 Go de RAM libre, et l’amont demande 24 Go de VRAM ; il n’a pas tourné. Les deux objets sont remodélisés avec
bpyà la place : le journal Blender raconte ce côté de l’histoire, avant et après. - La leçon 8 contient maintenant une section sur la lecture d’une licence avant de publier une sortie, avec les clauses et la comparaison des trois routes. Aucune image de Hunyuan3D ne paraît dans ce cours.
2026-09-19 — Vérification ComfyUI pour la scène orbitale
Section intitulée « 2026-09-19 — Vérification ComfyUI pour la scène orbitale »Un serveur CPU séparé (0.36.0, localhost:8193) a confirmé les classes de nœuds du workflow Canny du cours, le checkpoint SDXL et le ControlNet union installés. Aucun prompt soumis ; inférence GPU : 0 s. Le serveur a ensuite été arrêté. Effet inattendu : --base-directory seul a déplacé l’ancien user/comfyui.db de l’installation vers un .bak et l’a copié dans le répertoire de test. Le fichier d’origine a été restauré depuis cette sauvegarde, sans écraser un autre fichier ; les deux SHA-256 sont identiques. La sauvegarde est conservée. Les prochains tests isolés devront préciser --database-url sqlite:///:memory: ou une URL de base propre au test. L’inférence et la qualité d’image restent à vérifier.
2026-09-19 — Prétraitement réel de Blender vers ComfyUI
Section intitulée « 2026-09-19 — Prétraitement réel de Blender vers ComfyUI »Le rendu Blender v2 a été copié dans le répertoire d’entrée ComfyUI isolé. LoadImage → Canny → SaveImage a réussi sur CPU en 3.731 s (horodatages de l’historique) ; l’image a été inspectée. Les contours des anneaux, piliers et de l’allée restent visibles. C’est une image de contrôle, pas une scène générée par SDXL ni une nouvelle géométrie 3D. Identifiant : 7f26de5e-5d83-455c-97be-1e3401e9ba5f. Sortie : C:/tmp/blender-comfy-scenes-20260919/comfy-base/output/orbital-study/canny-edges_00001_.png. La base explicitement en mémoire a empêché la migration précédente ; le hash de la base de l’installation est inchangé. Temps GPU et appels API payants : 0. L’inférence SDXL a été différée pour ne pas charger les deux modèles avec seulement environ 10 Gio de RAM disponibles.
2026-09-22 — Un workflow vérifié avant le GPU, et un défaut dans notre propre vérificateur
Section intitulée « 2026-09-22 — Un workflow vérifié avant le GPU, et un défaut dans notre propre vérificateur »- Les workflows de la leçon 10 étaient écrits mais jamais lancés : la machine n’a pas eu la mémoire libre pour Wan 2.2. Plutôt que d’attendre, un serveur ComfyUI a été démarré sans aucun modèle, sur le CPU, dans le seul but d’enregistrer son
/object_info: 957 classes de nœuds, 1,85 Mo. Le serveur a été arrêté aussitôt. - Comparés à ce fichier, les 26 workflows du cours sont bons.
Wan22ImageToVideoLatent,CreateVideo,SaveVideo,FrameInterpolationModelLoaderetFrameInterpolatesont dans le cœur en v0.36.0,film_net_fp16figure dans la liste du chargeur, et les noms des fichiers Wan 2.2 sont ceux que voit le serveur — les chemins de modèles supplémentaires sont donc justes. La leçon 10 peut partir dès que la mémoire est là. - La vérification a d’abord annoncé que
SaveVideon’avait pas d’entréeformat.codec, sur les trois workflows. Elle avait tort, et le défaut était le nôtre :Workflow.csne lisait que les entréesrequiredetoptionalde premier niveau, alors qu’unCOMFY_DYNAMICCOMBO_V3porte ses enfants dans ses options. Il les parcourt maintenant, et contrôle aussi les clés d’options. La leçon 3 a la section, etcheck.shun jeu d’essai avec les trois fautes possibles sur une entrée à point. - Un vérificateur qui n’a jamais échoué ne prouve rien. Celui-ci a désormais un fichier qui doit échouer, et les quatre nouvelles lignes d’
expected/03-validate.txtsont ce qu’il doit imprimer. - Le même jour, chaque leçon écrite a reçu une section « à toi de jouer » — la 9 était la seule à finir par quelque chose à faire sur sa propre machine — et les trente images du cours ont été rassemblées dans une galerie, chacune avec le workflow qui l’a faite, à la révision qui l’a faite.
2026-09-22 — Où Canny cesse de coïncider, et ce que convrot fait tourner
Section intitulée « 2026-09-22 — Où Canny cesse de coïncider, et ce que convrot fait tourner »- La question ouverte de la leçon 6 a sa réponse.
data/canny-steps.pycalcule une empreinte par étape du filtre de Kornia sur un motif de 64 sur 48 construit en arithmétique entière, etcheck.shl’exécute sur les trois machines de CI. L’entrée fait les mêmes octets partout. Le flou gaussien sépare déjà la machine de l’auteur des runners, et le runner Apple Silicon des deux x86 ; le gradient spatial diffère sur les quatre, alors que Windows et Linux coïncidaient une étape plus tôt — la même convolution emprunte un chemin différent selon la compilation. Toutes les magnitudes diffèrent, et leur somme affiche toujours 2729.489258. - Les contours, eux, sont identiques sur les quatre machines : 1 461 pixels sur 3 072, une seule empreinte. Ce motif n’est fait que d’aplats et de bords francs, donc rien ne passe près d’un seuil. C’est l’autre moitié de la réponse — la divergence est toujours là, dès la première convolution ; c’est l’image qui décide si elle se voit. La leçon 6 a le tableau.
convrotétait une supposition écrite dans la leçon 8, « une rotation de groupes de poids avant la quantification ». comfy-kitchen 0.2.34 la confirme et dit laquelle : une matrice de Hadamard régulière, symétrique et orthogonale, sur des groupes de 256 canaux d’entrée — le poids hors ligne, les activations en ligne, fusionné dans le quantificateur par ligne. Étant sa propre inverse, elle laisse le produit intact et ne change que ce que l’int8 doit contenir.data/convrot.pyla reconstruit, identique à celle de la bibliothèque pour les tailles 16, 64 et 256, et mesure l’erreur d’aller-retour sur un poids ayant une valeur aberrante par ligne : 5,7 % sans rotation, 0,76 % avec.- Le point EXR de la leçon 9 a gagné la conséquence qui compte pour le partage : un workflow construit là où
.exra un type MIME désigne une image que la liste de la machine suivante ne proposera pas. Le fichier reste valide ; le rendu cesse d’être reproductible.
2026-09-22 — Quatre constats qui n’avaient jamais quitté le rapport, et un qui a expiré
Section intitulée « 2026-09-22 — Quatre constats qui n’avaient jamais quitté le rapport, et un qui a expiré »Cinq constats des premiers jours ne vivaient que dans le rapport de voie, jamais dans ce journal, donc ils ne pouvaient pas devenir des lignes de tableau. Chacun a été revérifié aujourd’hui avant d’être écrit. Quatre tiennent ; un non.
QUANTIZATION.mddésigne les mauvaises lignes, et la mauvaise forme. Il dit « TheMixedPrecisionOpsclass (lines 542-648 incomfy/ops.py) ». Au commit épinglé, la classe est déclarée ligne 1347, la ligne 542 estself.weight_comfy_model_dtype = dtype, etMixedPrecisionOpsn’est pas du tout une classe de module : elle est définie à l’intérieur de la fabriquemixed_precision_ops(), ligne 1346, et ne peut donc pas être importée sous ce nom.- La page du format API se trompe sur les clés de nœuds du format UI. Son tableau comparatif donne « Node keys : Node titles or labels » pour le format d’enregistrement, contre « Numeric node IDs » pour le format API. Le fichier exporté du cours dit l’inverse :
01-txt2img.ui.jsoncontientnodessous forme de liste de 7 objets, chacun avec unidnumérique, aucun ne portant detitle, et chaque entrée delinksrenvoie à ces nombres. Les deux formats identifient les nœuds par id ; ce qui diffère, c’est que l’un est un tableau et l’autre un objet indexé par l’id. --lowvramne change rien par rapport à l’état normal. Le drapeau metVRAMState.LOW_VRAM, mais le budget de chargement partiel prend la même branche pourLOW_VRAMet pourNORMAL_VRAM, et calcule le même montant à partir de la mémoire libre dans les deux cas. Les rendus du 16 septembre n’ont mesuré aucune différence ; le code dit pourquoi.--novramest autre chose : il fixe le budget à 0,1.- comfy-cli envoie les commandes vers Comfy Cloud dès qu’un identifiant existe. Son propre
where.pyexpose l’ordre de priorité, et la dernière règle est une détection automatique : cloud si un identifiant cloud est configuré, clé d’API ou session OAuth active, sinon local. Se connecter une fois change la destination des commandes suivantes, sans que la ligne de commande le dise. Lu aujourd’hui surmain; comfy-cli n’est pas épinglé par ce cours. - Celui qui a expiré. Une note du 16 septembre disait que la page d’installation portable n’annonce que NVIDIA ou CPU, alors que la v0.36.0 publie des builds AMD et Intel. La version publie bien quatre archives Windows — amd, intel, nvidia et nvidia_cu126 — mais la page lue aujourd’hui documente les trois fabricants, avec un fichier de commandes chacun. Quoi qu’elle ait dit alors, elle ne le dit plus, et aucune capture ne prouve l’état antérieur. La note est retirée plutôt que publiée : un reproche fait à une documentation, sans preuve du texte reproché, n’est pas un constat.
À vérifier
Section intitulée « À vérifier »- SDXL sous Linux avec CUDA, et sur Apple Silicon avec MPS : la machine GPU du cours tourne sous Windows ; la CI n’installe que les versions CPU.
- Quelle opération fait donner aux encodeurs de texte des résultats différents selon que l’UNet est chargé ou non, et si cela arrive avec d’autres GPU ou d’autres pilotes.
- Si un sampler ancestral donne la même image sur le CPU et sur le GPU pour une graine : son bruit d’étape est tiré sur le périphérique.
- Si un hachage perceptuel serait stable dans les cas de la leçon 2.
- Les chaînes de ControlNet,
start_percent, et l’étape exacte où tombe le niveau de bruit d’un pourcentage, que la leçon a calculée mais pas rendue. - Entraîner un LoRA avec les nœuds expérimentaux de ComfyUI, et quelle part des 16 Go cela prend pour SDXL.
- Des LoRA empilés dans l’autre ordre : même image, et même hachage de pixels ou non.
- Le chemin émulé pour nvfp4 et fp8 sur un GPU sans leurs noyaux ; la machine du cours n’a qu’un GPU de la série RTX 50.
- Pourquoi le réseau Z-Image nvfp4 échantillonnait plus vite avec l’encodeur de texte bf16 qu’avec celui en fp4.
- Échantillonner les tuiles de
SplitImageToTileListet les fusionner avecImageMergeTileList: si des raccords se voient à un denoise faible. - Si l’
EXRLoaderde three.js lit dans un navigateur l’EXR non compressé de ComfyUI. - Comment les navigateurs affichent l’AVIF HLG de
SaveImageAdvanced. - Les temps de rendu à chaud avec
--disable-dynamic-vram, sur une machine avec assez de RAM libre. execution_interruptedtel que les clients l’affichent, etPOST /interruptavec un identifiant de prompt : il faut une exécution assez longue à interrompre, donc un modèle.
Questions ouvertes
Section intitulée « Questions ouvertes »Pas des mesures en attente — elles sont au-dessus — mais des décisions que ce cours n’a pas prises.
- La dépendance de
LoadImageà la table MIME de la machine mérite-t-elle une issue sur ComfyUI, ou est-ce le comportement voulu ? Un appel àmimetypes.add_typepour les formats que ComfyUI écrit lui-même corrigerait cela en une ligne, et changerait ce qu’une installation existante liste. - Qu’est-ce qui, dans deux compilations x86 de la même version de PyTorch, fait différer leurs convolutions — la vectorisation, le parallélisme ou la bibliothèque d’algèbre linéaire ? La sonde par étapes montre *qu’*elles diffèrent dès la première, pas pourquoi.
- Quand déplacer l’épinglage ? Toutes les mesures d’ici sont attachées à ComfyUI v0.36.0 à un commit précis, et c’est ce qui leur donne un sens ; rien ne dit ce qu’elles deviennent en v0.37.