14. Laboratorio: Guitar Alchemist en 3D, quince experimentos medidos
Secciones
Ajustes de lectura
Ninguna voz para este idioma en este navegador.
Más voces
Código y términos técnicos en inglés
Desactivado: la voz de la página lo lee todo, sin pausa entre dos voces.
Ninguna voz para este idioma en este navegador.
Más voces
Más voces: Microsoft Edge ofrece voces naturales en línea, y Windows (Configuración › Hora e idioma › Voz), macOS y Android instalan otras.
Código: code/threejs/ga-lab: una página por experimento, el ejecutor scripts/run.mjs, el código de medición compartido src/lab.ts, las hipótesis confirmadas en experiments/ y todas las medidas en results/.
Objetivo
Sección titulada «Objetivo»Las lecciones 1 a 13 enseñaron three.js y portaron el mástil de GuitarAlchemist. Esta lección plantea las preguntas con las que se encontrará a continuación el código 3D de GA, y las responde midiendo en lugar de con reglas empíricas: cómo dibujar muchos mástiles, cómo animar cuerdas, cómo seleccionar entre 10 000 notas, cómo mostrar 313 047 voicings, cuánto cuestan las texturas, las sombras y el bloom, cómo tratan un motor de física y un casco una guitarra a tamaño real, y qué ocurre en una GPU débil.
Todos los experimentos siguen el mismo protocolo. Su archivo JSON en experiments/ contiene una pregunta, una hipótesis y predicciones numéricas, escritas y confirmadas en un commit el 16 de septiembre de 2026, antes de la ejecución medida. La ejecución escribió results/<experiment>/results.json el 17 de septiembre. Los veredictos de abajo comparan ambos, y las predicciones que fallaron se quedan en las tablas: son la mayor parte de lo que enseñó este laboratorio.
Cómo se hicieron las medidas
Sección titulada «Cómo se hicieron las medidas»Máquina. Windows 11 Pro 10.0.26200, Intel Core Ultra 9 285K, 64 GB, una GPU activada, una NVIDIA GeForce RTX 5080 (driver 610.88), Chromium 153.0.8010.12 de Playwright 1.63.0, Node.js 24.12, three.js r186. Cada results.json repite estos datos.
Fotogramas. Una página no usa requestAnimationFrame: renderiza fotograma tras fotograma en un bucle, con Chromium iniciado con --disable-gpu-vsync y --disable-frame-rate-limit, de modo que la pantalla nunca marca su ritmo. Cada página renderiza a un tamaño fijo, y WebGPU y WebGL 2 se comparan al mismo tamaño. Tras 30 fotogramas de calentamiento, se miden 240 fotogramas (menos donde se indica), y las tablas dan medianas:
- CPU ms: la función de fotograma de la página, que incluye la grabación y el envío de los comandos por
renderer.render(); - GPU ms: la duración de las pasadas de render y de cómputo del fotograma según las timestamp queries (la característica
timestamp-queryde WebGPU, oEXT_disjoint_timer_query_webgl2en WebGL 2); - wall ms: el tiempo de CPU más la espera hasta que la cola de la GPU termina (
GPUQueue.onSubmittedWorkDone()en WebGPU, unreadPixels()de 1 píxel en WebGL 2).
En WebGPU el tiempo wall nunca bajó de unos 3.5 ms, fuera cual fuera la escena: es el retardo de onSubmittedWorkDone() en este Chromium, no trabajo de la GPU. La columna GPU es la que hay que leer para el coste en GPU, y el tiempo wall solo cuando sube por encima de ese suelo.
Contadores. renderer.info se reinicia en cada fotograma, no en cada render(), así que los contadores de un fotograma suman todas sus pasadas. WebGPURenderer cuenta su pasada de salida (el tone mapping hacia el canvas) como un draw call: una escena de una malla informa de 2.
Ejecutarlo. Desde code/threejs, tras npm ci y npx playwright install chromium chromium-headless-shell:
node ga-lab/scripts/optick-project.ts # la proyección de OPTIC-K (--synthetic 20000 sin el índice de GA)node ga-lab/scripts/wood-texture.ts # el PNG de madera; ga-lab/scripts/wood-ktx2.sh lo comprime con KTX-Softwarenode ga-lab/scripts/guitar-body.ts # el cuerpo glTF y sus niveles de detallenode ga-lab/scripts/run.mjs 01-neck # un experimento, o todosnode ga-lab/scripts/run.mjs 01-neck --run merged-16npx vite --config ga-lab/vite.config.ts # las páginas, en http://localhost:5288/01-neck.html?strategy=merged&necks=16Los comandos son los mismos en Windows (Git Bash), Linux y macOS; wood-ktx2.sh necesita Bash y la herramienta ktx de KTX-Software 4.4.2. Los números medidos pertenecen a esta máquina: los tuyos serán distintos, las proporciones menos.
CI. threejs-ga-lab.yml ejecuta ga-lab/check.sh en Ubuntu, Windows y macOS: la comprobación de tipos, las pruebas unitarias, los scripts de datos, las ejecuciones cortas ci de cada experimento en WebGL 2, cuyos contadores de renderer.info y comprobaciones se comparan con expected/, y el build. No compara ningún tiempo: los runners no tienen GPU.
1. El mástil de cuatro maneras
Sección titulada «1. El mástil de cuatro maneras»Hipótesis. Los draw calls determinan el tiempo de CPU de un fotograma; el tiempo de GPU apenas se mueve, ya que todas las estrategias dibujan más o menos los mismos triángulos.
Montaje. 01-neck dibuja el mástil con el acorde de do mayor, a 1200 × 400 píxeles CSS con un pixel ratio de 1, de cuatro maneras: ga, la reproducción de la estructura de GA de la lección 13 (una malla por traste, incrustación, cuerda, etiqueta y marcador); instanced, el port de la lección 13 (un InstancedMesh por tipo); batched, un único BatchedMesh; merged, todas las partes estáticas fusionadas en una geometría con colores por vértice, y los marcadores con instancing. Para 16 mástiles, ga e instanced montan 16 copias.
| Estrategia | Draw calls, 1 mástil | CPU ms, 1 mástil | Draw calls, 16 mástiles | CPU ms, 16 mástiles | GPU ms, 16 mástiles |
|---|---|---|---|---|---|
| ga | 72 | 0.715 | 1 137 | 2.910 | 0.134 |
| instanced | 7 | 0.405 | 97 | 1.155 | 0.026 |
| batched | 44 | 0.385 | 689 | 0.415 | 0.023 |
| merged | 4 | 0.315 | 19 | 0.360 | 0.025 |
Pixel ratio 3 de GA frente a 1, un mástil: 0.040 frente a 0.017 GPU ms. En WebGL 2, el mismo mástil ga tardó 0.590 CPU ms y 1.435 wall ms.
| Predicción | Medido | Veredicto |
|---|---|---|
| Draw calls ga 72, instanced 7, batched y merged 4 o menos | 72, 7, 44, 4 | batched incorrecta |
| CPU, ga al menos 3x merged; todas por debajo de 2 ms | 2.3x; todas por debajo de 1 ms | incorrecta, segunda parte correcta |
| CPU, 16 mástiles: ga al menos 10 ms; batched y merged por debajo de 1.5 ms | 2.9 ms; 0.42 y 0.36 ms | incorrecta, segunda parte correcta |
| GPU, 16 mástiles: las cuatro dentro de un 30 % | ga 5x las demás | incorrecta |
| Pixel ratio 3 frente a 1: GPU al menos 4x | 2.4x | incorrecta |
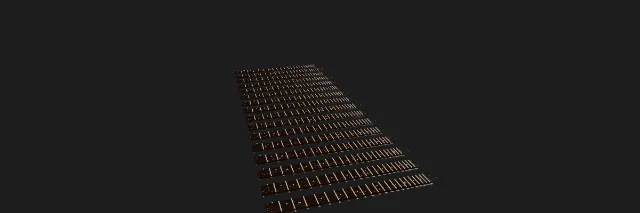
Qué significa para GA. La RTX 5080 es demasiado rápida para que un solo mástil muestre un coste: los 72 draw calls de GA toman 0.7 ms de CPU. Lo que crece es el número de objetos: 16 mástiles con la estructura de GA toman 8 veces la CPU de los mástiles fusionados, y 5 veces el tiempo de GPU, ya que cada draw call tiene también un coste fijo en la GPU. BatchedMesh en WebGPU dibujó un draw call por objeto (44), donde WebGL 2 con la extensión WEBGL_multi_draw dibujó 3 en CI: en el backend WebGPU de r186 ahorra trabajo de CPU, no draw calls. Y el port de la lección 13, con instancing por mástil, crea sus materiales por mástil: 97 draw calls y 73 programas para 16 mástiles, donde la fusión se queda en 19 y 8. Una pantalla con varios mástiles debería compartir los materiales entre instancias de Fretboard3D o fusionar las partes estáticas.
2. Una cuerda que vibra de tres maneras
Sección titulada «2. Una cuerda que vibra de tres maneras»Hipótesis. Con 6 cuerdas, los vértices en CPU, TSL y los morph targets son indistinguibles; con 600, reescribir vértices cuesta tiempo de CPU y una subida en cada fotograma, mientras que TSL y los morph targets no cuestan casi nada en la CPU.
Montaje. 02-string-vibration dibuja cuerdas de 429 vértices con su calibre real y las desplaza lateralmente con una fundamental amortiguada, la misma fórmula en los tres métodos: reescribiendo el atributo de posición (cpu), un positionNode en TSL (tsl, la elección de la lección 13), o un morph target con la forma de amplitud máxima y una influencia por instancia (morph). Cada fotograma es un instante fijo, para que las imágenes se puedan comparar.
| Método | CPU ms, 6 | CPU ms, 600 | GPU ms, 600 |
|---|---|---|---|
| cpu | 0.405 | 1.800 | 0.030 |
| tsl | 0.355 | 0.360 | 0.051 |
| morph | 0.375 | 0.465 | 0.035 |
| Predicción | Medido | Veredicto |
|---|---|---|
| 6 cuerdas: las tres dentro de 0.3 ms | dentro de 0.05 ms | correcta |
| 600 cuerdas: cpu al menos 5x tsl; morph dentro de 2x tsl | 5.0x; 1.3x | correcta |
| 600 cuerdas: GPU dentro de un 30 % | tsl 1.7x cpu | incorrecta |
| Píxeles que difieren entre cpu y tsl, 6 cuerdas: menos del 0.5 % | 0 píxeles (morph frente a tsl: 0; 600 cuerdas: 0 y 1) | correcta |
Qué significa para GA. Las cuerdas en TSL de la lección 13 son la elección correcta en tiempo de CPU, y cuestan algo más de tiempo de GPU que los vértices desplazados, ya que el desplazamiento se calcula por vértice en cada fotograma en lugar de subirse: aun así 0.05 ms para 600 cuerdas. Los morph targets en un InstancedMesh necesitaron dos arreglos, detallados más abajo: en r186 su target debe marcarse morphTargetsRelative, o la malla base encoge con la influencia, y un InstancedMesh de una sola instancia falla sin morphTargetInfluences, mientras que uno de varias instancias falla con ellas.
3. Seleccionar una nota entre 10 000
Sección titulada «3. Seleccionar una nota entre 10 000»Hipótesis. Raycaster prueba cada instancia en la CPU y crece con el número de notas; una pasada de IDs en la GPU cuesta una lectura de vuelta que no crece. Con 10 000 notas la selección en GPU es más rápida.
Montaje. 03-picking dispone notas como pequeños icosaedros de 80 triángulos en un único InstancedMesh, y selecciona 200 puntos pseudoaleatorios fijos dos veces: con Raycaster.intersectObject, y renderizando una vista de 1 × 1 píxel (camera.setViewOffset) de las instancias coloreadas por instanceIndex + 1 en un render target, leído de vuelta con readRenderTargetPixelsAsync.
| Notas | Raycaster ms por selección | Pasada de IDs en GPU ms por selección | Coincidencia |
|---|---|---|---|
| 1 000 | 0.070 | 3.000 | 200/200 |
| 10 000 | 0.465 | 3.395 | 200/200 |
| 100 000 | 4.475 | 3.925 | 200/200 |
| 10 000, WebGL 2 | 0.495 | 16.925 | 200/200 |
| Predicción | Medido | Veredicto |
|---|---|---|
| Raycaster, 10 000 notas: de 3 a 8 ms | 0.465 ms | incorrecta |
| Pasada de IDs en GPU, 10 000 notas, WebGPU: de 1 a 3 ms | 3.4 ms | incorrecta, por poco |
| Coincidencia de al menos el 98 % | 100 % | correcta |
| Raycaster, 1 000 notas: menos de una cuarta parte de 10 000 | 15 % | correcta |
Qué significa para GA. Conserva Raycaster para un diapasón: incluso 10 000 notas toman medio milisegundo, siete veces menos que la lectura de vuelta de la GPU, que paga un viaje de ida y vuelta a la GPU sea cual sea el número. Los dos se cruzan hacia las 100 000 notas. En WebGL 2 la lectura de vuelta tardó 17 ms, un fotograma: allí una pasada de IDs haría esperar un fotograma a cada clic.
4. Brazaletes de clases de altura, transpuestos en la CPU o en TSL
Sección titulada «4. Brazaletes de clases de altura, transpuestos en la CPU o en TSL»Hipótesis. Transponer 4 096 brazaletes en la CPU paga 49 152 matrices y su subida en cada fotograma; en TSL sube un solo número.
Montaje. 04-bracelet dibuja cada conjunto de clases de altura como un anillo de 12 cuentas, iluminadas para sus miembros, y gira cada anillo un paso de transposición que cambia en cada fotograma: escribiendo las matrices del InstancedMesh (cpu), o con un uniform de paso en un positionNode sobre atributos por cuenta (tsl). La aritmética de conjuntos está en pcs.ts, con pruebas unitarias.
| Brazaletes | CPU ms, cpu | CPU ms, tsl | GPU ms, cpu | GPU ms, tsl |
|---|---|---|---|---|
| 352 | 0.495 | 0.335 | 0.103 | 0.102 |
| 4 096 | 2.455 | 0.290 | 1.012 | 1.024 |
| Predicción | Medido | Veredicto |
|---|---|---|
| Ruta CPU, 4 096: al menos 4 ms | 2.5 ms | incorrecta |
| Ruta TSL, 4 096: por debajo de 0.5 ms | 0.3 ms | correcta |
| GPU dentro de un 30 % | dentro de un 1 % | correcta |
| Píxeles que difieren entre las rutas: menos del 1 % | 0 píxeles, para 352 y para 4 096 | correcta |
| Clases bajo transposición, y con inversión: 352 y 224 | 352 y 224 (prueba unitaria) | correcta |
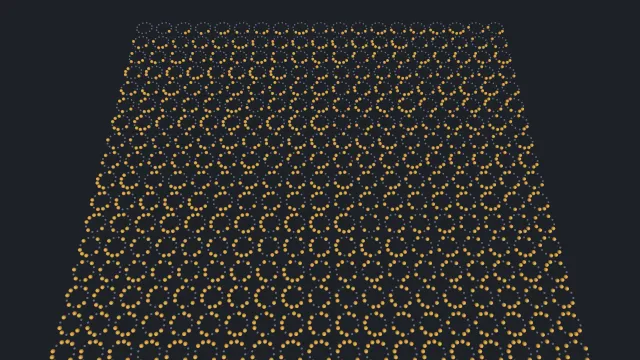
Qué significa para GA. Una animación que mueve todas las instancias de la misma manera pertenece al shader: 8 veces menos CPU para los 4 096 conjuntos. Para las 352 clases de transposición que mostraría una vista de GA, ambas rutas se quedan por debajo de medio milisegundo.
5. La nube de voicings de OPTIC-K, hasta 1 000 000 de puntos
Sección titulada «5. La nube de voicings de OPTIC-K, hasta 1 000 000 de puntos»Hipótesis. Los puntos de un píxel siguen siendo baratos hasta 1 000 000; los octaedros se quedan atrás; animar 1 000 000 de puntos en la CPU está limitado por el bucle y la subida, que un compute shader elimina.
Montaje. scripts/optick-project.ts abre el índice OPTIC-K real de GA en solo lectura, con la disposición OPTK versión 4 de OptickIndexReader.cs: 313 047 voicings (297 910 de guitarra, 7 795 de bajo, 7 342 de ukelele) de 124 dimensiones, no las 112 que suponía la pregunta del experimento. Un análisis de componentes principales de 62 610 de ellos da dos proyecciones 3D, componentes 1 a 3 (23.4 % de la varianza) y 4 a 6 (14.5 %), en 1.3 s. 05-optick-cloud las dibuja a 1280 × 720 como Points, como octaedros con instancing, y funde una proyección en la otra en cada fotograma en la CPU o en un compute shader. Más allá de 313 047 puntos repite los voicings con un pequeño desplazamiento.
| Ejecución | CPU ms | GPU ms | Wall ms |
|---|---|---|---|
| Points, 1 000 | 0.330 | 0.013 | 3.595 |
| Points, 313 000 | 0.260 | 0.067 | 3.365 |
| Points, 1 000 000 | 0.300 | 0.173 | 3.565 |
| Octaedros, 1 000 000 | 0.300 | 3.753 | 5.690 |
| Morph en CPU, 1 000 000 | 4.055 | 0.170 | 9.430 |
| Morph en compute, 1 000 000 | 0.335 | 0.511 | 3.580 |
| Morph en compute, 1 000 000, WebGL 2 | 0.280 | 2.785 | 3.490 |
| Predicción | Medido | Veredicto |
|---|---|---|
| Points, 1 000 000: GPU por debajo de 3 ms | 0.17 ms | correcta |
| Octaedros, 1 000 000: al menos 5x Points | 22x | correcta |
| Morph en CPU, 1 000 000: CPU de al menos 8 ms | 4.1 ms (wall 9.4 ms) | incorrecta |
| Morph en compute, 1 000 000: CPU por debajo de 1 ms | 0.34 ms | correcta |
| Compute no se ejecuta en WebGL 2 | se ejecuta: 2 compute calls, 2.8 GPU ms | incorrecta |
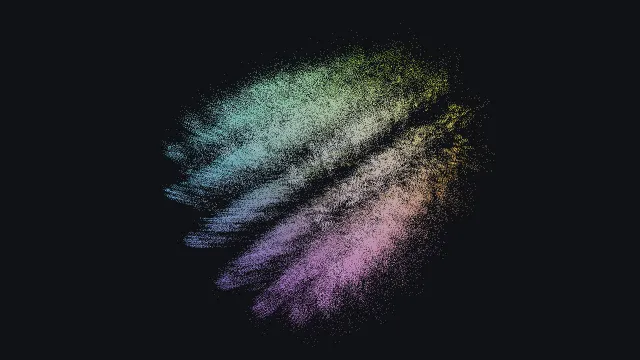
Qué significa para GA. Todos los voicings de GA caben en un draw call de puntos a 0.07 GPU ms, y un morph de 1 000 000 de puntos en un compute shader cuesta medio milisegundo. r186 ejecuta el compute de TSL también en WebGL 2, mediante transform feedback, a 5 veces el tiempo de GPU: una vista basada en compute no tiene por qué recurrir a la CPU en máquinas sin WebGPU. Las dos primeras componentes principales contienen menos de una cuarta parte de la varianza: la forma de la nube es una vista, no un mapa de distancias, y una respuesta de vecino más cercano debe venir del índice, no de la imagen.
6. Madera del diapasón: texturas, KTX2 y una madera procedural
Sección titulada «6. Madera del diapasón: texturas, KTX2 y una madera procedural»Hipótesis. Una textura RGBA8 de 2048 × 2048 con mipmaps ocupa unos 22 MB; comprimida en KTX2 (BC7 en esta GPU), una cuarta parte; una madera procedural no ocupa nada pero cuesta ruido por píxel.
Montaje. 06-wood-textures llena un fotograma de 1920 × 1080 con el diapasón, visto desde arriba, texturizado con un PNG de madera de 2048 × 2048 generado por wood-texture.ts (1 217 318 bytes), el mismo comprimido por KTX-Software 4.4.2 a UASTC con zstd (1 018 936 bytes) y a Basis LZ (145 002 bytes), una madera en TSL hecha de mx_noise_float, o un color plano. Las maderas de ComfyUI (el experimento 4 del laboratorio GA de ComfyUI) no existían cuando se ejecutó esto: esa ejecución está pendiente. La memoria de texturas es renderer.info.memory.texturesSize menos los 23.73 MB de la ejecución de color plano, que son los render targets.
| Ejecución | Texturas MB | GPU ms |
|---|---|---|
| PNG | 21.33 | 0.052 |
| KTX2 UASTC, transcodificado a BC7 (formato 36492), 12 niveles de mipmap | 0 contados | 0.050 |
| KTX2 Basis LZ, transcodificado a BC7 | 0 contados | 0.049 |
| TSL procedural | 0 | 0.116 |
| Color plano | 0 | 0.038 |
| ComfyUI | pendiente | pendiente |
| Predicción | Medido | Veredicto |
|---|---|---|
| RGBA8 con mipmaps: unos 22 MB | 21.33 MB | correcta |
| KTX2 en BC7: unos 5.6 MB | no medible: renderer.info cuenta 0 bytes para las texturas comprimidas |
no medida |
| Procedural al menos 2x el tiempo de GPU de la textura | 2.2x | correcta |
| Texturas de ComfyUI pendientes | pendiente | correcta |
Qué significa para GA. Basis LZ entrega la madera en 145 kB en lugar de 1.2 MB, y se convierte en BC7 en esta GPU, 1 byte por texel, unos 5.6 MB con mipmaps según el cálculo (por verificar con una herramienta de memoria de GPU, ya que renderer.info no la cuenta). La madera procedural cuesta 0.06 ms más por fotograma 1080p y ninguna descarga. Ambas son más baratas que el PNG en memoria.
7. Una cuadrícula PBR para cuerdas y trastes
Sección titulada «7. Una cuadrícula PBR para cuerdas y trastes»Hipótesis. Los materiales de un mismo tipo con valores distintos comparten un programa; MeshPhysicalMaterial añade programas y trabajo de sombreado.
Montaje. 07-pbr-grid dibuja 36 esferas a 1920 × 1080, con el metalness creciendo de izquierda a derecha y el roughness de arriba abajo, bajo un RoomEnvironment a través de PMREM: 36 MeshStandardMaterial, uno compartido, o 36 MeshPhysicalMaterial con el clearcoat 0.35 y el sheen 0.3 de GA.
| Ejecución | Programas | Compilación ms | GPU ms |
|---|---|---|---|
| 36 standard | 16 | 206 | 0.059 |
| 1 standard, compartido | 16 | 198 | 0.058 |
| 36 physical | 16 | 299 | 0.086 |
| Predicción | Medido | Veredicto |
|---|---|---|
| 36 materiales standard: tantos programas como 1 | 16 y 16 | correcta |
| Physical al menos 1.3x el tiempo de GPU de standard | 1.46x | correcta |
| Los trastes se leen como níquel pulido con metalness 1, roughness de 0.2 a 0.35 | juzgado sobre la captura, no medido | no medida |
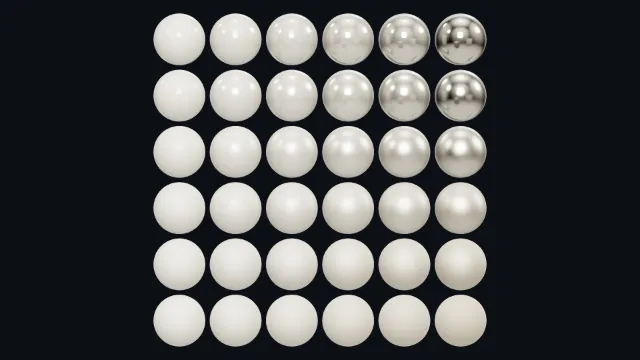
Qué significa para GA. Valores distintos de metalness y roughness no multiplican los programas: son uniforms. Los programas vienen del tipo y de las características del material, así que el clearcoat y el sheen de GA cuestan tiempo de sombreado, no compilación. Los 16 programas de una escena con un solo tipo de esfera son los del propio renderer: entorno, PMREM y pasadas de salida.
8. Sombras bajo las cuerdas
Sección titulada «8. Sombras bajo las cuerdas»Hipótesis. Un shadow map dinámico duplica los draw calls de los objetos que proyectan sombra; renderizarlo una sola vez no cuesta nada por fotograma; una textura precalculada cuesta un precálculo en CPU; una sombra de contacto cuesta una pasada y un desenfoque.
Montaje. 08-shadows renderiza el mástil a 1920 × 1080 con el shadow map de una luz direccional (1024, 2048 y 4096 texels, actualizado en cada fotograma o una sola vez), una textura de oclusión ambiental precalculada en la CPU lanzando 16 rayos por texel de una cuadrícula de 512 × 128, o una sombra de contacto: una vista ortográfica desde arriba de las partes por encima del diapasón en un render target de 512 × 128, desenfocada con 25 muestras en TSL.
| Ejecución | Draw calls | GPU ms | Coste único |
|---|---|---|---|
| Ninguna | 8 | 0.046 | |
| Shadow map 1024 | 13 | 0.051 | |
| Shadow map 4096 | 13 | 0.051 | |
| Shadow map renderizado una vez | 13, luego 8 | 0.046 | |
| AO precalculada | 8 | 0.046 | 398 ms de precálculo |
| Sombra de contacto | 14 | 0.068 |
| Predicción | Medido | Veredicto |
|---|---|---|
| Shadow map: unas 2x los draw calls | 13 frente a 8, 1.6x | aproximadamente correcta |
| 4096 frente a 1024: como mucho 1.5x el tiempo de GPU | 1.0x | correcta |
| Renderizado una vez: tras el primer fotograma, los draw calls de la ejecución sin sombras | 8 | correcta |
| Precálculo: de 100 a 500 ms | 398 ms | correcta |
| Sombra de contacto: menos de +0.5 ms de GPU | +0.022 ms | correcta |
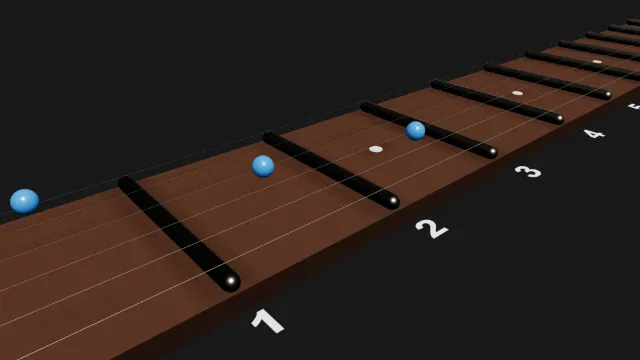
Qué significa para GA. El shadow map de un mástil dibuja pocos triángulos, así que su tamaño apenas importa en esta GPU; la elección es cuestión de memoria y de nitidez. Un mástil estático debería renderizar su sombra una sola vez (shadow.autoUpdate = false), y una textura precalculada elimina incluso eso, por 0.4 s en la carga.
9. Bloom en las notas activas
Sección titulada «9. Bloom en las notas activas»Hipótesis. El bloom añade una cadena fija de unas 10 a 12 pasadas cuyo coste sigue a la resolución; el bloom selectivo añade un color attachment.
Montaje. 09-bloom renderiza el mástil a 1920 × 1080 con la intensidad emisiva de los marcadores a 4, sin bloom, con bloom() sobre toda la imagen a resolución completa y a media resolución, y solo sobre una salida MRT emisiva (selective).
| Ejecución | Draw calls | Render targets | GPU ms |
|---|---|---|---|
| Ninguno | 7 | 1 | 0.034 |
| Completo | 19 | 12 | 0.169 |
| Media resolución | 19 | 12 | 0.106 |
| Selectivo (MRT) | 19 | 12 | 0.191 |
| Predicción | Medido | Veredicto |
|---|---|---|
| El bloom añade unos 10 a 12 draw calls | 12 | correcta |
| El bloom añade de 0.5 a 1.5 GPU ms a 1080p | +0.135 ms | incorrecta |
| Selectivo dentro de +20 % del completo | +13 % | correcta |
| Media resolución: como mucho 0.6x el tiempo añadido | 0.53x | correcta |
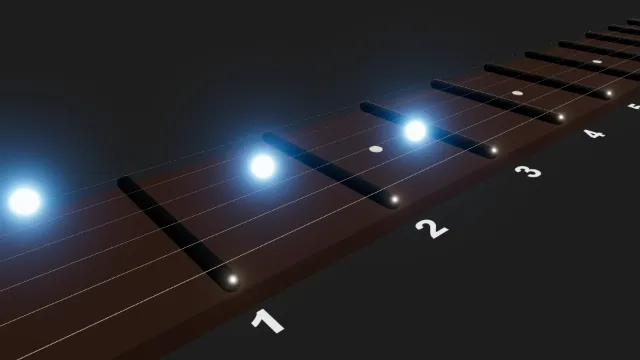
Qué significa para GA. El bloom en las notas activas cuesta 0.14 ms por fotograma 1080p en esta GPU, cuatro veces menos de lo previsto, y el bloom selectivo mediante MRT cuesta más o menos lo mismo que el bloom sobre todo, sin desenfocar la madera ni los trastes.
10. Una pared de guitarras: LOD y culling
Sección titulada «10. Una pared de guitarras: LOD y culling»Hipótesis. La mayoría de 1 000 cuerpos están lejos o fuera de la vista: el LOD divide los triángulos por 10, y desactivar el culling los dibuja todos.
Montaje. guitar-body.ts construye un cuerpo de guitarra de forma procedural, lo extruye y lo simplifica con meshoptimizer en un archivo glTF de tres niveles: 14 360, 3 590 y 718 triángulos. 10-lod-culling cuelga 1 000 de ellos en una pared, desplaza la cámara a lo largo de ella y promedia los contadores sobre los 240 fotogramas del recorrido.
| Ejecución | Draw calls, media del recorrido | Triángulos, media del recorrido | CPU ms | GPU ms |
|---|---|---|---|---|
| Detalle completo, culling activado | 334 | 4 780 804 | 0.970 | 0.210 |
| LOD, culling activado | 334 | 428 091 | 2.365 | 0.068 |
| Detalle completo, culling desactivado | 1 001 | 14 360 001 | 1.560 | 0.607 |
| LOD, culling desactivado | 1 001 | 1 326 075 | 3.450 | 0.139 |
| Predicción | Medido | Veredicto |
|---|---|---|
| LOD: como mucho 1/10 de los triángulos | 1/11.2 | correcta |
| Culling desactivado: al menos 2x los draw calls | 3x | correcta |
| LOD: como mucho 1/3 del tiempo de GPU | 0.32 | correcta |
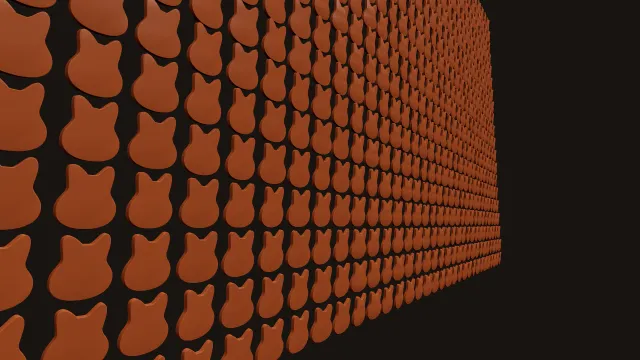
Qué significa para GA. El LOD ahorra en la GPU y cuesta en la CPU: THREE.LOD mide la distancia de cada cuerpo en cada fotograma, 2.4 veces el tiempo de CPU aquí. Con unas pocas guitarras en pantalla, no vale la pena; para una galería de cientos, sí.
11. Rapier: una púa que golpea una cuerda
Sección titulada «11. Rapier: una púa que golpea una cuerda»Hipótesis. Sin detección continua de colisiones (CCD), una púa que avanza 33 mm por paso a 1/60 s atraviesa una cuerda de 0.5 mm; la CCD lo impide; las articulaciones se estiran menos a medida que el paso se reduce.
Montaje. e11-rapier-pick.ts ejecuta Rapier 0.20 (build determinista) en Node.js: una cuerda de 64 cápsulas de 10 mm unidas por articulaciones esféricas entre la cejuela y el puente, y una púa cinemática que la cruza a 2 m/s, de 30 a 960 pasos por segundo, con la CCD desactivada, en la púa o en la cuerda.
| Pasos por segundo | Avance de la púa por paso | Contacto | La cuerda se movió | Mayor estiramiento | CPU ms por segundo simulado |
|---|---|---|---|---|---|
| 30 | 66.7 mm | no | no | 0 % | 9.5 |
| 60 | 33.3 mm | sí | no | 0 % | 14.0 |
| 120 | 16.7 mm | sí | sí | 33.6 % | 43.1 |
| 240 | 8.3 mm | sí | sí | 24.0 % | 65.3 |
| 480 | 4.2 mm | sí | sí | 12.9 % | 111.2 |
| 960 | 2.1 mm | sí | sí | 7.3 % | 204.0 |
Estas son las ejecuciones con la CCD desactivada; con la CCD en la púa o en la cuerda, los contactos fueron los mismos a todas las frecuencias, y el estiramiento a unos pocos puntos.
| Predicción | Medido | Veredicto |
|---|---|---|
| CCD desactivada: atraviesa a 1/30 y 1/60 s, no a 1/480 s | sí, sí (un evento de contacto a 1/60, la cuerda no se mueve), no | correcta |
| CCD activada: nunca atraviesa | atraviesa a 1/30 y 1/60 s | incorrecta |
| Estiramiento a 1/240 s: menos del 1 % | 24 % | incorrecta |
| A 1/30 s: más del 5 % de estiramiento o NaN | ningún contacto, nada se mueve | incorrecta |
| Tiempo de CPU proporcional a los pasos, dentro de un 30 % | de 0.21 a 0.36 ms por paso | aproximadamente correcta |
Qué significa para GA. La CCD de Rapier se aplica a los cuerpos dinámicos; una púa cinemática que se mueve fijando su próxima posición no se beneficia de ella, y tampoco una cuerda golpeada por ella. Una púa necesita al menos 120 pasos por segundo para tocar una cuerda, y una cadena de articulaciones se estira una cuarta parte a 240: una cuerda tocable se modela mejor con una ecuación de resorte (la fórmula del experimento 2), con Rapier solo para detectar el golpe.
12. WebXR a escala 1:1
Sección titulada «12. WebXR a escala 1:1»Hipótesis. Esta máquina no tiene casco; bajo la emulación de IWER, la distancia de la cejuela al traste 12 es de 0.324 m.
Montaje. 12-webxr-scale escala el mástil a metros (una unidad son 10 mm), pide una sesión immersive-vr de hardware, y luego inicia una en el Meta Quest 3 emulado de IWER, como hizo la lección 11.
| Medida | Valor |
|---|---|
| Sesión de hardware | no se pudo ejecutar: isSessionSupported("immersive-vr") es false |
| Sesión emulada | presentando, características local-floor, viewer, local |
| Vistas por fotograma XR | 2, separadas 63 mm |
| De la cejuela al traste 12 en el espacio de referencia | 0.324 m, tiro de 0.648 m |
| Posición de la cabeza dada, luego informada | (−0.1, 1.55, 0.45), luego (−0.1, 1.5751, 0.4751) |
| Predicción | Medido | Veredicto |
|---|---|---|
| Hardware: no se puede ejecutar | no se pudo ejecutar | correcta |
| De la cejuela al traste 12: 0.324 m con 1 mm de margen | 0.324 m | correcta |
| 2 vistas por fotograma | 2 | correcta |
Qué significa para GA. Un mástil a tamaño real es cuestión de unidades, y el emulador lo confirma; cómo se siente en la mano está por verificar en un casco. La cabeza emulada se informó 25 mm más arriba y más lejos de lo indicado, un desfase de la pose de IWER (por verificar) que un paso de calibración tendría que absorber.
13. WebAudio y la vibración de la cuerda
Sección titulada «13. WebAudio y la vibración de la cuerda»Hipótesis. Una vibración iniciada en el fotograma del clic se ve antes de que el sonido salga de los altavoces, con una antelación de baseLatency más outputLatency; programarla a partir de getOutputTimestamp() deja el desfase por debajo de un fotograma.
Montaje. 13-audio-sync pulsa una cuerda 20 veces, con una ganancia silenciosa, con la sincronización de fotogramas de Chromium activada (60 Hz), y mide cuánto se adelanta el primer fotograma de vibración al momento audible de la nota, iniciándola de inmediato (ingenua) o en el momento al que AudioContext.getOutputTimestamp() hace corresponder la nota (compensada). Se ejecutó en modo headless y con ventana.
| Ejecución | baseLatency | outputLatency | Fotograma | Adelanto ingenuo | Adelanto compensado |
|---|---|---|---|---|---|
| Headless | 10 ms | 40 ms | 16.66 ms | 31.0 ms | −2.3 ms |
| Con ventana | 10 ms | 40 ms | 16.66 ms | 31.8 ms | −1.5 ms |
| Predicción | Medido | Veredicto |
|---|---|---|
| baseLatency + outputLatency, con ventana: de 20 a 60 ms | 50 ms | correcta |
| Adelanto ingenuo: esa suma con un fotograma de margen | 31.8 ms, 18 ms menos | incorrecta, por poco |
| Adelanto compensado: menos de 17 ms | 1.5 ms | correcta |
| Headless: outputLatency 0 o ningún dispositivo | los mismos 10 y 40 ms | incorrecta |
Qué significa para GA. Sin compensación, la cuerda se mueve unos 30 ms, dos fotogramas, antes de que se oiga la nota: perceptible en un rasgueo rápido. Retrasar el inicio visual hasta el timestamp de salida lo elimina. Las latencias son las que Chromium informa para el dispositivo por defecto, no una medida acústica: una prueba con micrófono está por verificar.
14. React Three Fiber frente a vanilla
Sección titulada «14. React Three Fiber frente a vanilla»Hipótesis. El coste por fotograma de R3F es pequeño comparado con renderer.render(); su coste está en el arranque y en el bundle.
Montaje. 14-r3f-vs-vanilla carga o bien el Fretboard3D de la lección 13 en un Canvas controlado por advance(), o bien los mismos objetos con instancing construidos sin React, cada uno con un import dinámico, desde el servidor de desarrollo de Vite. bundle-sizes.mjs construye cada módulo por separado para producción.
| Medida | R3F | Vanilla |
|---|---|---|
| CPU ms por fotograma | 0.400 | 0.355 |
| Primer fotograma desde la navegación (servidor de desarrollo) | 958 ms | 528 ms |
| Heap de JavaScript tras los fotogramas | 36.96 MB | 26.98 MB |
| Draw calls, triángulos | 7, 11 919 | 7, 11 919 |
| Bundle de producción, gzip | 565 kB | 210 kB |
| Del cual no es three.js | 195 kB | 2 kB |
| Predicción | Medido | Veredicto |
|---|---|---|
| CPU por fotograma: R3F menos de +0.3 ms | +0.045 ms | correcta |
| Primer fotograma: R3F de +30 a 150 ms | +430 ms (servidor de desarrollo) | incorrecta |
| Bundle sin three.js: R3F de +50 a 90 kB gzip | +193 kB | incorrecta |
| Mismos draw calls | 7 y 7 | correcta |
Qué significa para GA. R3F no cuesta nada por fotograma. Cuesta en la carga: 430 ms en el servidor de desarrollo (por verificar en un build de producción) y 10 MB de heap. Su bundle además trajo three.js dos veces: R3F importa three, el build WebGL (three.module.js, 89 kB gzip), junto a three/webgpu, y el build de R3F pesó 565 kB frente a 210. Un alias de three a three/webgpu en la configuración de Vite debería eliminar el duplicado (por verificar).
15. Una GPU débil
Sección titulada «15. Una GPU débil»Hipótesis. El tiempo de GPU sigue al número de píxeles, así que un pixel ratio de 3 cuesta unas 9 veces el de 1 en una GPU débil; powerPreference no cambia nada en una máquina con un solo adaptador; un controlador adaptativo se estabiliza en menos de 60 fotogramas.
Montaje. 15-weak-gpu dibuja el mástil con instancing a 1200 × 400 píxeles CSS, en la RTX 5080 y en chromium-headless-shell, que no tiene adaptador WebGPU y recurre a WebGL 2 sobre SwiftShader, el rasterizador por CPU de Chromium, en el papel de GPU débil. El controlador adaptativo empieza con un pixel ratio de 2 y, cada 10 fotogramas, lo multiplica por 0.8 cuando la mediana del tiempo wall supera el 95 % de 16.7 ms, o por 1.1 por debajo del 60 %, entre 0.5 y 2.
| Pixel ratio | RTX 5080 GPU ms | SwiftShader wall ms |
|---|---|---|
| 0.5 | 9.0 | |
| 1 | 0.014 | 26.7 |
| 2 | 95.4 | |
| 3 | 0.037 | 208.2 |
Controlador adaptativo en SwiftShader, pixel ratio en cada comprobación: 2 (111.5 ms), 1.6 (74.6 ms), 1.28 (47.7 ms), 1.024 (31.2 ms), 0.819 (20.6 ms), 0.655 (14.5 ms), y luego 0.655 hasta el fotograma 120. En la RTX 5080 se quedó en 2, con medianas de 3.5 a 4.3 ms.
| Predicción | Medido | Veredicto |
|---|---|---|
| SwiftShader, ratio 3 frente a 1: al menos 5x | 7.8x | correcta |
low-power y high-performance: la misma RTX 5080 |
la misma, y Chromium avisa de que la opción se ignora en Windows | correcta |
| Controlador tras 60 fotogramas: RTX 2; SwiftShader 1 o menos | 2; 0.655 | correcta |
Qué significa para GA. El pixel ratio de 3 de GA hace que un mástil tarde 208 ms por fotograma en un rasterizador por software, y un controlador que se estabiliza en 0.655 lo lleva a 60 fotogramas por segundo en 60 fotogramas. powerPreference no puede elegir una GPU en Windows: lo hace la configuración gráfica del sistema operativo (por verificar en un portátil con dos GPU).
Lo que el laboratorio encontró en three.js r186
Sección titulada «Lo que el laboratorio encontró en three.js r186»InstancedMeshcon morph targets: con una instancia, el nodo de morph leemorphTargetInfluences, queInstancedMeshno crea, y falla connull; con varias, asignarlas falla enUniformArrayNode.updateBuffer. Un morph target de desplazamientos necesita ademásgeometry.morphTargetsRelative = true.BatchedMeshdibuja un draw call por objeto en el backend WebGPU (44 para un mástil), y 3 en WebGL 2 conWEBGL_multi_draw.- El compute de TSL se ejecuta en el backend WebGL 2.
renderer.info.memory.texturesSizecuenta 0 bytes para las texturas comprimidas, e incluye los render targets.GPUQueue.onSubmittedWorkDone()no se resuelve antes de unos 3.5 ms en Chromium 153 en Windows, lo que pone un suelo a cualquier tiempo wall medido con él.
Puntos clave
Sección titulada «Puntos clave»- Escribe la predicción antes de la ejecución: 19 de las 61 predicciones de este laboratorio fueron incorrectas del todo o en parte, varias por un factor, 2 no se pudieron medir, y las incorrectas cambiaron el consejo.
- En una GPU rápida, un mástil no cuesta nada; lo que crece es el número de objetos, el pixel ratio y el tiempo de carga.
- Conserva
Raycasterpara un diapasón, y TSL para las animaciones que mueven todas las instancias. - Todo el índice OPTIC-K de GA es un draw call de puntos; un compute shader anima un millón de ellos, incluso en WebGL 2.
- KTX2 Basis LZ divide por 8 la descarga de la madera;
renderer.infono puede decirte su memoria de GPU. - Una púa cinemática atraviesa una cuerda diga lo que diga la CCD: detecta el golpe, simula la cuerda con una fórmula.
- Compensa la latencia de audio con
getOutputTimestamp(), y limita el pixel ratio con un controlador, no con una constante.
Ejercicios
Sección titulada «Ejercicios»- Comparte los materiales entre 16 mástiles
Fretboard3Dy predice los draw calls y los programas antes de medir conrun.mjs 01-neck --run instanced-16. - Demuestra el suelo de la pasada de IDs en GPU: ejecuta el experimento 3 con 1 000 000 de notas. Predice primero ambos tiempos de selección.
- Añade en
vite.config.tsun alias dethreeathree/webgpupara el build de R3F y vuelve a ejecutarbundle-sizes.mjs. ¿Cuánto debería desaparecer? - ¿Por qué el controlador adaptativo se estabilizó en 0.655 y no en 0.8? Calcula el ratio con el que SwiftShader tardaría 15.9 ms, a partir de la tabla de ratios fijos.
- Explica por qué la CCD en la púa no la detuvo a 60 pasos por segundo, y cambia
e11-rapier-pick.tspara que lo haga. - La predicción del experimento 13 para el adelanto ingenuo falló por 18 ms. ¿Qué mide el adelanto ingenuo que la suma de latencias no mide?
Solución 1
Los 16 mástiles tienen 97 draw calls y 73 programas porque cada mástil crea sus propios materiales y su textura de etiquetas. Con un solo juego de materiales y una textura para todos los mástiles, el renderer no puede fusionar draw calls entre InstancedMesh separados: los draw calls se quedan en 6 por mástil más la pasada de salida, 97, mientras que los programas deberían bajar a unos 13, los de un mástil, y las texturas a 4. Para dibujar menos draw calls, los mástiles tendrían que compartir cada InstancedMesh (una malla de trastes con instancing para todos los mástiles), lo que da los 19 de la estrategia merged. Una predicción, no una ejecución medida (por verificar).
Solución 2
Raycaster creció de forma más o menos lineal: 0.07, 0.465 y 4.475 ms para 1 000, 10 000 y 100 000 notas, así que unos 45 ms para 1 000 000. La pasada de IDs pasó de 3.0 a 3.9 ms, mientras su render crecía de 0.04 a 1.3 GPU ms: con 1 000 000 de notas el render de 1 píxel sigue dibujando todas las instancias, unos 13 ms de GPU, así que unos 16 ms por selección. La selección en GPU debería ganar por unas 3 veces. Ejecuta node ga-lab/scripts/run.mjs 03-picking tras añadir una ejecución con notes=1000000; los números de arriba son extrapolados (por verificar).
Solución 3
En ga-lab/vite.config.ts, resolve.alias con { find: /^three$/, replacement: 'three/webgpu' } hace que el import * as THREE from 'three' de R3F cargue el build WebGPU. three.module.js (89 kB gzip) debería salir del bundle, y el total de R3F bajar de 565 kB hacia 476 kB. R3F 9 usa clases que exportan ambos builds, como Vector3, Raycaster y Object3D, así que debería seguir funcionando (por verificar: ejecuta de nuevo el experimento 14 y compara los draw calls).
Solución 4
El controlador multiplica por 0.8 por encima de 15.9 ms y por 1.1 por debajo de 10 ms. Con 0.819 midió 20.6 ms, por encima: 0.655. Con 0.655 midió 14.5 ms, entre 10 y 15.9: se queda. El tiempo wall es más o menos proporcional al número de píxeles, el cuadrado del ratio: 26.7 ms con 1 da 15.9 ms con la raíz cuadrada de 15.9 / 26.7, 0.77. El controlador no puede caer ahí: desde 0.819 su único paso hacia abajo es 0.655, y con 0.655 sus 14.5 ms están por encima de los 10 ms por debajo de los cuales subiría. Pasos más finos cerca del presupuesto, o un ratio calculado a partir del tiempo medido (el ratio actual por la raíz cuadrada del presupuesto entre el tiempo), se estabilizarían más cerca.
Solución 5
La CCD de Rapier barre el movimiento de un cuerpo entre su posición y la siguiente dada por su velocidad. Un cuerpo cinemático movido con setNextKinematicTranslation tiene un movimiento, pero la CCD resuelve penetraciones para los cuerpos dinámicos, empujándolos hacia atrás a lo largo del barrido; no detiene un cuerpo cinemático, y un segmento dinámico de cuerda de 10 mm no se barre contra una púa que salta 33 mm más allá de él. Dos formas que funcionan: subdividir el movimiento de la púa (varias llamadas a world.step() con desplazamientos más cortos por fotograma renderizado), o lanzar la forma de la púa a lo largo de su movimiento con world.castShape y aplicar un impulso al segmento que golpee. Un diseño, no código ejecutado (por verificar).
Solución 6
La suma de latencias es lo que tarda el audio desde el reloj del contexto hasta el altavoz. El adelanto ingenuo se mide entre fotogramas: la vibración se ve en el fotograma siguiente al clic, y el momento de salida de la nota se muestrea a 60 Hz, así que el adelanto es la latencia menos el tiempo hasta que se presenta ese fotograma, hasta un fotograma, y menos lo que el reloj de audio ya había avanzado en su render quantum de 10 ms. 50 ms menos un fotograma y un quantum dan de 23 a 33 ms: los 31.8 ms medidos caen dentro. La predicción debería haber sido “la suma menos hasta un fotograma y un render quantum”.
Fuentes
Sección titulada «Fuentes»- three.js r186:
WebGPURenderer,BatchedMesh,InstancedMesh,LOD,KTX2Loader, TSL - W3C: WebGPU (
timestamp-query,GPUQueue.onSubmittedWorkDone(),GPURequestAdapterOptions.powerPreference), Web Audio API (baseLatency,outputLatency,getOutputTimestamp()), WebXR Device API - Khronos: KTX 2.0, KTX-Software 4.4.2,
EXT_disjoint_timer_query_webgl2 - Chromium: issue 369219127,
powerPreferenceignorado en Windows - Rapier, detección continua de colisiones; IWER; meshoptimizer; React Three Fiber
- GuitarAlchemist/ga en
66bdd04:OptickIndexReader.cs