7. LoRA: cargarlos, apilarlos y qué implica entrenar uno
Secciones
Ajustes de lectura
Ninguna voz para este idioma en este navegador.
Más voces
Código y términos técnicos en inglés
Desactivado: la voz de la página lo lee todo, sin pausa entre dos voces.
Ninguna voz para este idioma en este navegador.
Más voces
Más voces: Microsoft Edge ofrece voces naturales en línea, y Windows (Configuración › Hora e idioma › Voz), macOS y Android instalan otras.
Código: los workflows 07-lora.api.json, 07-lcm.api.json, 07-lightning.api.json y 07-lora-stack.api.json; el lector de cabeceras en csharp/Safetensors.cs.
Un checkpoint son varios gigabytes de pesos. Afinarlos todos para un estilo o un tema produce otro checkpoint del mismo tamaño. Un LoRA solo guarda un cambio en algunos de los pesos, en un archivo que a menudo ocupa unos cientos de megabytes, y ComfyUI lo suma al checkpoint al cargar el modelo. En términos de C# o Java, es un plugin que parchea los datos de la aplicación anfitriona, no su código.
La adaptación de rango bajo
Sección titulada «La adaptación de rango bajo»LoRA (E. Hu et al., 2021) “freezes the pre-trained model weights and injects trainable rank decomposition matrices into each layer”. Para una matriz de pesos W con n salidas y m entradas, el entrenamiento aprende dos matrices pequeñas en lugar de una W nueva: B, de n por r, y A, de r por m, donde r, el rango, es pequeño, por ejemplo 32. Su producto B·A tiene la forma de W, y se suma a ella:
W’ = W + strength × (alpha / r) × B·A
alpha es un número guardado en el archivo para cada capa, y strength es el valor que fijas en ComfyUI. Para una matriz de atención de 1280 por 1280, un LoRA de rango 32 guarda 2 × 32 × 1280 = 81.920 números en lugar de 1.638.400. Una vez sumado, el cambio no cuesta nada durante el muestreo: el artículo lo resume como “no additional inference latency”.
Leer la cabecera de un LoRA
Sección titulada «Leer la cabecera de un LoRA»La herramienta del curso lee la cabecera de un archivo .safetensors, el JSON que da el nombre, el tipo y la forma de cada tensor, sin cargar los pesos. Para un LoRA, cuenta las capas adaptadas a partir de sus matrices lora_down, cuya primera dimensión es el rango, y lee los escalares alpha:
> comfy safetensors-info pixel-art-xl.safetensorspixel-art-xl.safetensors: header 311840 bytes, 2166 tensors, 0.17 GB of tensor data  BF16      2166 tensors,   0.17 GBLoRA: 722 adapted layers (722 in the UNet, 0 in the text encoders), rank 32  alpha: 32 (the weight change is scaled by alpha / rank)metadata ss_sd_model_name: sd_xl_base_0.9.safetensorsmetadata ss_base_model_version: sdxl_base_v0-9metadata ss_network_module: networks.lorametadata ss_network_dim: 32metadata ss_network_alpha: 32.0
> comfy safetensors-info lcm_lora_sdxl.safetensorslcm_lora_sdxl.safetensors: header 350920 bytes, 2364 tensors, 0.39 GB of tensor data  F16       2364 tensors,   0.39 GBLoRA: 788 adapted layers (788 in the UNet, 0 in the text encoders), rank 64  alpha: 8 (the weight change is scaled by alpha / rank)metadata ss_base_model_version: sdxl_base_v1-0metadata ss_network_module: networks.lorametadata ss_network_dim: 1metadata ss_network_alpha: 1metadata modelspec.architecture: stable-diffusion-xl-v1-base/lorametadata modelspec.title: sdxl_LCM_lora_rank1
Aquí se ven tres cosas que ningún cargador te dice:
- Los dos LoRAs solo cambian la UNet. El
strength_clipdeLoraLoaderno tiene ningún efecto con ellos. - El LoRA de pixel art se entrenó sobre SDXL 0.9, y aquí se usa sobre la 1.0.
- Los metadatos del LCM-LoRA dicen rango 1 y alfa 1, y su título dice
rank1. Los tensores dicen rango 64 y alfa 8: sus cambios se escalan por 8 / 64 = 0,125. ComfyUI lee los tensores, no los metadatos, así que al cargador no le afecta, pero una herramienta que confíe en los metadatos se equivoca con este archivo.
La CI no puede descargar un LoRA, así que ejecuta el mismo comando sobre dos archivos diminutos escritos por data/tiny-safetensors.py, un LoRA de 2 capas y una capa cuantizada para la lección 8, y compara la salida en los tres sistemas operativos.
Dónde aplica ComfyUI el parche
Sección titulada «Dónde aplica ComfyUI el parche»LoraLoader recibe el modelo y los codificadores de texto CLIP del cargador del checkpoint, y devuelve otros nuevos. Lee el archivo una vez por nodo, y lo conserva para la siguiente ejecución. No calcula ningún peso. load_lora_for_models asocia los nombres del archivo a las capas del modelo, clona el patcher del modelo y registra los parches con su intensidad:
lora = comfy.lora_convert.convert_lora(lora)loaded = comfy.lora.load_lora(lora, key_map)if model is not None: new_modelpatcher = model.clone() k = new_modelpatcher.add_patches(loaded, strength_model)El clon comparte los pesos del modelo original. Los parches se aplican cuando el sampler necesita el modelo, mediante calculate_weight en weight_adapter/lora.py, que es la fórmula de arriba:
if v[2] is not None: alpha = v[2] / mat2.shape[0]else: alpha = 1.0... weight += function(((strength * alpha) * lora_diff).type(weight.dtype))v[2] es el alpha del archivo, y mat2.shape[0] el rango. El log del servidor muestra el recuento cuando se carga el modelo, 722 parches para el LoRA de pixel art:
Model SDXL prepared for dynamic VRAM loading. 4896MB Staged. 722 patches attached. Force pre-loaded 512 weights: 1197 KB.Un archivo cuyos nombres no coinciden con nada del modelo no falla. load_lora escribe lora key not loaded en el log para cada nombre y sigue adelante: un LoRA para otro modelo base, como Stable Diffusion 1.5 sobre SDXL, no cambia nada, en silencio. Busca esa línea, o 0 patches attached, cuando un LoRA parezca no hacer nada.
Un LoRA de estilo, con tres intensidades
Sección titulada «Un LoRA de estilo, con tres intensidades»Pixel Art XL es un LoRA de 171 MB bajo la licencia CreativeML Open RAIL-M, la licencia anterior de Stable Diffusion 1.x, sin el “++” de la de SDXL. Su ficha es incoherente: sus consejos dicen “No trigger keyword require”, pero sus metadatos fijan instance_prompt: pixel art, y su prompt de ejemplo empieza por “pixel art”. El prompt del curso también empieza por “pixel art”.
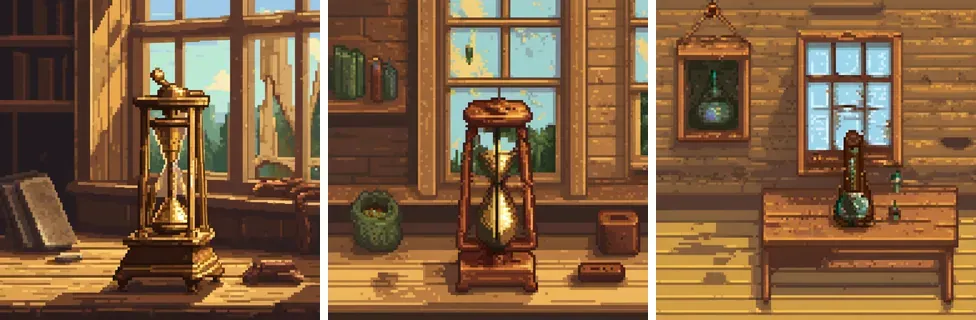
Renderizado por ComfyUI v0.36.0: Stable Diffusion XL base 1.0 con Pixel Art XL, semilla 42, 25 pasos, CFG 7, euler, normal, prompt “pixel art, a brass metronome on an old wooden workbench, morning light through a window”, workflow 07-lora.api.json. De izquierda a derecha: strength_model y strength_clip a 0,5, 1,0 y 1,5.
La intensidad del LoRA es un dial entre el checkpoint y el estilo, y los dos extremos pierden algo. Con 0,5 el objeto sigue ahí, con el detalle del modelo base dibujado en píxeles pequeños. Con 1,5 los píxeles son grandes y planos, y el tema ha desaparecido: los pesos parcheados ya no siguen el prompt. Las entradas de intensidad van de −100 a 100, y la página de LoraLoader dice que los valores son “typically used between 0~1 for daily image generation”.
Menos pasos: LCM-LoRA y SDXL-Lightning
Sección titulada «Menos pasos: LCM-LoRA y SDXL-Lightning»Algunos LoRAs cambian la forma en que el modelo muestrea en lugar de lo que dibuja. Estos dos están destilados: entrenados para que el modelo llegue a una imagen limpia en unos pocos pasos grandes, como lo haría un maestro que ejecuta muchos pasos pequeños.
| LoRA | Artículo | Tamaño | Licencia | Ajustes de la ficha |
|---|---|---|---|---|
| LCM-LoRA SDXL | arXiv 2311.05556 | 394 MB | CreativeML Open RAIL++-M | “only between 2 - 8 steps”, guía “between 1.0 and 2.0” |
| SDXL-Lightning 4-step | arXiv 2402.13929 | 394 MB | CreativeML Open RAIL++-M | “Euler sampler with sgm_uniform scheduler”, CFG 0 en diffusers |
Las fichas de los modelos dan sus ajustes para la biblioteca diffusers. En diffusers, una guía de 0 o de 1 desactiva la guía sin clasificador; en ComfyUI, lo hace el CFG 1, y el sampler se salta entonces la pasada del prompt negativo (lección 2). Los workflows usan 4 pasos y CFG 1, el sampler lcm para LCM-LoRA, y euler para Lightning, ambos con el scheduler sgm_uniform. La ficha de Lightning también dice que se use su checkpoint completo en lugar del LoRA sobre SDXL base: “Use LoRA only if you are using non-SDXL base models.”
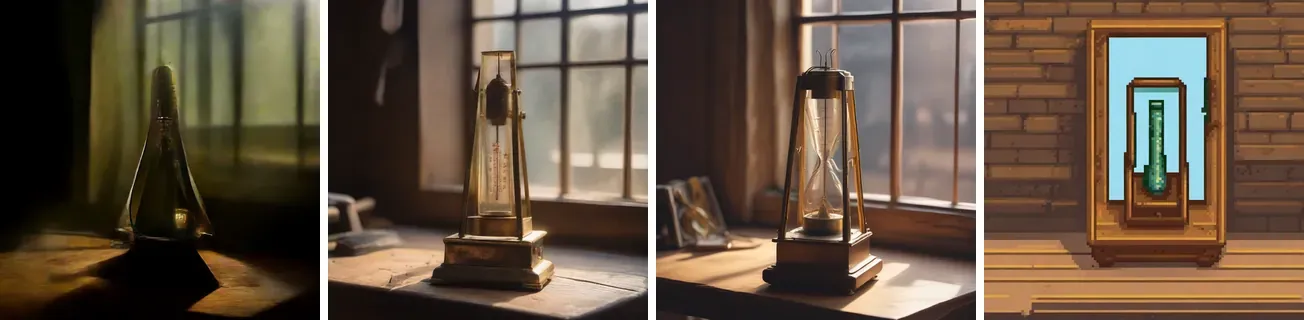
Renderizado por ComfyUI v0.36.0: Stable Diffusion XL base 1.0, semilla 42, prompt “a brass metronome on an old wooden workbench, morning light through a window, dust in the air, photograph” para las tres primeras. De izquierda a derecha: 01-txt2img.api.json con 4 pasos, CFG 7, euler, normal y sin LoRA; 07-lcm.api.json, LCM-LoRA, 4 pasos, CFG 1, lcm, sgm_uniform; 07-lightning.api.json, LoRA SDXL-Lightning de 4 pasos, 4 pasos, CFG 1, euler, sgm_uniform; 07-lora-stack.api.json, LCM-LoRA a 1,0 y Pixel Art XL a 1,2, 8 pasos, CFG 1,5, lcm, sgm_uniform, prompt “pixel art, a brass metronome on an old wooden workbench, morning light through a window”.
El modelo base con 4 pasos se quedó lejos de una imagen limpia, como mostró la comparación de pasos de la lección 2. Los dos LoRAs dieron una imagen nítida en los mismos 4 pasos. Ninguno dibujó un metrónomo reconocible, pero el modelo base tampoco lo hace con este prompt: la imagen de la lección 1, con 25 pasos, se parece más a un reloj de arena.
Una pila de dos
Sección titulada «Una pila de dos»LoraLoader devuelve un modelo, y otro LoraLoader puede recibirlo: la descripción del nodo dice “Multiple LoRA nodes can be linked together.” El segundo cargador vuelve a clonar el patcher, y añade sus propios parches a las mismas capas. Cuando se calculan los pesos, cada parche suma su término a W, así que para LoRAs simples el resultado es
W’ = W + s₁ × (α₁ / r₁) × B₁·A₁ + s₂ × (α₂ / r₂) × B₂·A₂
y el orden de los cargadores no lo cambia. La última imagen de arriba apila LCM-LoRA y Pixel Art XL con los ajustes de la ficha de Pixel Art XL: “Use 8 steps and guidance scale of 1.5” y “1.2 Lora strength for the Pixel Art XL works better”. El log dijo 788 patches attached, no 722 + 788: las 722 capas del LoRA de pixel art están entre las 788 del LCM-LoRA, y los parches de cada capa cuentan una sola vez.
Lo que cuestan los parches
Sección titulada «Lo que cuestan los parches»Un mismo servidor, recién arrancado, ejecutó esto en orden. Los tiempos son las líneas “Prompt executed” del servidor, y cada ejecución con “semilla nueva” solo cambiaba la semilla, así que los resultados de los codificadores de texto salieron de la caché:
| Ejecución | Pasos | Primera ejecución | Semilla nueva |
|---|---|---|---|
| SDXL base, sin LoRA | 25 | 13,49 s, con la carga del checkpoint | 4,93 s |
| LCM-LoRA | 4 | 6,42 s | 1,16 s |
| LoRA SDXL-Lightning | 4 | 7,40 s | 1,09 s |
| LCM-LoRA de nuevo, después de Lightning | 4 | 5,37 s |
Cambiar de LoRA costó unos 4 a 5 segundos en la primera ejecución: leer del disco el archivo de 394 MB y calcular 788 capas parcheadas. Después, una imagen de 4 pasos tardó algo más de un segundo, frente a 4,9 segundos para 25 pasos sin LoRA: el parche no cuesta nada por paso, y el ahorro está en los pasos. Volver a LCM-LoRA volvió a pagar el coste, porque LoraLoader solo conserva el último archivo que leyó, y los parches se volvieron a calcular. nvidia-smi mostró el mismo pico de memoria con y sin LoRA, unos 12,2 GB en una tarjeta en la que ya había 2,7 GB en uso.
La propia velocidad del sampler lo confirma. En las barras de progreso de una tanda anterior en la misma máquina, los 25 pasos de los renders de pixel art iban a entre 5,5 y 5,9 pasos por segundo, tan rápido como sin LoRA. El tiempo se fue en la fase Model Initializing de la barra de progreso, antes del primer paso: de 2,4 a 4,9 segundos con el LoRA de pixel art, y 19,3 segundos la primera vez que se leyó del disco el archivo de Lightning.
Entrenar un LoRA
Sección titulada «Entrenar un LoRA»El entrenamiento aprende A y B a partir de imágenes de ejemplo mientras el checkpoint permanece congelado. Las herramientas habituales están fuera de ComfyUI: kohya-ss/sd-scripts, que escribió los metadatos ss_ de arriba, y la guía de entrenamiento de LoRA de diffusers. ComfyUI v0.36.0 también tiene nodos de entrenamiento experimentales en nodes_train.py. TrainLoraNode recibe el modelo, los latentes de las imágenes de entrenamiento y su condicionamiento, y sus entradas son las decisiones que pide cualquier entrenador:
| Entrada | Valor por defecto | Qué decide |
|---|---|---|
rank |
8 | el tamaño de A y B, y del archivo |
steps, batch_size, grad_accumulation_steps |
16, 1, 1 | cuánto dura el entrenamiento, y cuántas imágenes ve cada actualización |
learning_rate, optimizer |
0,0005, AdamW | cuánto mueve cada actualización A y B |
loss_function |
MSE | cómo se compara el ruido predicho con el real |
training_dtype, lora_dtype |
bf16, bf16 | la precisión del modelo congelado y la del LoRA |
gradient_checkpointing, offloading |
activado, desactivado | memoria frente a tiempo |
algorithm |
LoRA | o LoHa, LoKr, OFT, otros métodos de rango bajo |
SaveLoRA escribe el resultado en un archivo .safetensors, y LoraModelLoader lo aplica sin guardarlo. El nodo está marcado como experimental y no tiene tutorial en la documentación. Este curso no entrena ningún LoRA: cuánto de 16 GB ocupa entrenar SDXL con estos nodos queda por verificar.
Puntos clave
Sección titulada «Puntos clave»- Un LoRA suma strength × (alpha / rango) × B·A a algunos de los pesos del checkpoint. Una vez sumado, no ralentiza el sampler.
- Lee la cabecera antes de fiarte de un LoRA: su rango y su alfa están en los tensores, que son correctos, y en los metadatos, que pueden estar mal.
LoraLoaderregistra parches. Se calculan cuando se carga el modelo, y el log dice cuántos se asociaron.- Un LoRA cuyos nombres no coinciden con el modelo no hace nada, con solo un aviso en el log.
- Los LoRAs de pocos pasos vienen con su propio sampler, scheduler y CFG; tómalos de la ficha, y traduce la guía 0 de diffusers al CFG 1 de ComfyUI.
- Los LoRAs apilados se suman, sea cual sea su orden.
Tu turno
Sección titulada «Tu turno»Toma un LoRA que hayas descargado y lee su cabecera antes de usarlo, con el lector de safetensors del curso: su rango y su alfa según los tensores, y luego según los metadatos, y comprueba si coinciden. Cárgalo con tres intensidades sobre el modelo base para el que se entrenó, después deliberadamente sobre otro, y busca en el registro la línea que dice cuántos parches se aplicaron: ese número es la diferencia entre un LoRA que actúa y uno que no hace nada en silencio.
Ejercicios
Sección titulada «Ejercicios»- La cabecera de un LoRA muestra una capa con
lora_down.weightde forma 16 por 640,lora_up.weightde forma 640 por 16, yalpha8. Constrength_model0,75, ¿por cuánto se multiplica B·A? - Cargas un LoRA hecho para Stable Diffusion 1.5 sobre SDXL base. La imagen es exactamente la misma que sin él. ¿Qué buscas en el log del servidor?
- Intercambia los dos nodos
LoraLoaderde07-lora-stack. ¿Esperas los mismos píxeles?
Solución 1
El rango es 16, la primera dimensión de lora_down. El factor es 0,75 × 8 / 16 = 0,375.
Solución 2
Líneas lora key not loaded:, una por cada nombre del archivo, y 0 patches attached cuando se carga el modelo SDXL. Los nombres y las formas de las capas de SD 1.5 no coinciden con los de SDXL, así que no se registra ningún parche, y el sampler ejecuta el modelo sin cambios. Por verificar: no se ejecutó para esta lección.
Solución 3
La suma es la misma en aritmética exacta, pero la suma en coma flotante no es asociativa: sumar los dos términos a W en el otro orden puede cambiar los últimos bits de algunos pesos, y la lección 2 mostró cómo pequeñas diferencias pueden crecer a lo largo de los pasos. ComfyUI también redondea el resultado al tipo del modelo con redondeo estocástico, con una semilla derivada del nombre de la capa. Espera la misma imagen a simple vista, y no necesariamente el mismo hash de píxeles. Por verificar: no se renderizó para esta lección.
Fuentes
Sección titulada «Fuentes»- E. Hu et al., LoRA: Low-Rank Adaptation of Large Language Models, 2021.
- S. Luo et al., LCM-LoRA: A Universal Stable-Diffusion Acceleration Module, 2023.
- S. Lin, A. Wang, X. Yang, SDXL-Lightning: Progressive Adversarial Diffusion Distillation, 2024.
- Documentación de ComfyUI: LoRA, varios LoRAs,
LoraLoader,TrainLoraNode. - ComfyUI en la v0.36.0:
nodes.py,comfy/sd.py,comfy/lora.py,comfy/weight_adapter/lora.py,comfy/model_patcher.py,comfy_extras/nodes_train.py. - Fichas de los modelos: nerijs/pixel-art-xl, latent-consistency/lcm-lora-sdxl, ByteDance/SDXL-Lightning.