8. Rendimiento, medido
Secciones
Ajustes de lectura
Ninguna voz para este idioma en este navegador.
Más voces
Código y términos técnicos en inglés
Desactivado: la voz de la página lo lee todo, sin pausa entre dos voces.
Ninguna voz para este idioma en este navegador.
Más voces
Más voces: Microsoft Edge ofrece voces naturales en línea, y Windows (Configuración › Hora e idioma › Voz), macOS y Android instalan otras.
Código: la página en src/08-performance/main.ts.
Qué cuesta qué
Sección titulada «Qué cuesta qué»Un fotograma tiene dos costes. En la CPU, three.js recorre el grafo de escena, actualiza las matrices, descarta lo que la cámara no ve, ordena, y envía un comando de dibujo por objeto. En la GPU, cada comando ejecuta los shaders sobre sus triángulos y sus píxeles. Una escena de muchos objetos pequeños está limitada por la CPU: la GPU espera mientras JavaScript prepara miles de comandos. Una escena de unas pocas mallas enormes, o una cadena de posprocesado pesada, está limitada por la GPU. Los remedios son distintos, así que el primer paso es contar.
| WPF 3D | MonoGame | three.js | |
|---|---|---|---|
| Muchas copias de una malla | un ModelVisual3D cada una, o un único MeshGeometry3D fusionado |
DrawInstancedPrimitives con un búfer de vértices de datos de instancia |
InstancedMesh |
| Mallas distintas, un material | fusionarlas tú mismo | fusionarlas tú mismo | BatchedMesh |
| Menos triángulos a lo lejos | nada integrado | tu código | LOD |
| Omitir lo que está fuera de pantalla | lo hace WPF | tu código, con BoundingFrustum |
automático, por objeto, a partir de su esfera envolvente |
| Contar | WPF Performance Suite | tus contadores, o un profiler de GPU | renderer.info, el panel de rendimiento del navegador |
La prueba: 10 000 marcadores
Sección titulada «La prueba: 10 000 marcadores»La página dibuja 10 000 pequeños icosaedros naranjas de 80 triángulos en una cuadrícula de 100 × 100, separados 0.1 unidades, como una aplicación de mástil podría dibujar cada nota de una escala en cada cuerda de muchos mástiles. ?mode= elige cómo se construyen, y ?view=close sitúa la cámara 1.5 unidades por encima de una esquina, mirando hacia abajo, de modo que la mayoría de los marcadores quedan fuera de pantalla.
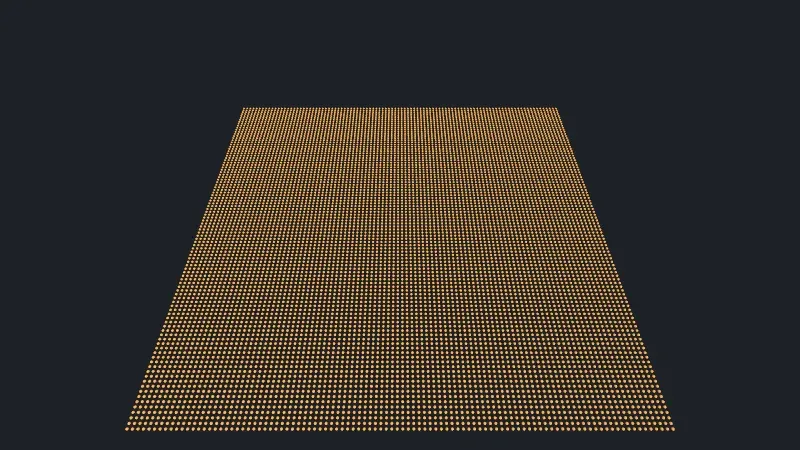
Página en vivo: ejecutarla aquí
Abrir a pantalla completa. Pruébalo: mode cambia entre las seis versiones medidas más abajo, markers cambia su número y view acerca la cámara: tiles con close es la medición del ejercicio 1. La escena de voicings de la lección 13 dibuja los marcadores de un acorde con una sola InstancedMesh: 7 draw calls, sea cual sea el acorde.
Tras tres fotogramas, la página lee renderer.info, luego renderiza 20 fotogramas más en un bucle y divide el tiempo: el tiempo de CPU de una llamada a renderer.render(), que registra y envía los comandos; la GPU trabaja después, y no entra en esa cifra. También mide el tiempo de construir los marcadores (setupMs) y el primer fotograma, que incluye la compilación de los shaders (firstFrameMs). check.sh compara los recuentos, e imprime los tiempos sin compararlos.
$ node scripts/probe.mjs 08-performance --query mode=meshes{ "frame": 4, "render": { "calls": 6, "drawCalls": 10001, "triangles": 800001 }, "memory": { "geometries": 2, "textures": 3, "programs": 4 }, "mode": "meshes", "count": 10000, "view": "all", "sceneChildren": 10002,}Cada modo, a partir de las salidas de check.sh, con los tiempos de una ejecución en la máquina del autor (WebGPU, una NVIDIA RTX 5080). Los tiempos varían de una ejecución a otra: ejecuciones anteriores, que promediaban 60 fotogramas, dieron 11.7 y 13.8 ms para meshes, y 0.11 ms para instanced.
?mode= |
hijos de la escena | draw calls | triángulos | geometrías | construcción | primer fotograma | un fotograma, CPU |
|---|---|---|---|---|---|---|---|
meshes: un Mesh cada uno, geometría y material compartidos |
10 002 | 10 001 | 800 001 | 2 | 18 ms | 229 ms | 10.3 ms |
unshared: una geometría y un material nuevos por Mesh |
10 002 | 10 001 | 800 001 | 10 001 | 309 ms | 446 ms | 32.9 ms |
instanced: un único InstancedMesh |
3 | 2 | 800 001 | 2 | 4.6 ms | 21.4 ms | 0.16 ms |
batched: un único BatchedMesh |
3 | 10 001 | 800 001 | 2 | 2.9 ms | 30.3 ms | 1.24 ms |
lod: un LOD de tres niveles Mesh cada uno |
10 002 | 10 001 | 200 001 | 2 | 62 ms | 252 ms | 21.8 ms |
Los hijos de la escena incluyen las dos luces; los draw calls y los triángulos incluyen el triángulo único de la pasada de salida.
Mallas: un draw call cada una
Sección titulada «Mallas: un draw call cada una»10 000 mallas son 10 000 draw calls, y 10.3 ms de CPU por fotograma: a 60 fotogramas por segundo, el 62 % del presupuesto de 16.7 ms se ha ido antes de cualquier otro trabajo. La GPU solo dibuja 800 000 triángulos, que maneja sin esfuerzo.
Las geometrías y los materiales no compartidos no cambian nada en pantalla, y más que triplican el tiempo de CPU. memory.geometries cuenta 10 001 búferes en la GPU. memory.programs se queda en 4: three.js reconoce que 10 000 materiales idénticos necesitan el mismo shader, pero cada material sigue teniendo sus propios uniforms y bindings que actualizar y comprobar en cada fotograma. Construirlos cuesta 309 ms, y liberarlos son 20 000 llamadas.
InstancedMesh: un draw call
Sección titulada «InstancedMesh: un draw call»Un InstancedMesh contiene una geometría, un material, y una matriz por instancia en un búfer de la GPU (líneas 60-65):
} else if (mode === 'instanced') { // Un objeto, una geometría, una matriz por instancia en un búfer de la GPU const markers = new THREE.InstancedMesh(geometry, material, count); for (let i = 0; i < count; i++) markers.setMatrixAt(i, matrix.makeTranslation(positionOf(i, position))); markers.computeBoundingSphere(); scene.add(markers);Los mismos 800 000 triángulos, en un draw call, por 0.16 ms de CPU: sesenta veces menos que las mallas. setColorAt da a cada instancia su propio color, y después de cambiar matrices o colores, instanceMatrix.needsUpdate = true vuelve a subir el búfer. Las instancias comparten todo lo demás: una geometría, un material. computeBoundingSphere() importa: la esfera debe cubrir todas las instancias, no la geometría en el origen, o toda la malla se descarta cuando el origen sale de la pantalla.
BatchedMesh: un objeto, muchos dibujos
Sección titulada «BatchedMesh: un objeto, muchos dibujos»Un BatchedMesh contiene varias geometrías en búferes compartidos, con un material, y dibuja instancias de cualquiera de ellas (líneas 81-86). Sirve para escenas cuyos objetos comparten un material pero no una forma: los trastes, las incrustaciones y los marcadores de un mástil, por ejemplo.
Cuenta 10 001 draw calls en WebGPU, y aun así solo tarda 1.24 ms. El backend WebGPU emite un drawIndexed por instancia, dentro de una sola pasada de render y con el mismo pipeline y los mismos bindings (WebGPUBackend.js, líneas 2124-2145). Esa es la parte barata de un draw call; la parte cara para meshes es todo lo que three.js hace por objeto antes. El ejercicio 2 muestra lo que cuenta el mismo BatchedMesh en WebGL.
LOD: menos triángulos, más trabajo
Sección titulada «LOD: menos triángulos, más trabajo»Un LOD contiene varias versiones de un objeto, y muestra aquella cuya distancia corresponde (líneas 87-96): 320 triángulos a menos de 3 unidades, 80 a partir de 3 unidades, 20 a partir de 8. Desde la cámara de vista general, todos los marcadores están a más de 8 unidades: 200 000 triángulos en lugar de 800 000. Pero 10 000 objetos LOD son 10 000 comprobaciones de distancia por fotograma además de las 10 000 mallas: 21.8 ms de CPU, el doble que las mallas simples. LOD ahorra trabajo de GPU en mallas grandes; para muchos objetos pequeños, cuesta más de lo que ahorra. BatchedMesh puede cambiar la geometría de una instancia con setGeometryIdAt, lo que da niveles de detalle sin los objetos.
Frustum culling, de cerca
Sección titulada «Frustum culling, de cerca»Con ?view=close, la cámara mira una esquina de la cuadrícula:
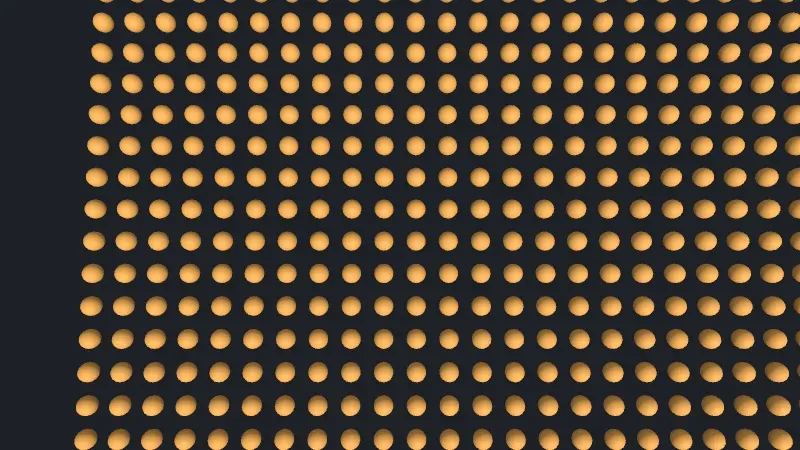
Página en vivo: ejecutarla aquí
?mode=, ?view=close |
draw calls | triángulos | un fotograma, CPU |
|---|---|---|---|
meshes |
345 | 27 521 | 1.46 ms |
instanced |
2 | 800 001 | 0.11 ms |
batched |
345 | 27 521 | 0.60 ms |
lod |
345 | 61 921 | 11.5 ms |
(Los tiempos de la vista cercana vienen de una ejecución anterior de la misma página, con un promedio de 60 fotogramas; check.sh solo imprime los de la vista general.)
- Mallas: 344 marcadores están dentro del frustum de la cámara, y three.js omite los otros 9 656, probando cada uno contra su esfera envolvente (
Renderer.js, líneas 3290-3294). El tiempo de CPU baja a 1.46 ms, pero la propia prueba sigue recorriendo 10 000 objetos. - InstancedMesh: todo o nada. Su esfera envolvente cubre toda la cuadrícula, que está en pantalla, así que la GPU recibe los 800 000 triángulos y descarta la mayoría después del vertex shader. El ejercicio 1 lo corta en mosaicos.
- BatchedMesh:
perObjectFrustumCulledestruepor defecto, así que prueba cada instancia antes de dibujarla (BatchedMesh.js, líneas 1590-1606): los mismos 344 marcadores que con mallas, en la mitad de tiempo. - LOD: de cerca, los marcadores visibles pasan a sus niveles detallados, y los triángulos se multiplican por más de dos, mientras que las 10 000 actualizaciones de distancia siguen ahí.
frustumCulled = false en un objeto desactiva la prueba: siempre se dibuja. Es lo correcto para un objeto cuyos vértices se desplazan en el shader más allá de su esfera envolvente, como la cuerda de la lección 6, y un desperdicio en los demás casos.
Leer las cifras
Sección titulada «Leer las cifras»info.renderse reinicia al comienzo de cada fotograma de animación, no en cada llamada arender()(Animation.js, línea 81, yInfo.js, líneas 184-198): una página que renderiza varias veces por fotograma, o fuera desetAnimationLoop, ve recuentos que se acumulan. Por eso la página los lee antes de su bucle de medición.drawCallscuenta lo que three.js pidió, no lo que hizo la GPU: el ejercicio 2 muestra unBatchedMeshcontado una sola vez en WebGL.- El tiempo de CPU en un navegador es grueso:
performance.now()se redondea, a 100 µs o menos según el aislamiento de la página. Promediar 20 fotogramas lo disimula. El tiempo de GPU no está en esta cifra; con WebGPU, una timestamp query lo mide, cuando el adaptador ofrece la funcionalidadtimestamp-query(por verificar en la GPU del autor). - Los runners de CI de Linux y Windows no tienen GPU, y renderizan con SwiftShader en la CPU: sus tiempos no dicen nada de una máquina real. El runner de macOS tiene WebGPU sobre la GPU paravirtualizada de Apple; en la ejecución 35123228046, que promediaba 60 fotogramas, tardó 22.8 ms para
meshes, 60.4 ms paraunshared, 0.23 ms parainstanced, 1.95 ms parabatchedy 29.1 ms paralod: más lento que la máquina del autor, en el mismo orden. Los recuentos son los mismos en todas partes, salvo los del ejercicio 2.
En GuitarAlchemist/ga
Sección titulada «En GuitarAlchemist/ga»GA usa InstancedMesh en 9 archivos, y BatchedMesh y THREE.LOD en ninguno.
- Un mástil hecho de mallas separadas.
ThreeFretboard.tsxconstruye, con sus 22 trastes y 6 cuerdas por defecto y sin marcadores, unas 49 mallas y 29 sprites. Cada traste recibe su propiaCapsuleGeometryy su propioMeshPhysicalMaterialcon clearcoat (líneas 960-1016), aunque el bucle da a los 22 la misma forma, ya que cada traste ocupa todo el ancho del mástil, y los mismos ajustes de material: la filaunshared, a pequeña escala. Cada marcador de posición recibe una nuevaSphereGeometry(markerRadius, 32, 32), 1 984 triángulos, y un material nuevo (líneas 1311-1335). Una escala de siete notas mostrada en seis cuerdas desde la cuerda al aire hasta el traste 22 son unos 80 marcadores, unos 160 000 triángulos para puntos pequeños; un únicoInstancedMeshconsetColorAtlos dibujaría en una sola llamada. - Una escena reconstruida cuando las props no cambian. El efecto que construye el mástil incluye
positionsentre sus dependencias (línea 424), ypositionsvale[]por defecto en la lista de parámetros (línea 58): un array nuevo en cada render de un padre que no lo pasa, así que toda la escena se libera y se reconstruye cada vez que el padre se renderiza. Que esto ocurra en las páginas de GA está por verificar con el profiler de React; el curso de React (Vite) trata las dependencias estables. La limpieza solo libera las mallas (líneas 388-414): los 29 sprites, cada uno con su propia textura de canvas, se quedan en memoria. - Instancing bien hecho, culling desactivado.
NodeInstancer.ts, de Prime Radiant, dibuja los nodos de su grafo con unInstancedMeshpor tipo de nodo, con colores por instancia y un material compartido (líneas 160-180), y asignafrustumCulled = falseporque “force-graph moves nodes”. La alternativa escomputeBoundingSphere()después de que cambien las posiciones; con un grafo que suele estar entero en pantalla, la diferencia es pequeña.frustumCulled = falseaparece en 15 archivos de GA. - Pixel ratios. 11 archivos llaman a
setPixelRatio(window.devicePixelRatio)sin límite, yThreeFretboard.tsxpide hasta 6 (línea 204). El número de píxeles crece con el cuadrado del ratio, y con él cada pasada a pantalla completa de la lección 7.
Experimento GA
Sección titulada «Experimento GA»La lección 14 lleva los recuentos de esta lección a las escenas de GA: el experimento 1 dibuja 16 mástiles de cuatro maneras (72 draw calls por mástil en la estructura de GA, 4 fusionados, y BatchedMesh con una llamada por objeto en WebGPU), el experimento 10 muestra que LOD ahorra tiempo de GPU pero cuesta tiempo de CPU en una pared de guitarras, y el experimento 5 dibuja los 313 047 voicings de GA en un solo draw call de puntos.
Puntos clave
Sección titulada «Puntos clave»- Cuenta antes de optimizar:
renderer.info.render.drawCallsytriangles, leídos una vez por fotograma de animación, y el tiempo de CPU derenderer.render(). - Muchos objetos cuestan CPU por objeto: 10 000 mallas tardaron aquí 10.3 ms por fotograma, un único
InstancedMeshde los mismos marcadores 0.16 ms. - Comparte geometrías y materiales: las copias no compartidas más que triplicaron el tiempo de CPU sin cambiar un píxel.
InstancedMeshpara muchas copias de una forma;BatchedMeshpara muchas formas con un material, con culling por instancia.LODahorra triángulos, no CPU: para muchos objetos pequeños, puede costar más de lo que ahorra.- El frustum culling funciona por objeto: divide un
InstancedMeshgrande en mosaicos, y mantén correctas las esferas envolventes en lugar de desactivar el culling.
Ejercicios
Sección titulada «Ejercicios»- De cerca, el
InstancedMeshsigue enviando 800 000 triángulos. Corta la cuadrícula en mosaicos de 4 × 4, unInstancedMeshcada uno, y mide la vista cercana. - Sondea el
BatchedMeshen el backend WebGL 2 con--webgl. ¿Por qué los draw calls difieren de los 10 001 de WebGPU, y hace realmente menos la GPU? - El mástil de GA podría mostrar una escala como marcadores. Planifica el paso de un
Meshpor marcador al instancing: qué se queda por marcador, qué pasa a ser compartido, y qué debe hacer el componente cuando cambia la escala.
Solución 1
El modo tiles agrupa los marcadores por mosaico, y da a cada mosaico su propio InstancedMesh y su propia esfera envolvente (líneas 66-80):
$ node scripts/probe.mjs 08-performance --query "mode=tiles&view=close"{ "frame": 4, "render": { "calls": 6, "drawCalls": 3, "triangles": 100001 }, "memory": { "geometries": 2, "textures": 3, "programs": 5 }, "mode": "tiles", "count": 10000, "view": "close", "sceneChildren": 18,}Dos de los 16 mosaicos tocan el frustum: 3 draw calls con la pasada de salida, y 100 000 triángulos, un octavo de la cuadrícula, en lugar de toda. El tamaño de mosaico es un compromiso: los mosaicos más pequeños descartan mejor y cuestan más draw calls cuando todo está en pantalla, 17 para la vista general en lugar de 2 (calculado: 16 mosaicos y la pasada de salida, ya que la vista general muestra todos los marcadores). memory.programs vale 5, uno más que con un único InstancedMesh: una diferencia en el número de instancias o en los búferes de los mosaicos da a uno de ellos su propio pipeline (por verificar en el código fuente). Para una cámara que se mueve, el culling por instancia de BatchedMesh hace lo mismo sin tener que elegir un tamaño de mosaico.
Solución 2
$ node scripts/probe.mjs 08-performance --webgl --query mode=batched{ "frame": 4, "render": { "calls": 6, "drawCalls": 2, "triangles": 800001 }, "memory": { "geometries": 2, "textures": 5, "programs": 4 }, "mode": "batched", "count": 10000, "view": "all", "sceneChildren": 3,}2 draw calls: el lote y la pasada de salida. Cuando el navegador ofrece la extensión WEBGL_multi_draw, el backend WebGL dibuja los 10 000 rangos con una sola llamada a multiDrawElementsWEBGL, y la cuenta una vez (WebGLBufferRenderer.js, líneas 53-90). La GPU sigue dibujando 10 000 rangos y 800 000 triángulos; lo que cambia es una llamada de JavaScript al driver en lugar de 10 000. WebGPU no tiene llamada multi-draw en su primera especificación, así que su backend recorre drawIndexed en un bucle, lo que ahí es barato. Sin la extensión, el backend WebGL también usa un bucle, con un uniform drawId por dibujo (WebGLBackend.js, líneas 1055-1077), y el recuento vuelve a 10 001. Así que drawCalls por sí solo no sirve para comparar dos backends: compara también el tiempo de CPU. Los runners de CI de Linux y Windows, que recurren a WebGL 2 sobre SwiftShader, tienen la extensión, y cuentan 2 también en la ejecución por defecto: check.sh guarda esa salida en expected/l08_probe_batched.webgl.txt.
Solución 3
Por marcador: una matriz, a partir de la cuerda y el traste, con el radio en su escala (los marcadores emphasized miden 0.25, los demás 0.2), y un color con setColorAt. Compartido: una única SphereGeometry con muchos menos segmentos, 16 × 12 basta para un punto, y un único MeshStandardMaterial; el color emissive por marcador no puede variar por instancia con un material simple, así que o bien lo eliminas, o usas un material de nodos cuyo emissiveNode lea el color de la instancia. Cuando cambia la escala: reserva una vez el InstancedMesh para el mayor número de marcadores, asigna a count el número de marcadores, escribe las matrices y los colores, y pon instanceMatrix.needsUpdate e instanceColor.needsUpdate, sin reconstruir el resto del mástil. Las etiquetas, que son sprites con una textura cada uno, son un problema aparte: un atlas de texturas, o etiquetas HTML sobre el canvas. Es un plan, no código ejecutado contra GA (por verificar).
Fuentes
Sección titulada «Fuentes»- Documentación de three.js:
InstancedMesh,BatchedMesh,LOD,Info; la página del manual optimize lots of objects - Código fuente de three.js en r186:
Renderer.js,Info.js,BatchedMesh.js,InstancedMesh.js,WebGPUBackend.js,WebGLBufferRenderer.js - Khronos:
WEBGL_multi_draw; W3C: WebGPU; MDN:performance.now() - MonoGame:
GraphicsDevice