2. La difusión, y qué hace reproducible una imagen
Secciones
Ajustes de lectura
Ninguna voz para este idioma en este navegador.
Más voces
Código y términos técnicos en inglés
Desactivado: la voz de la página lo lee todo, sin pausa entre dos voces.
Ninguna voz para este idioma en este navegador.
Más voces
Más voces: Microsoft Edge ofrece voces naturales en línea, y Windows (Configuración › Hora e idioma › Voz), macOS y Android instalan otras.
Código: el workflow es el de la lección 1, workflows/01-txt2img.api.json, cambiando una entrada cada vez. Las comparaciones usan el comando compare de la herramienta en C# del curso, en csharp/Png.cs.
La difusión en una página
Sección titulada «La difusión en una página»Un modelo de difusión se entrena con una tarea sencilla. Toma una imagen del conjunto de entrenamiento, añádele una cantidad aleatoria de ruido gaussiano y pide a la red que prediga el ruido que se añadió. Repite esto con una cantidad enorme de imágenes y de niveles de ruido, y la red aprende cómo son las imágenes en cada nivel de desenfoque y de grano. El método viene de Denoising Diffusion Probabilistic Models (Ho, Jain y Abbeel, 2020).
Generar ejecuta la tarea al revés. Parte de ruido puro, pregunta a la red qué parte es ruido, quita una porción y repite. Cada repetición es un paso. Tras suficientes pasos, lo que queda parece una imagen de la distribución de entrenamiento. Un prompt de texto orienta la predicción en cada paso, de modo que la imagen deriva hacia lo que describe el texto.
Tres refinamientos lo hacen práctico, y cada uno es un nodo del grafo de la lección 1.
El espacio latente: el VAE. Eliminar el ruido de 1024 × 1024 píxeles RGB es caro. La difusión latente (Rombach et al., 2021) entrena primero un autocodificador, el VAE, que comprime una imagen en un tensor latente mucho más pequeño y la reconstruye, y luego aplica la difusión sobre los latentes. En SDXL, una imagen de 1024 × 1024 se convierte en 4 canales de 128 × 128: 65.536 valores en lugar de 3.145.728, 48 veces menos. Por eso EmptyLatentImage crea torch.zeros([batch_size, 4, height // 8, width // 8]) (nodes.py, línea 1265), y por eso VAEDecode va al final. La compresión tiene pérdidas: la ficha del modelo dice “The autoencoding part of the model is lossy.”
Los codificadores de texto: CLIP. El prompt llega a la red como vectores, no como palabras. CLIP (Radford et al., 2021) se entrenó para situar una imagen y su descripción cerca una de otra en el mismo espacio vectorial, así que su mitad de texto convierte un prompt en vectores con un significado visual. SDXL usa dos codificadores de texto, “OpenCLIP ViT-bigG in combination with CLIP ViT-L”, y concatena sus salidas (artículo de SDXL). En ComfyUI, ambos se ocultan tras una sola salida CLIP y un solo nodo CLIPTextEncode.
La red de eliminación de ruido. La de SDXL es una UNet, una red convolucional con capas de atención por las que entran los vectores del texto. Su artículo describe “a three times larger UNet backbone” que el de las versiones anteriores de Stable Diffusion. En ComfyUI es la salida MODEL, y KSampler la llama una o dos veces por paso.
| En el artículo | En el grafo | Tamaño cargado en esta máquina |
|---|---|---|
| Codificadores de texto, CLIP ViT-L y OpenCLIP ViT-bigG | CLIP → CLIPTextEncode |
1.560 MB |
| UNet de eliminación de ruido | MODEL → KSampler |
4.896 MB |
| Autocodificador | VAE → VAEDecode |
159 MB |
| El ruido inicial | creado dentro de KSampler, a partir de la semilla |
— |
De dónde viene el ruido
Sección titulada «De dónde viene el ruido»El nodo EmptyLatentImage no genera ruido; su latente está todo a cero. Es KSampler quien genera el ruido, en comfy/sample.py:
def prepare_noise_inner(latent_image, generator, noise_inds=None):    if noise_inds is None:        return torch.randn(latent_image.size(), dtype=torch.float32, layout=latent_image.layout, generator=generator, device="cpu").to(dtype=latent_image.dtype)
def prepare_noise(latent_image, seed, noise_inds=None):    generator = torch.manual_seed(seed)
La semilla inicializa el generador de números aleatorios de PyTorch, y el ruido se genera en la CPU y después se mueve a la GPU. Así que el ruido de partida para una semilla y un tamaño de latente dados no depende de la tarjeta gráfica. Es como new Random(42) en C# o Java: la misma semilla da la misma secuencia. Lo que le ocurre después a ese ruido se ejecuta en la GPU, y ahí es donde la reproducibilidad se complica, como muestra la segunda mitad de esta lección. El tutorial de texto a imagen de ComfyUI dice que EmptyLatentImage “constructs a pure noise latent space”; el código dice lo contrario.
Las entradas del sampler, una a una
Sección titulada «Las entradas del sampler, una a una»Todas las imágenes siguientes las renderizó ComfyUI v0.36.0 a partir del workflow de la lección 1 con una sola entrada cambiada. Todas las imágenes: Stable Diffusion XL base 1.0, 1024 × 1024, prompt positivo “a brass metronome on an old wooden workbench, morning light through a window, dust in the air, photograph”, prompt negativo “blurry, text, watermark”, workflow 01-txt2img.api.json, reducidas para esta página. Salvo que el pie diga otra cosa: semilla 42, 25 pasos, CFG 7, sampler euler, scheduler normal.
Los pasos
Sección titulada «Los pasos»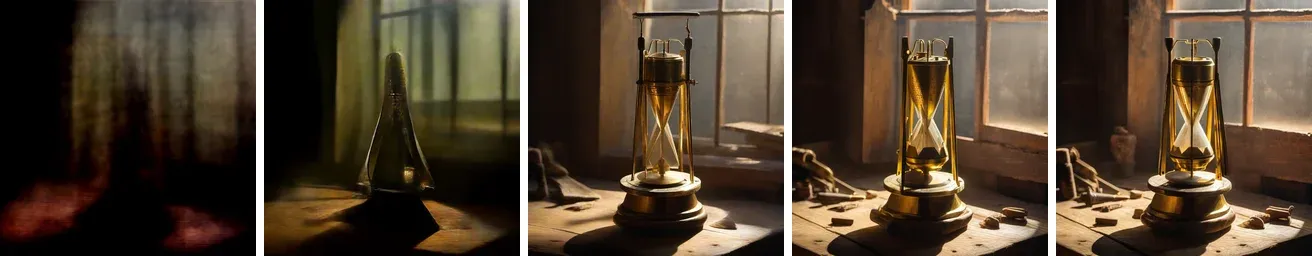
Semilla 42; 1, 4, 10, 25 y 50 pasos.
Con un paso, el sampler elimina de un salto todo el ruido que predice, y obtiene una mancha borrosa. La escena aparece entre los 4 y los 10 pasos. De 25 a 50, la composición se mantiene pero los detalles cambian: la herramienta de comparación encuentra un 99,37 % de píxeles distintos, un 40,87 % en más de 8 niveles sobre 255. Más pasos no es un refinamiento de la misma imagen, es otro recorrido por el mismo modelo. El tiempo de ejecución, con los prompts ya codificados, crece con los pasos: 0,83 s para 1 paso, 2,15 s para 10, 4,6 s para 25, 8,56 s para 50.
El CFG, la guía sin clasificador
Sección titulada «El CFG, la guía sin clasificador»En cada paso, el sampler ejecuta la red dos veces: una con el prompt positivo y otra con el negativo. Después se aleja de la predicción negativa y se acerca a la positiva, en comfy/samplers.py:
cfg_result = uncond_pred + (cond_pred - uncond_pred) * cond_scalecond_scale es la entrada cfg. Con 1, el resultado es solo la predicción positiva. Con 7, la diferencia entre las dos predicciones se multiplica por siete. El método viene de Classifier-Free Diffusion Guidance (Ho y Salimans, 2022).
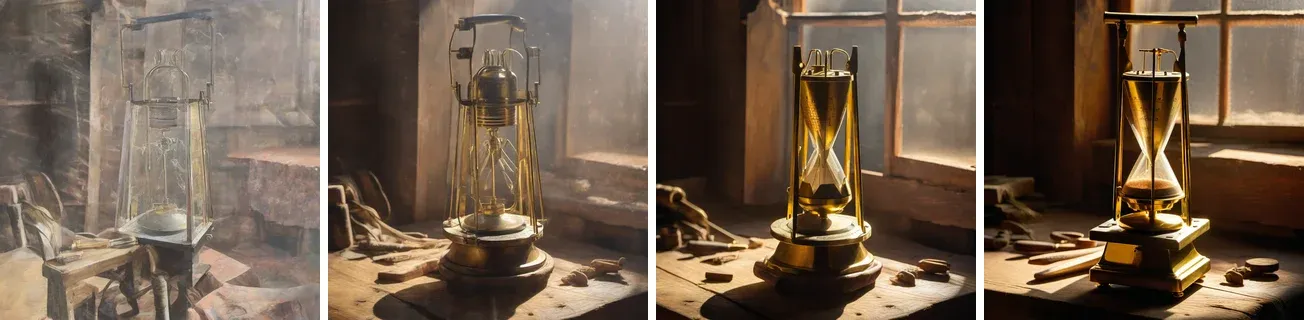
Semilla 42; CFG 1, 3, 7 y 12.
Aquí, un CFG bajo siguió el prompt de forma laxa y dio imágenes pálidas y brumosas, y un CFG más alto dio más contraste y saturación. El CFG 1 también fue más rápido: 3,29 s en lugar de unos 4,6 s. El sampler se salta la predicción negativa cuando la escala es 1 (samplers.py, líneas 609 a 613), ya que no cambiaría el resultado, así que cada paso ejecuta la red una vez en lugar de dos.
El sampler y el scheduler
Sección titulada «El sampler y el scheduler»El scheduler decide el nivel de ruido de cada paso: a qué ritmo baja el ruido, desde el nivel más alto hasta cero. El sampler es el método numérico que pasa de un nivel al siguiente, igual que elegir entre Euler y Runge-Kutta para resolver una ecuación diferencial. Karras et al. (2022) plantearon así los samplers, y dieron su nombre al scheduler karras, que dedica más pasos a los niveles de ruido bajos. dpmpp_2m es un solucionador de segundo orden de DPM-Solver++ (Lu et al., 2022). ComfyUI 0.36.0 ofrece 45 samplers y 9 schedulers.
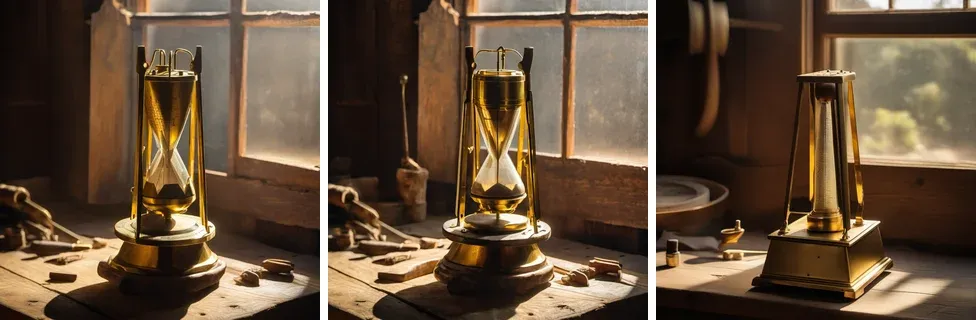
Semilla 42; euler con normal, dpmpp_2m con karras, euler_ancestral con normal.
euler y dpmpp_2m conservaron la composición: la herramienta midió una diferencia media de 14,2 niveles, frente a 39,2 con euler_ancestral. euler_ancestral es un sampler ancestral: en cada paso, elimina algo más de ruido del previsto y vuelve a añadir ruido aleatorio nuevo, así que puede alejarse más del recorrido que siguen los otros dos. El ruido nuevo también depende de la semilla, así que una segunda ejecución del mismo grafo dio los mismos píxeles. Pero fíjate en de dónde viene ese ruido, en comfy/k_diffusion/sampling.py:
def default_noise_sampler(x, seed=None):    if seed is not None:        if x.device == torch.device("cpu"):            seed += 1
        generator = torch.Generator(device=x.device)        generator.manual_seed(seed)
A diferencia del ruido inicial, se genera en x.device, la GPU cuando la hay. Los generadores de números aleatorios de la CPU y de CUDA no producen los mismos números para la misma semilla, y el código incluso desplaza la semilla en la CPU. Por tanto, cabe esperar que la imagen de un sampler ancestral para una semilla dada dependa del dispositivo; este curso no renderizó SDXL en la CPU para medirlo, así que queda por verificar.
La semilla y el lote
Sección titulada «La semilla y el lote»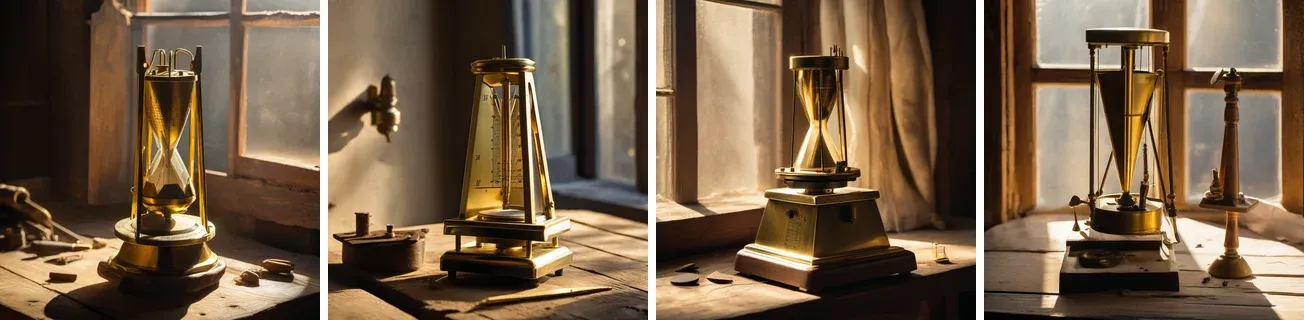
Semillas 42, 43 y 7; después, la segunda imagen de un lote de dos con la semilla 42 (batch_size 2).
Cada semilla es una imagen distinta; el prompt solo fija lo que tienen en común. Un lote de dos con la semilla 42 no da las imágenes de las semillas 42 y 43: prepare_noise genera un solo tensor de ruido para todo el lote a partir de un solo generador, así que la segunda imagen recibe los números que siguen a los de la primera en la secuencia. La primera imagen del lote se parecía a la imagen única de la semilla 42, pero no era idéntica; la sección siguiente explica por qué.
La reproducibilidad, medida
Sección titulada «La reproducibilidad, medida»La documentación de KSampler dice que la misma semilla “generates identical images”. Las notas sobre reproducibilidad de PyTorch son más prudentes: “Completely reproducible results are not guaranteed across PyTorch releases, individual commits, or different platforms. Furthermore, results may not be reproducible between CPU and GPU executions, even when using identical seeds.”
Para averiguarlo en una máquina, se calculó el hash de cada render de esta lección: el SHA-256 de sus píxeles decodificados, los 16 primeros dígitos hexadecimales, impreso por la herramienta en C#. Los píxeles, no el archivo: dos PNG con los mismos píxeles difieren en cuanto difieren sus metadatos, y la lección 3 muestra que incluso los bytes comprimidos dependen de la biblioteca zlib.
| Mismo workflow, semilla 42 | Hash de los píxeles |
|---|---|
| Primera ejecución tras arrancar el servidor | 698e7867e7fc04fb |
| Primera ejecución tras un reinicio, dos veces | 698e7867e7fc04fb |
Primera ejecución tras arrancar con --deterministic |
698e7867e7fc04fb |
| Nueva ejecución tras cambiar el prompt negativo y restaurarlo | 5374ac40a393cf78 |
Lo mismo, tras --deterministic |
5374ac40a393cf78 |
Primera ejecución tras arrancar con --disable-dynamic-vram |
5374ac40a393cf78 |
| Encolado desde el navegador, tras ejecuciones por la API | 5374ac40a393cf78 |
| La primera imagen de un lote de dos | 3a5c00b46e6f4956 |
Así que el mismo grafo, con la misma semilla, el mismo modelo y el mismo servidor, dio dos imágenes distintas, cada una de forma reproducible. La diferencia no es la semilla:
> comfy compare default-cold_00001_.png default-warm2_00001_.pngidentical pixels: nolargest difference: 182 of 255, mean 0.922pixels that differ: 68.02 %, by more than 8: 2.63 %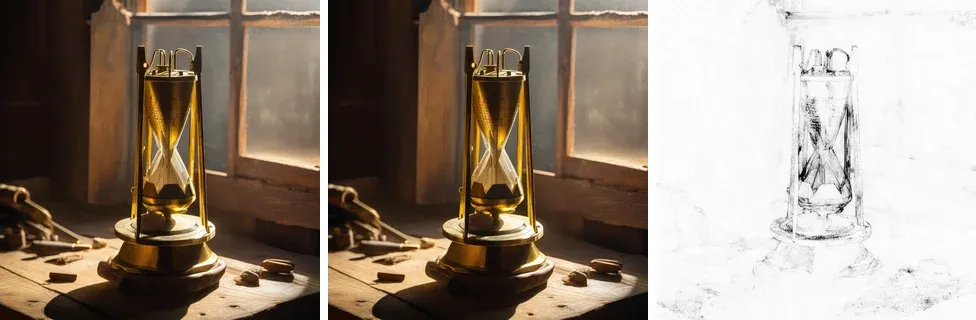
Izquierda: primera ejecución tras arrancar el servidor. Centro: el mismo grafo ejecutado de nuevo después de volver a codificar el prompt negativo. Derecha: dónde difieren, amplificado ocho veces, oscuro donde la diferencia es grande.
Las dos imágenes difieren en los bordes y en los detalles finos, que es lo que producen pequeñas diferencias numéricas en la eliminación del ruido. Lo que decide entre ellas es el orden en que se cargaron las redes:
- En un servidor recién arrancado, los codificadores de texto se ejecutan antes de que la UNet esté en la GPU, y dan
698e…. - Cuando el prompt negativo se vuelve a codificar más tarde, la UNet ya está cargada, y el resultado es
5374…. - Con
--disable-dynamic-vram, que desactiva el modo de carga que el log indica comoDynamicVRAM support detected and enabled, la primera ejecución ya da5374…. --deterministic, que pide a PyTorch algoritmos deterministas, no cambió nada: su texto de ayuda advierte que “might not make images deterministic in all cases”.
Este curso no ha rastreado qué operación difiere entre los dos estados de carga; queda por verificar, y anotado en el diario del curso.
El lote es un tercer caso. Su primera imagen tiene el mismo ruido de partida que la imagen única, pero la eliminación del ruido se ejecuta sobre un tensor de dos imágenes a la vez, y los kernels de la GPU para un lote de dos no redondean exactamente igual que los de uno: diferencia media de 0,739, un 1,49 % de los píxeles en más de 8 niveles.
Lo que sí se reprodujo exactamente:
- el mismo grafo tras reiniciar el servidor, tres veces;
- la semilla 43, ejecutada por el cliente Java de la lección 4 en un arranque posterior del servidor, frente a la misma semilla renderizada antes: píxeles idénticos;
euler_ancestral, ejecutado dos veces seguidas.
Qué significa la reproducibilidad en la práctica:
- Guarda el JSON del prompt con la imagen. ComfyUI ya lo escribe en el PNG.
- Anota lo que no está en el JSON: el SHA-256 del archivo del modelo, el commit de ComfyUI, las versiones de PyTorch y del driver, la GPU y las opciones del servidor.
- Compara píxeles con una tolerancia, no archivos con un hash, cuando una prueba comprueba un render. Una tolerancia no es un hash perceptual; el curso no ha comprobado si un hash perceptual sería estable en estos casos.
- Espera una imagen distinta con otra GPU, otro PyTorch u otro sistema operativo. Nada de eso se midió aquí, así que queda por verificar.
Puntos clave
Sección titulada «Puntos clave»- Un checkpoint son tres redes: codificadores de texto que convierten el prompt en vectores, una UNet de eliminación de ruido que trabaja en un espacio latente 48 veces más pequeño, y un VAE que convierte entre latentes y píxeles.
KSamplergenera el ruido de partida a partir de la semilla en la CPU, y luego elimina el ruido en la GPU durantestepspasos, llamando a la UNet dos veces por paso salvo que el CFG sea 1.- Los pasos, el CFG, el sampler, el scheduler y la semilla cambian cada uno la imagen, no solo su calidad; los samplers ancestrales añaden en cada paso ruido derivado de la semilla, generado en la GPU.
- En una máquina, el mismo grafo y la misma semilla dieron píxeles idénticos tras los reinicios, pero una imagen distinta cuando los codificadores de texto se ejecutaron con la UNet ya cargada, y dentro de un lote. Anota todo el entorno y compara los píxeles con una tolerancia.
Tu turno
Sección titulada «Tu turno»Toma una indicación tuya y mide, en lugar de mirar. Haz un render, reinicia el servidor, repite el render con la misma semilla y compara los dos PNG con compare, la herramienta en C# del curso: son los números, no tus ojos, los que dicen si algo se movió. Repite luego la misma semilla dentro de un lote de cuatro y compara la primera imagen del lote con la imagen suelta. Anota lo que hace tu máquina, como hace esta lección: es la respuesta de tu máquina, no la de esta, en la que te apoyarás después.
Ejercicios
Sección titulada «Ejercicios»- Una imagen de 1344 × 768 tiene más o menos el mismo número de píxeles que una de 1024 × 1024. ¿Qué tamaño tiene su latente, y es igual la proporción de valores?
- Renderiza dos veces la semilla 42 con CFG 1 y compara los dos archivos con
comfy compare. Después renderiza con CFG 1 y con CFG 1,01: ¿cuál es más rápido, y por qué? prepare_noiserecibe un argumentonoise_inds, que se rellena a partir delbatch_indexdel latente. Leeprepare_noise_inner: ¿qué hace con el generador para los índices que no están en el lote, y qué problema resuelve eso?
Solución 1
El latente tiene 4 canales de 168 × 96, porque EmptyLatentImage divide cada lado por 8: 64.512 valores. La imagen tiene 3 × 1344 × 768 = 3.096.576 valores. La proporción es 48, como para 1024 × 1024: 3 canales de píxeles frente a 4 canales en una sesentaicuatroava parte de la superficie, 64 × 3 / 4 = 48, sea cual sea el tamaño.
Solución 2
Si encolas el segundo render con CFG 1 sin cambios, no se ejecuta nada: el servidor reutiliza su resultado en caché y no escribe ningún archivo nuevo, así que cambia el filename_prefix para obtener un segundo archivo. Entonces solo se ejecuta SaveImage, a partir de la imagen en caché, y compare dice identical pixels: yes por construcción; para comparar dos renders reales, reinicia el servidor entre ellos. El CFG 1,01 es más lento, como el CFG 7: math.isclose(cond_scale, 1.0) es falso para 1,01, así que el sampler vuelve a ejecutar la red para el prompt negativo en cada paso. La imagen cambia muy poco, ya que la diferencia entre las predicciones se multiplica por 1,01 en lugar de por 1.
Solución 3
unique_inds, inverse = np.unique(noise_inds, return_inverse=True)noises = []for i in range(unique_inds[-1]+1): noise = torch.randn([1] + list(latent_image.size())[1:], dtype=torch.float32, layout=latent_image.layout, generator=generator, device="cpu").to(dtype=latent_image.dtype) if i in unique_inds: noises.append(noise)Genera el ruido de cada índice desde 0 hasta el mayor, y solo conserva los índices del lote. Generar y descartar hace avanzar el generador, así que la imagen de índice 3 de un lote, contando desde 0, siempre recibe el ruido que habría tenido como cuarta imagen del lote completo. Eso permite volver a renderizar por separado una imagen de un lote, con el mismo ruido.
Fuentes
Sección titulada «Fuentes»- J. Ho, A. Jain, P. Abbeel, Denoising Diffusion Probabilistic Models, 2020.
- R. Rombach, A. Blattmann, D. Lorenz, P. Esser, B. Ommer, High-Resolution Image Synthesis with Latent Diffusion Models, 2021.
- A. Radford et al., Learning Transferable Visual Models From Natural Language Supervision, 2021.
- J. Ho, T. Salimans, Classifier-Free Diffusion Guidance, 2022.
- T. Karras, M. Aittala, T. Aila, S. Laine, Elucidating the Design Space of Diffusion-Based Generative Models, 2022.
- C. Lu et al., DPM-Solver++: Fast Solver for Guided Sampling of Diffusion Probabilistic Models, 2022.
- D. Podell et al., SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis, 2023.
- ComfyUI en la v0.36.0:
comfy/sample.py,comfy/samplers.py,comfy/k_diffusion/sampling.py; documentación de KSampler. - PyTorch, Reproducibility.