6. ControlNet: bordes y profundidad
Secciones
Ajustes de lectura
Ninguna voz para este idioma en este navegador.
Más voces
Código y términos técnicos en inglés
Desactivado: la voz de la página lo lee todo, sin pausa entre dos voces.
Ninguna voz para este idioma en este navegador.
Más voces
Más voces: Microsoft Edge ofrece voces naturales en línea, y Windows (Configuración › Hora e idioma › Voz), macOS y Android instalan otras.
Código: los workflows 06-canny.api.json y 06-depth.api.json.
La lección 5 partía de una imagen existente, y denoise decidía cuánto de ella sobrevivía. Eso ata los colores y las texturas a la imagen antigua tanto como su composición. ControlNet solo conserva la composición: un mapa de bordes o un mapa de profundidad guía al sampler en cada paso, y el sampler parte de ruido puro. El punto de partida vuelve a ser el metrónomo de la lección 1, con la semilla 42.
Una segunda red junto a la UNet
Sección titulada «Una segunda red junto a la UNet»El artículo de ControlNet (L. Zhang, A. Rao y M. Agrawala, 2023) copia la mitad codificadora de una UNet entrenada y entrena la copia con pares formados por una imagen de condición y una imagen. El modelo original no cambia: “ControlNet locks the production-ready large diffusion models, and reuses their deep and robust encoding layers”. Las salidas de la copia pasan por convoluciones inicializadas a cero, y se suman a las activaciones de la propia UNet. Por tanto, antes del entrenamiento, el ControlNet no añade nada.
En ComfyUI, la suma está en control_merge. Cada salida del ControlNet se multiplica por strength, y después se suma a la salida del ControlNet anterior, si lo hay:
if x not in applied_to: #memory saving strategy, allow shared tensors and only apply strength to shared tensors once applied_to.add(x) if self.strength_type == StrengthType.CONSTANT: x *= self.strength... o[i] = prev_val + o[i] #TODO: change back to inplace add if shared tensors stop being an issueEncadenar dos nodos ControlNetApplyAdvanced suma, por tanto, sus efectos: un mapa de bordes y un mapa de profundidad pueden guiar la misma imagen, y cada uno tiene su propia intensidad.
El workflow
Sección titulada «El workflow»| Nodo | Qué hace aquí |
|---|---|
LoadImage |
la imagen de la que viene la composición |
Canny, o los nodos de Lotus |
la convierten en un mapa de bordes, o en un mapa de profundidad |
ControlNetLoader |
carga el ControlNet desde models/controlnet |
SetUnionControlNetType |
indica a un ControlNet union qué tipo de mapa recibe |
ControlNetApplyAdvanced |
asocia el ControlNet, el mapa, strength, start_percent y end_percent al condicionamiento positivo y al negativo |
KSampler |
muestrea a partir de un latente vacío, como en la lección 1 |
ControlNetApplyAdvanced no ejecuta nada. Copia el condicionamiento y le añade el ControlNet, para el prompt positivo y para el negativo, y el sampler lo llama en cada paso. Con strength 0 devuelve el condicionamiento sin cambios. El nodo más antiguo ControlNetApply está marcado como obsoleto, y aplica el ControlNet a un solo condicionamiento.
Un modelo para varios tipos de mapa
Sección titulada «Un modelo para varios tipos de mapa»Los ControlNets de SDXL se entrenaron primero uno por condición: uno para los bordes de Canny, otro para la profundidad, y así sucesivamente. El curso usa en su lugar el modelo union ControlNet++ de xinsir, en su versión ProMax: un único archivo de 2,5 GB, bajo la licencia Apache 2.0, cuya ficha dice que admite “10+ control conditions, no obvious performance drop on any single condition compared with training independently”.
Un modelo union necesita saber qué tipo de mapa recibe. SetUnionControlNetType lo fija, a partir de una lista de 8 tipos en control_types.py:
UNION_CONTROLNET_TYPES = { "openpose": 0, "depth": 1, "hed/pidi/scribble/ted": 2, "canny/lineart/anime_lineart/mlsd": 3, "normal": 4, "segment": 5, "tile": 6, "repaint": 7,}La página de documentación del nodo enumera 13 opciones, con nombres como canny, lineart y normalbae que el nodo no ofrece: las 12 condiciones del modelo comparten 8 posiciones, y varios detectores de bordes comparten una. El JSON del workflow debe usar los nombres del código, o el servidor rechaza el prompt.
Bordes, con el nodo Canny
Sección titulada «Bordes, con el nodo Canny»El núcleo de ComfyUI tiene pocos preprocesadores, los nodos que convierten una imagen en un mapa. El tutorial de ControlNet lo dice: “Since the current Comfy Core nodes do not include all types of preprocessors, in the actual examples in this documentation, we will provide pre-processed images.” Un esqueleto de pose, por ejemplo, necesita un nodo personalizado o una imagen hecha en otro sitio; los nodos personalizados son el tema de la lección 11. Los bordes están en el núcleo: Canny llama a la función canny de Kornia en la GPU:
output = canny(image[..., :3].to(device=comfy.model_management.get_torch_device(), dtype=torch.float32).movedim(-1, 1), low_threshold, high_threshold)Sus umbrales van de 0,01 a 0,99, en la escala de los valores de la imagen. El cv2.Canny de OpenCV, que usan la mayoría de las fichas de modelos, toma umbrales de 0 a 255: los valores 100 y 200 de una ficha son aquí unos 0,4 y 0,8, los valores por defecto del nodo.
Profundidad, con Lotus
Sección titulada «Profundidad, con Lotus»Un mapa de profundidad indica a qué distancia está cada píxel, y no dice nada de los bordes dentro de una superficie. ComfyUI v0.36.0 puede calcular uno sin nodo personalizado, con Lotus, un modelo derivado de Stable Diffusion 2 que predice la profundidad en un solo paso. LotusConditioning no tiene entradas: devuelve un embedding fijo, como explica el comentario del código, “lotus uses a frozen encoder and null conditioning, i’m just inlining the results”.
El workflow del curso copia los nodos de la plantilla de ComfyUI Image Depth Estimation (Lotus Depth): la imagen se codifica con el VAE de Stable Diffusion 1.x, se muestrea durante un paso sin ruido añadido y con el primer nivel de ruido fijado en 999, se decodifica, y después se invierte con ImageInvert para que lo cercano sea claro. Los tres archivos de la lección:
| Archivo | Tamaño | Licencia |
|---|---|---|
lotus-depth-d-v1-1.safetensors |
1,7 GB | Apache 2.0 |
vae-ft-mse-840000-ema-pruned.safetensors |
335 MB | MIT |
xinsir_controlnet_union_sdxl_promax.safetensors |
2,5 GB | Apache 2.0 |
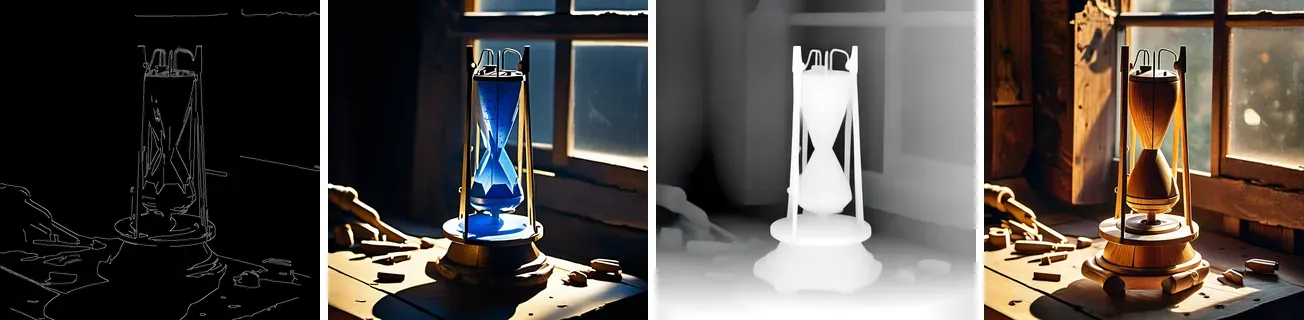
Renderizado por ComfyUI v0.36.0: Stable Diffusion XL base 1.0 con el ControlNet union SDXL ProMax de xinsir a strength 0,8, semilla 42, 25 pasos, CFG 7, euler, normal. De izquierda a derecha: los bordes de la imagen de la lección 1, Canny 0,4 y 0,8; el render de 06-canny.api.json, prompt “a metronome carved from blue ice on an old wooden workbench, morning light through a window, photograph”; el mapa de profundidad de Lotus; el render de 06-depth.api.json, prompt “a small robot made of polished wood on an old wooden workbench, morning light through a window, photograph”.
Los dos renders conservaron la silueta del objeto y su posición. El prompt pedía un metrónomo de hielo y un robot, y obtuvo la forma del objeto antiguo hecha de hielo y de madera: el mapa se impone a las palabras cuando no coinciden. Los bordes conservaron también los barrotes de la ventana y las herramientas del banco; el mapa de profundidad conservó el banco y la ventana como superficies, y dejó que el sampler inventara el resto de los detalles.
El primer render de cada workflow tardó 17,0 segundos, medidos por el cliente, la mayor parte en cargar el ControlNet, y Lotus en el workflow de profundidad. Los renders de Canny siguientes tardaron unos 7,0 segundos cada uno.
Intensidad, inicio y fin
Sección titulada «Intensidad, inicio y fin»strength escala los residuos del ControlNet. start_percent y end_percent indican cuándo está activo el ControlNet, pero no como fracción de los pasos. percent_to_sigma los convierte en niveles de ruido sobre los 1000 pasos de tiempo del entrenamiento del modelo:
def percent_to_sigma(self, percent): if percent <= 0.0: return 999999999.9 if percent >= 1.0: return 0.0 percent = 1.0 - percent return self.sigma(torch.tensor(percent * 999.0)).item()y get_control se salta el ControlNet cuando el nivel de ruido actual está fuera de ese rango. Para SDXL, un end_percent de 0,3 es el nivel de ruido 3,33. Con 25 pasos y el scheduler normal, los 8 primeros pasos empiezan por encima de él (14,6, 11,4, 9,08, 7,30, 5,95, 4,90, 4,09 y 3,44), así que el ControlNet guía 8 pasos de 25, no 7,5.
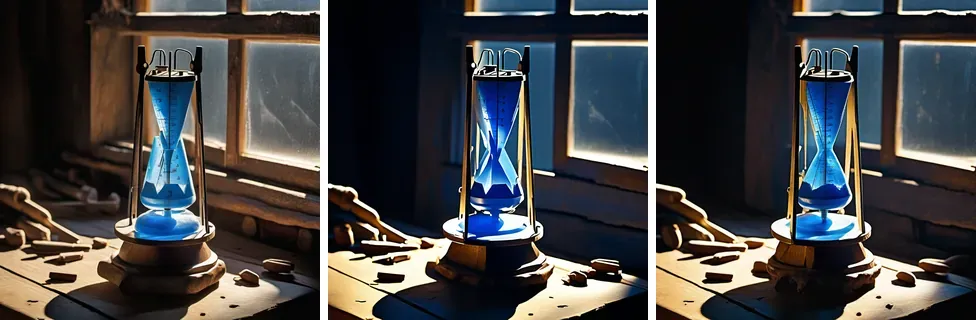
Renderizado por ComfyUI v0.36.0: Stable Diffusion XL base 1.0 con el ControlNet union SDXL ProMax de xinsir, semilla 42, 25 pasos, CFG 7, euler, normal, workflow 06-canny.api.json. De izquierda a derecha: strength 0,3, strength 1,0, y strength 0,8 con end_percent 0,3.
Dos observaciones sobre esta imagen, que quizá no valgan para otras:
- Con
strength0,3, la silueta del objeto sigue siendo la del mapa de bordes. La habitación a su alrededor se movió. - Detener el ControlNet tras 8 pasos no cambió casi nada. La composición se fija en los primeros pasos, los más ruidosos, como describió la lección 2; los pasos posteriores añaden detalle, y el mapa no tiene detalle que aportar.
Un start_percent tardío hace lo contrario: el prompt elige la composición, y el mapa solo la corrige. Por verificar: no se renderizó para esta lección.
Canny en la CI, y cuatro hashes distintos
Sección titulada «Canny en la CI, y cuatro hashes distintos»La CI ejecuta el nodo Canny en la CPU, sobre el patrón de prueba de 64 por 48 de la lección 5, con los umbrales 0,05 y 0,15. La primera ejecución comparaba su hash de píxeles como las salidas de los demás nodos, y falló en todos los sistemas operativos. Ahora la CI imprime el hash, y el número de píxeles más claros que 127, a título informativo:
| Máquina | SHA-256 de los píxeles | Píxeles de borde |
|---|---|---|
| la del autor, Windows 11 | 77af5cb1b7e93a5c |
464 de 3072 |
CI, ubuntu-latest |
bb92bc1020c06a83 |
467 de 3072 |
CI, macos-latest |
4db7c3194e9fe1e2 |
467 de 3072 |
CI, windows-latest |
8e3e55838a7c9d46 |
467 de 3072 |
El mismo ComfyUI, el mismo grafo de PyTorch y los mismos píxeles dieron cuatro imágenes distintas. Los tres runners encontraron el mismo número de píxeles de borde, pero no en los mismos sitios. Canny suaviza la imagen, calcula gradientes, adelgaza los bordes y los conserva comparando valores con umbrales. Un gradiente que queda justo por encima de un umbral en un cálculo en coma flotante y justo por debajo en otro añade o quita un píxel de borde, y cada CPU y cada biblioteca matemática redondean de forma un poco distinta. La lección 2 encontró el mismo tipo de diferencia en el ruido de dos dispositivos.
En qué paso dejan de coincidir
Sección titulada «En qué paso dejan de coincidir»data/canny-steps.py llama a las funciones de Kornia en el orden en que canny las aplica e imprime un hash por paso. Su patrón de 64 por 48 está construido con aritmética entera, así que la entrada son los mismos bytes en todas las máquinas: la primera fila de la tabla lo demuestra. check.sh lo ejecuta en las tres máquinas de la CI en cada commit; la primera columna es la del autor, cuyo PyTorch es la compilación CUDA, que aquí corre en la CPU.
| Paso | la del autor, 2.13.0+cu130 |
windows-latest, +cpu |
ubuntu-latest, +cpu |
macos-latest, 2.13.0 |
|---|---|---|---|---|
| entrada | 1907433ac4d80c9f |
1907433ac4d80c9f |
1907433ac4d80c9f |
1907433ac4d80c9f |
| desenfoque gaussiano | 769c45e000258c56 |
ee71eaac28f8cc27 |
ee71eaac28f8cc27 |
96d1452970dc7b72 |
| gradiente espacial | b06a49b51ebc7fa1 |
bf069945ff2cd851 |
17564ac6064fd8d8 |
5d47abc9d0ba75f4 |
| magnitud | 0af967b932bcb57c |
bda4e821a72c09ed |
208a0f39607e1ae0 |
bf05d8003b885379 |
| contornos | 08e9b5af22548246 |
08e9b5af22548246 |
08e9b5af22548246 |
08e9b5af22548246 |
La divergencia empieza en el primer paso en coma flotante. El desenfoque ya separa la máquina del autor de los runners, y el runner Apple Silicon de los dos x86. El gradiente difiere después en las cuatro, aunque Windows y Linux coincidían un paso antes: la misma convolución toma un camino distinto según la compilación. Todas las magnitudes difieren y, sin embargo, su suma se imprime como 2729.489258 en las cuatro: las diferencias están en los últimos bits. Esa suma es una trampa en sí misma: impresa con seis decimales suma las diferencias y las borra, de modo que quien comparara sumas habría concluido que las cuatro máquinas coinciden y se habría detenido ahí. Un total no es un hash. Por eso todas las comprobaciones de este curso hashean bytes.
La precisión es la otra mitad de la historia. La sonda de Hadamard de la lección 8 corre en las mismas tres máquinas de la CI y calcula en float64: imprime los mismos cinco decimales en las tres, 0.05674 y 0.00761, y solo se mueve su cota de exactitud, entre 1,11e-14 y 1,20e-14. La divergencia no es una fatalidad: depende de la precisión con la que se trabaja, y la difusión trabaja en float32 o más estrecho.
La última fila es la sorpresa: los contornos son idénticos en todas partes, 1461 píxeles de 3072, el mismo hash en las cuatro máquinas. Este patrón son áreas planas y bordes duros, así que ningún gradiente queda lo bastante cerca de un umbral como para que una diferencia de último bit lo haga saltar. Un render no tiene ese margen, y por eso el patrón de la lección 5, pasado por Canny dentro de ComfyUI, da cuatro hashes. La respuesta tiene entonces dos mitades: la coma flotante diverge desde la primera convolución, en todas las máquinas, siempre; que eso llegue a la salida depende de cuántos píxeles deje la imagen cerca del umbral.
Puntos clave
Sección titulada «Puntos clave»- Un ControlNet es una copia entrenada del codificador de la UNet. Sus salidas, multiplicadas por
strength, se suman a las activaciones de la UNet, y los ControlNets encadenados se suman entre sí. - Un ControlNet union necesita
SetUnionControlNetType, con los nombres de tipo del código de ComfyUI, no los de su documentación. - El núcleo tiene
Cannypara los bordes y Lotus para la profundidad. Los demás mapas necesitan un nodo personalizado o una imagen hecha en otro sitio. start_percentyend_percentson fracciones del rango de ruido, no de los pasos.- La composición se decide en los primeros pasos: un ControlNet activo solo en ellos conservó casi toda la composición.
- Los filtros de imagen también son código en coma flotante: no compares su salida bit a bit entre máquinas. La divergencia empieza en la primera convolución; que llegue a la salida depende de lo cerca que la imagen quede del umbral.
- Un total no es un hash: una suma agrega las diferencias que un hash mostraría.
Tu turno
Sección titulada «Tu turno»Dibuja tú mismo una disposición tosca — tres cajas y un horizonte en cualquier editor de imágenes — y úsala como imagen de control. Pásala por Canny con dos pares de umbrales, luego recorre strength de 0,2 a 1,2 y encuentra el valor en el que tu disposición deja de respetarse. Termina con end_percent en 0,3: la composición debe aguantar mientras el detalle se va por su cuenta.
Ejercicios
Sección titulada «Ejercicios»- Los umbrales de
Cannyde una ficha de modelo son 50 y 150, para OpenCV. ¿Qué valores van en el nodo? - Encadena los ControlNets de Canny y de profundidad, cada uno con
strength0,5, en un mismo workflow. ¿Qué nodos cambian, y qué reciben como entrada los dos nodosControlNetApplyAdvanced? - Con 25 pasos, el scheduler
normaly SDXL, ¿cuántos pasos guía un ControlNet constart_percent0,5 yend_percent1,0? Usa la lista de niveles de ruido de esta lección y el hecho de quepercent_to_sigma(0.5)vale 1,616.
Solución 1
Los valores del nodo están en la escala de 0 a 1 de los píxeles de la imagen: 50 / 255 es aproximadamente 0,2, y 150 / 255 aproximadamente 0,59. Por verificar: esto supone que la imagen de la ficha era de 8 bits y que los umbrales de Kornia comparan las mismas magnitudes de gradiente que los de OpenCV, algo que esta lección no ha medido.
Solución 2
Carga el ControlNet una sola vez, y dáselo a dos nodos SetUnionControlNetType, uno con canny/lineart/anime_lineart/mlsd y otro con depth. El primer ControlNetApplyAdvanced recibe el condicionamiento de los prompts, los bordes de Canny y strength 0,5. El segundo recibe las salidas del primero como positive y negative, el mapa de profundidad y strength 0,5. KSampler recibe las salidas del segundo. Por verificar: no se renderizó para esta lección.
Solución 3
El ControlNet se salta mientras el nivel de ruido esté por encima de percent_to_sigma(0.5), 1,616, y un end_percent de 1,0 se convierte en 0, así que nunca se detiene. En la lista, los 13 últimos pasos empiezan en 1,616 o por debajo: 1,616, 1,408, 1,228, 1,071, 0,932, 0,808, 0,695, 0,591, 0,494, 0,400, 0,306, 0,203 y 0,029. El ControlNet guía 13 pasos de 25, después de que los 12 primeros hayan elegido la composición.
El nivel del paso 13 es exactamente 1,616 en la doble precisión de Python, porque el scheduler normal sitúa los pasos en pasos de tiempo espaciados uniformemente y 0,5 cae en uno de ellos. La comparación es sigma > 1.616, así que ese paso se incluye. Por verificar: el sampler compara un tensor de PyTorch, cuya precisión puede hacer que el paso caiga del otro lado.
Fuentes
Sección titulada «Fuentes»- L. Zhang, A. Rao, M. Agrawala, Adding Conditional Control to Text-to-Image Diffusion Models, 2023.
- J. He et al., Lotus: Diffusion-based Visual Foundation Model for High-quality Dense Prediction, 2024.
- Documentación de ComfyUI: tutorial de ControlNet, combinar ControlNets,
SetUnionControlNetType,Canny,LotusConditioning. - ComfyUI en la v0.36.0:
nodes.py,comfy/controlnet.py,comfy/cldm/control_types.py,comfy_extras/nodes_canny.py,comfy_extras/nodes_lotus.py,comfy/model_sampling.py. - Fichas de los modelos: xinsir/controlnet-union-sdxl-1.0, Comfy-Org/lotus, jingheya/lotus-depth-d-v1-1, stabilityai/sd-vae-ft-mse-original.