8. Modelos recientes y sus licencias, cuantización y VRAM
Secciones
Ajustes de lectura
Ninguna voz para este idioma en este navegador.
Más voces
Código y términos técnicos en inglés
Desactivado: la voz de la página lo lee todo, sin pausa entre dos voces.
Ninguna voz para este idioma en este navegador.
Más voces
Más voces: Microsoft Edge ofrece voces naturales en línea, y Windows (Configuración › Hora e idioma › Voz), macOS y Android instalan otras.
Código: los workflows 08-z-image-turbo.api.json y 08-flux2-klein.api.json; el lector de cabeceras en csharp/Safetensors.cs.
SDXL salió en julio de 2023, y los modelos de 2025 y 2026 están construidos de otra forma. Su red de eliminación de ruido es un transformer en lugar de una UNet, entrenado con flow matching, que aprende un camino recto del ruido a la imagen. Un modelo de lenguaje lee el prompt en lugar de CLIP. Y son más grandes. Esta lección ejecuta dos de ellos que son libres para uso comercial, lee sus licencias y sus archivos, y los hace caber en 16 GB.
Dos modelos
Sección titulada «Dos modelos»| Z-Image-Turbo | FLUX.2 klein 4B | |
|---|---|---|
| Creador | Tongyi-MAI, en Alibaba | Black Forest Labs |
| Red de eliminación de ruido | 6.000 millones de parámetros, un “Scalable Single-Stream DiT” | 4.000 millones de parámetros, un “rectified flow transformer” |
| Codificador de texto | Qwen3 4B | Qwen3 4B, el mismo archivo |
| Pasos y CFG | 8 pasos, CFG 1 | 4 pasos, CFG 1, para el modelo destilado |
| Licencia | Apache 2.0 | Apache 2.0 |
| Archivos para ComfyUI | Comfy-Org/z_image_turbo | Comfy-Org/flux2-klein-4B |
Los dos están destilados, como los LoRAs de la lección 7. Z-Image-Turbo “matches or exceeds leading competitors with only 8 NFEs”, 8 evaluaciones de la red, y su ficha dice que “fits comfortably within 16G VRAM consumer devices”. La ficha de klein dice “Runs on consumer GPUs (~13GB VRAM)”. El codificador de texto Qwen3 4B es el mismo archivo de 8,0 GB en los dos repositorios de Comfy-Org, con el mismo SHA-256.
Sus grafos
Sección titulada «Sus grafos»Los workflows copian la plantilla de ComfyUI Text to Image (Z-Image-Turbo), y la rama destilada de la plantilla que usa el tutorial de FLUX.2 klein. No hay archivo de checkpoint: cada parte tiene su propio cargador.
| Papel | Z-Image-Turbo | FLUX.2 klein 4B |
|---|---|---|
| Red de eliminación de ruido | UNETLoader, y después ModelSamplingAuraFlow con shift 3 |
UNETLoader |
| Codificador de texto | CLIPLoader, tipo lumina2 |
CLIPLoader, tipo flux2 |
| Prompt negativo | ConditioningZeroOut del positivo |
un CLIPTextEncode vacío |
| Latente vacío | EmptySD3LatentImage |
EmptyFlux2LatentImage |
| Muestreo | KSampler, 8 pasos, CFG 1, res_multistep, simple |
SamplerCustomAdvanced con RandomNoise, CFGGuider a CFG 1, KSamplerSelect euler, y Flux2Scheduler con 4 pasos |
| VAE | ae.safetensors, guardado aquí como z_image_ae.safetensors |
flux2-vae.safetensors |
Aquí CLIPLoader carga un modelo de lenguaje. En los nombres de los nodos de ComfyUI, “CLIP” designa ahora cualquier codificador de texto, y type indica a ComfyUI cómo usarlo. Con CFG 1, el prompt negativo nunca se evalúa (lección 2), y por eso los dos grafos le dan un condicionamiento vacío o puesto a cero. shift desplaza la planificación de un modelo de flujo hacia el extremo ruidoso: time_snr_shift transforma un tiempo t en 3t / (1 + 2t), así que la mitad de la planificación, t = 0,5, se convierte en un nivel de ruido de 0,75.
Licencias
Sección titulada «Licencias»La licencia de un modelo es la licencia de una dependencia. Dice lo que puedes hacer con los pesos, y a veces con las imágenes, y varía más que en el código:
| Modelo | Licencia | Qué dice |
|---|---|---|
| SDXL base 1.0 | CreativeML Open RAIL++-M | uso abierto, con una lista de usos prohibidos que debe transmitirse con el modelo |
| Pixel Art XL, lección 7 | CreativeML Open RAIL-M | la misma idea, en su versión anterior |
| Stable Diffusion 3.5 Large | Stability AI Community License | “Free for research, non-commercial, and commercial use for organizations or individuals with less than $1M in total annual revenue.” |
| FLUX.1 dev | FLUX.1 dev Non-Commercial License | los pesos para uso no comercial, pero “Generated outputs can be used for personal, scientific, and commercial purposes” |
| FLUX.1 schnell | Apache 2.0 | “can be used for personal, scientific, and commercial purposes” |
| Qwen-Image | Apache 2.0 | “Qwen-Image is licensed under Apache 2.0.” |
| Z-Image-Turbo | Apache 2.0 | |
| FLUX.2 klein 4B | Apache 2.0 | “Open weights available for commercial use” |
| FLUX.2 klein 9B | FLUX Non-Commercial License | según la ficha del 4B: “Filters or manual review must be used with the FLUX.2 [klein] 9B models under the terms of the FLUX Non-Commercial License” |
En esta tabla se ven tres trampas. La licencia puede cambiar dentro de una familia: klein 4B y klein 9B no comparten la misma. Puede depender de quién seas, como con el umbral de ingresos de Stability AI. Y un archivo reempaquetado, como los de Comfy-Org, está sujeto a la licencia del modelo original, que se lee en la ficha original. El curso leyó cada ficha al descargar el archivo, y su informe enumera cada archivo con su licencia y su SHA-256. Esto no es asesoramiento jurídico: lee la propia licencia antes de publicar nada.
Leer la licencia antes de publicar una salida
Sección titulada «Leer la licencia antes de publicar una salida»Una licencia puede restringir dónde pueden verse sus salidas, y no solo qué haces con los pesos. Este curso lo aprendió por las malas, con los modelos de imagen a 3D; el diario cuenta el episodio.
ComfyUI v0.36.0 ejecuta Hunyuan3D 2 con los nodos del núcleo. Su licencia, la Tencent Hunyuan 3D 2.0 Community License, empieza así:
THIS LICENSE AGREEMENT DOES NOT APPLY IN THE EUROPEAN UNION, UNITED KINGDOM AND SOUTH KOREA AND IS EXPRESSLY LIMITED TO THE TERRITORY, AS DEFINED BELOW.
(«Este contrato de licencia no se aplica en la Unión Europea, el Reino Unido ni Corea del Sur, y se limita expresamente al Territorio, tal como se define más abajo».) La cláusula 1.l define el Territorio: «the worldwide territory, excluding the territory of the European Union, United Kingdom and South Korea.», el territorio mundial excluyendo la Unión Europea, el Reino Unido y Corea del Sur. La cláusula 5.c va más lejos:
You must not use, reproduce, modify, distribute, or display the Tencent Hunyuan 3D 2.0 Works, Output or results of the Tencent Hunyuan 3D 2.0 Works outside the Territory. Any such use outside the Territory is unlicensed and unauthorized under this Agreement.
(«No debes usar, reproducir, modificar, distribuir ni mostrar las Obras Tencent Hunyuan 3D 2.0, sus Salidas o sus resultados fuera del Territorio. Cualquier uso de este tipo fuera del Territorio no está licenciado ni autorizado por este contrato».) La licencia de Hunyuan3D 2.1 tiene las mismas cláusulas. Tres consecuencias para un sitio público:
- Estar uno mismo en el Territorio no basta. Generar una malla desde un país del Territorio está permitido. Ponerla en un sitio web no es un uso limitado a ese país: una página pública se muestra también en la Unión Europea, el Reino Unido y Corea del Sur.
- Un render es una salida. «Output or results» cubre más que el archivo
.glb: una imagen giratoria de la malla, renderizada en Blender, sigue mostrando el resultado. - Una licencia es un archivo con fecha. Léela en una revisión fijada y guarda su huella. El curso lee la licencia de Hunyuan3D 2.0 en el commit
9cd649ba, SHA-256eca02cc10abaf520…. Algunas licencias cambian por sí solas: la de DINOv3, fechada el 19 de agosto de 2025, dice en su cláusula 8 que «Your continued use of the DINO Materials after any modification to this Agreement constitutes your agreement to such modification.», que seguir usando los DINO Materials tras una modificación equivale a aceptarla.
El curso comparó tres maneras de obtener el modelo 3D de un objeto pequeño para sus páginas:
| Hunyuan3D 2.0 o 2.1, en ComfyUI | TRELLIS.2 4B, en ComfyUI | Modelado procedural con bpy en Blender |
|
|---|---|---|---|
| Licencia | Tencent Hunyuan 3D Community License: no en la UE, el Reino Unido ni Corea del Sur, salidas no mostradas en esos territorios, solicitud a Tencent por encima de un millón de usuarios activos mensuales | MIT, pero su codificador de imagen es DINOv3, bajo la DINOv3 License: citar DINOv3 en una publicación (1.b.ii), entregar una copia de la licencia con los pesos (1.b.i), aceptar los cambios futuros al seguir usándolos (8) | Blender es GPL, y su página de licencia dice «What you create with Blender is your sole property.»: lo que creas con Blender es tuyo |
| RAM y VRAM libres en esta máquina | 19 GB de RAM libre para la 2.0 con SDXL; 9,4 GB de VRAM medidos durante el muestreo | unos 23 GB de RAM libre para el modelo int8 con SDXL; el README original pide «at least 24GB» de VRAM, y 16 GB queda por verificar | no necesita GPU |
| Calidad observada | 890 140 y 1 017 760 triángulos para dos objetos simples, 19 084 y 189 748 aristas no manifold, sin UV ni textura, un reverso inventado, detalle pintado leído como relieve, y la línea del suelo de la imagen convertida en una losa | no probado | 3370 triángulos para el metrónomo y 5950 para el gramófono, ninguna arista no manifold al releer el glTF exportado, piezas con nombre, materiales separados y animaciones, con unas 510 líneas de modelado y 120 más que las verifican en cada commit; el detalle se detiene donde se detiene el código |
| Publicable en este sitio | no | sí, citando DINOv3 | sí |
El paquete TRELLIS.2 de Comfy-Org está etiquetado como MIT y distribuye clip_vision/dino_v3_vit_l.safetensors sin una copia de la DINOv3 License. La licencia del archivo se aplica igualmente: un reempaquetado no la cambia. Esto no es asesoramiento legal.
Qué hay dentro de un archivo cuantizado
Sección titulada «Qué hay dentro de un archivo cuantizado»Los 6.000 millones de parámetros de Z-Image-Turbo ocupan 12,3 GB en bf16, 2 bytes cada uno, y el codificador de texto Qwen3 ocupa 8,0 GB más: 20,3 GB, para una tarjeta de 16 GB. Comfy-Org publica los dos en formatos más pequeños. La herramienta del curso lee sus cabeceras:
> comfy safetensors-info z_image_turbo_bf16.safetensorsz_image_turbo_bf16.safetensors: header 48920 bytes, 453 tensors, 12.31 GB of tensor data  BF16       453 tensors,  12.31 GB
> comfy safetensors-info z_image_turbo_int8_convrot.safetensorsz_image_turbo_int8_convrot.safetensors: header 91000 bytes, 857 tensors, 6.20 GB of tensor data  I8         202 tensors,   6.14 GB  F32        453 tensors,   58.9 MB  U8         202 tensors, 14544 bytesquantized layers (.comfy_quant): 202  202 x {"format": "int8_tensorwise", "convrot": true, "convrot_groupsize": 256}
> comfy safetensors-info z_image_turbo_nvfp4.safetensorsz_image_turbo_nvfp4.safetensors: header 113080 bytes, 993 tensors, 4.51 GB of tensor data U8 180 tensors, 2.71 GB BF16 273 tensors, 1.46 GB F8_E4M3 180 tensors, 0.34 GB F32 360 tensors, 1440 bytesquantized layers (_quantization_metadata): 180 nvfp4- int8: 202 capas guardan un byte con signo por peso, más una escala
F32por capa: el peso es aproximadamente la escala multiplicada por el byte. Cada una de estas capas tiene también un tensorU8diminuto llamadocomfy_quant, que contiene su formato en JSON. El indicadorconvroty su tamaño de grupo de 256 seleccionan una variante cuyos kernels,quantize_int8_convrot_weightydequantize_int8_convrot_weight, están en comfy-kitchen, la biblioteca de cuantización de ComfyUI. El kernel ya se ha leído, en comfy-kitchen 0.2.34. La rotación es una matriz de Hadamard regular: las potencias de Kronecker de un bloque 4 × 4 simétrico, divididas por la raíz cuadrada de su tamaño, y por eso el tamaño de grupo tiene que ser una potencia de 4 (tensor/int8_utils.py). Cada grupo de 256 canales de entrada se rota con ella: el peso una vez, fuera de línea, comoW @ H.T, y las activaciones en cada llamada, comox @ H, fusionado en el cuantizador por filas (backends/cuda/__init__.py). Esa matriz es simétrica y ortogonal, así que es su propia inversa: las dos rotaciones se cancelan y la capa calcula el mismo producto. Lo que cambia es lo que el int8 tiene que contener.data/convrot.pyreconstruye la misma matriz —idéntica a la de comfy-kitchen con tamaños de grupo 16, 64 y 256— y cuantiza un peso en el que cada fila tiene un canal cuarenta veces mayor que los demás: el error de ida y vuelta por filas es del 5,7 % sin la rotación y del 0,76 % con ella, siete veces y media menor. La rotación mezcla el valor atípico con todo su grupo, de modo que la única escala de la fila ya no tiene que cubrirlo sola. - nvfp4: 180 capas guardan 4 bits por peso, dos por byte, en
U8. El formato NVFP4 de NVIDIA tiene “1 sign bit, 2 exponent bits, and 1 mantissa bit”: 16 valores posibles. Cada bloque de 16 pesos tiene su propia escala de 8 bits enF8_E4M3, y por eso 2,71 GB de pesos vienen con 0,34 GB de escalas, y cada capa tiene dos escalaresF32. Aquí el formato no se guarda en tensores por capa, sino en la entrada_quantization_metadatade la cabecera. - Los tensores
BF16del archivo nvfp4 no son solo pequeños pesos de normalización. Leer sus nombres muestra que los 30 bloques principales están cuantizados, pero los cuatro bloques refiner, que procesan primero la imagen y el texto, se quedan enteros en bf16: 1,43 GB de los 1,46 GB.
Los archivos más pequeños del codificador de texto mezclan formatos, algo que sus nombres solo dicen a medias:
> comfy safetensors-info qwen_3_4b_fp8_mixed.safetensorsqwen_3_4b_fp8_mixed.safetensors: header 87608 bytes, 788 tensors, 5.63 GB of tensor data  BF16       209 tensors,   3.27 GB  F8_E4M3    189 tensors,   2.33 GB  U8         201 tensors,   31.5 MB  F32        189 tensors, 756 bytesquantized layers (.comfy_quant): 189  177 x {"format": "float8_e4m3fn"}  12 x {"format": "nvfp4"}
> comfy safetensors-info qwen_3_4b_fp4_mixed.safetensorsqwen_3_4b_fp4_mixed.safetensors: header 121208 bytes, 1081 tensors, 3.48 GB of tensor data  F8_E4M3    247 tensors,   1.24 GB  U8         436 tensors,   1.21 GB  BF16       151 tensors,   1.03 GB  F32        247 tensors, 988 bytesquantized layers (.comfy_quant): 247  189 x {"format": "nvfp4"}  58 x {"format": "float8_e4m3fn"}
El archivo “fp8” tiene 12 capas nvfp4, y el archivo “fp4” conserva 58 capas en fp8. float8_e4m3fn es un byte por peso con 4 bits de exponente y 3 bits de mantisa, y una escala por capa. En una GPU sin kernels fp4, el archivo “fp8” tampoco es, por tanto, del todo nativo.
Tres formas de escribir los mismos números pasan por un único cargador. convert_old_quants convierte la entrada de la cabecera en tensores comfy_quant cuando se carga el archivo, y pick_operations da después al modelo las capas de precisión mixta de ComfyUI.
Nativo o emulado
Sección titulada «Nativo o emulado»Un formato solo es rápido en una GPU que tiene kernels para él. get_disabled_quant_formats consulta a model_management.py sobre el dispositivo:
| Formato | Nativo en | En otros casos |
|---|---|---|
float8_e4m3fn, float8_e5m2 |
NVIDIA con compute capability 8.9 o superior: serie RTX 40 y posteriores | emulado |
nvfp4 |
NVIDIA con compute capability 10 o superior: serie RTX 50 | emulado |
int8_tensorwise |
cualquier dispositivo salvo MPS de Apple, Intel XPU y DirectML | emulado |
Emulado no significa rechazado. La capa se marca con _full_precision_mm, y en cada pasada hacia delante su peso se descuantiza al tipo de cálculo, y después se multiplica como de costumbre:
if self._full_precision_mm and isinstance(weight, QuantizedTensor): weight = weight.dequantize()return self._forward(input, weight, bias)El archivo sigue siendo pequeño, en disco y en memoria, y el cálculo cuesta más que en bf16. El servidor escribe su elección en el log cuando se carga un modelo. En la RTX 5080 del autor, con compute capability 12.0 y PyTorch compilado para CUDA 13.0, todos los formatos eran nativos:
Using mixed precision operationsNative ops: asym_w4a8_int8, float8_e5m2, convrot_w4a4, float8_e4m3fn, mxfp8, nvfp4, int8_tensorwisePor verificar: la ruta emulada en una GPU más antigua; la máquina del curso no tiene ninguna.
Caber en 16 GB
Sección titulada «Caber en 16 GB»La VRAM dinámica
Sección titulada «La VRAM dinámica»Los pesos de Z-Image-Turbo en bf16 y de su codificador de texto no caben en 16 GB, y aun así el workflow se ejecutó. En la v0.36.0 sobre NVIDIA, ComfyUI gestiona la memoria con la VRAM dinámica, activada por defecto: main.py sustituye el patcher del modelo por ModelPatcherDynamic cuando PyTorch es la 2.8 o posterior. Cada modelo se prepara por etapas: sus pesos se quedan en la memoria del sistema, y van a la GPU a medida que el cálculo los necesita, dentro de la memoria que está libre. El log da el tamaño preparado de cada modelo:
Model ZImageTEModel_ prepared for dynamic VRAM loading. 7671MB Staged. 0 patches attached. Force pre-loaded 145 weights: 383 KB.Model Lumina2 prepared for dynamic VRAM loading. 11738MB Staged. 0 patches attached. Force pre-loaded 205 weights: 1045 KB.Esto cambia lo que te dice nvidia-smi. El pico de memoria de la GPU estuvo entre 12,5 y 15,3 GB en todas las configuraciones siguientes, con 2,4 a 2,8 GB ya usados por otros programas: ComfyUI llena lo que está libre, sea cual sea el tamaño del modelo. Los tamaños preparados y la velocidad muestran la diferencia.
Un servidor por configuración, tres renders cada uno: la semilla 42 en un servidor recién arrancado, y después las semillas 43 y 44 con los modelos cargados. El prompt es el de la lección 1, a 1024 por 1024 píxeles. Los tiempos son las líneas “Prompt executed” del servidor, y la velocidad son los pasos por segundo del sampler en los renders en caliente.
| Red de eliminación de ruido | Codificador de texto | Preparado, red + codificador | Primer render | Renders en caliente | Pasos por segundo |
|---|---|---|---|---|---|
| Z-Image-Turbo bf16 | Qwen3 bf16 | 11.738 + 7.671 MB | 63,93 s | 8,72 s, 5,93 s | 1,5 |
| Z-Image-Turbo int8 convrot | Qwen3 fp8 mixed | 5.888 + 5.370 MB | 37,42 s | 3,03 s, 3,05 s | 3,1 |
| Z-Image-Turbo nvfp4 | Qwen3 fp4 mixed | 4.299 + 3.317 MB | 28,06 s | 2,68 s, 2,79 s | 3,7 |
| Z-Image-Turbo nvfp4 | Qwen3 bf16 | 4.299 + 7.671 MB | 32,32 s | 2,41 s, 2,50 s | 4,1 |
| FLUX.2 klein 4B bf16, 4 pasos | Qwen3 bf16 | 7.392 + 7.671 MB | 32,26 s | 2,00 s, 2,39 s | 3,5 |
El primer render incluye la lectura de los archivos desde un SSD externo, y es sobre todo carga. Los renders en caliente muestran los formatos. bf16 iba a la mitad de velocidad que int8: 11,7 GB de red, más la memoria de trabajo de una imagen de 1024 por 1024, no cabían junto a los demás programas, así que algunos pesos se movían a la GPU en cada paso. int8 y nvfp4 cabían, y los kernels de nvfp4 fueron los más rápidos. La red nvfp4 también fue más rápida con el codificador de texto bf16 que con el fp4, 4,1 pasos por segundo frente a 3,7. Por verificar: el curso no tiene explicación para ello, ya que el codificador de texto no se usa durante el muestreo.
Un modo que carga los modelos enteros no se pudo medir en esta máquina. Con --disable-dynamic-vram, ComfyUI estima la memoria que necesita y carga cada modelo por completo. El primer render tardó 78,87 segundos, y sus píxeles eran idénticos a los del render con VRAM dinámica con la misma semilla. Durante el segundo render, la máquina, con 64 GB de RAM compartidos con otro trabajo, se quedó sin memoria, y la ejecución se detuvo. Eso ya es un resultado: la VRAM dinámica es lo que permite ejecutar un modelo de 20 GB junto a otros programas.
Lo que cambió la cuantización
Sección titulada «Lo que cambió la cuantización»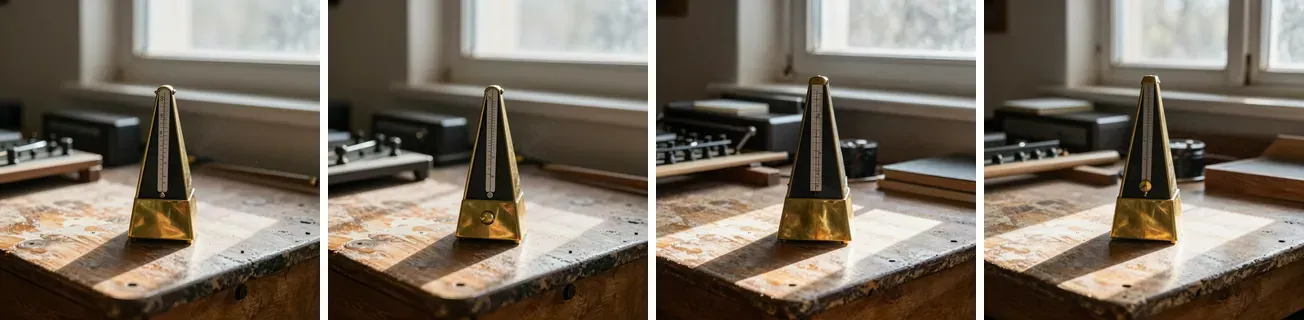
Renderizado por ComfyUI v0.36.0: Z-Image-Turbo, semilla 42, 8 pasos, CFG 1, res_multistep, simple, shift 3, prompt “a brass metronome on an old wooden workbench, morning light through a window, dust in the air, photograph”, workflow 08-z-image-turbo.api.json. De izquierda a derecha: red bf16 con el codificador de texto bf16; int8 convrot con fp8 mixed; nvfp4 con fp4 mixed; nvfp4 con bf16.
Comparado píxel a píxel con el render bf16 de la misma semilla:
| Configuración | Semilla 42 | Semilla 43 | Semilla 44 |
|---|---|---|---|
| int8 + fp8 mixed | media 3,96, un 13,13 % de los píxeles en más de 8 | media 3,27, 9,49 % | media 4,78, 15,33 % |
| nvfp4 + fp4 mixed | media 23,80, 71,98 % | media 24,31, 66,18 % | media 30,50, 74,48 % |
| nvfp4 + bf16 | media 27,10, 71,35 % | media 28,74, 72,73 % | media 18,54, 62,58 % |
int8 dio la misma imagen, con pequeñas diferencias de textura. nvfp4 dio otra imagen de la misma escena: los objetos se movieron, y cambiaron unas tres cuartas partes de los píxeles. La precisión del codificador de texto también influyó: nvfp4 con el codificador fp4 y con el codificador bf16 diferían en una media de 20 a 23 niveles. Ninguna de estas imágenes es incorrecta, y distinta no significa peor. Un modelo cuantizado es otro modelo, cercano al original, y una semilla elegida con uno no se traslada al otro.
FLUX.2 klein
Sección titulada «FLUX.2 klein»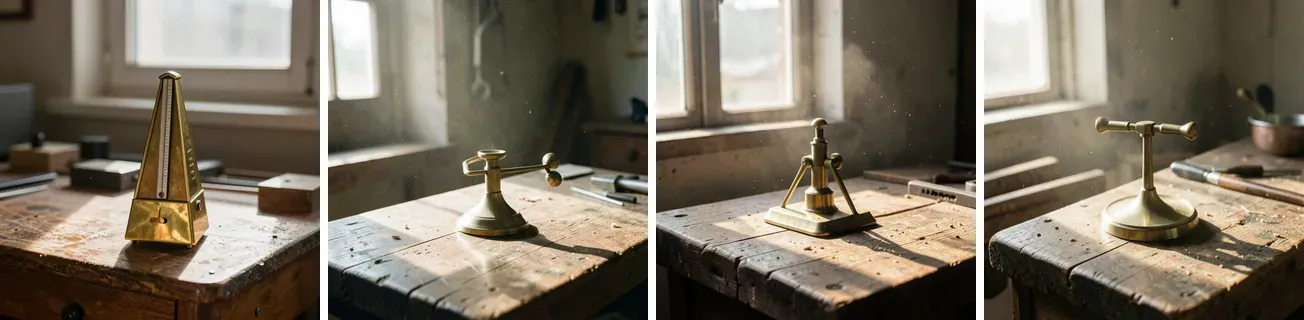
Renderizado por ComfyUI v0.36.0. Primero: Z-Image-Turbo bf16, semilla 43, con los ajustes de arriba. Después: FLUX.2 klein 4B destilado, bf16, con el codificador de texto Qwen3 4B, semillas 42, 43 y 44, 4 pasos, CFG 1, euler, Flux2Scheduler, el mismo prompt, workflow 08-flux2-klein.api.json.
Con el mismo prompt, Z-Image-Turbo dibujó un metrónomo con cada semilla, y klein 4B dibujó tres veces un soporte de latón, en una escena que encaja bien con el resto del prompt. El SDXL de la lección 1 dibujó algo parecido a un reloj de arena. Reconocer un objeto por su nombre es donde más difirieron los modelos con este prompt, pero tres semillas no son un benchmark.
GGUF y --lowvram
Sección titulada «GGUF y --lowvram»Las guías escritas para versiones antiguas de ComfyUI suelen recomendar archivos GGUF, el formato de llama.cpp, y la opción --lowvram. En la v0.36.0, ninguno de los dos es la vía por defecto. El núcleo de ComfyUI no tiene cargador GGUF: ComfyUI-GGUF es un nodo personalizado, y su README dice “Simply use the GGUF Unet loader found under the bootleg category.” El propio aviso de arranque de ComfyUI, que se imprime con --disable-dynamic-vram, lo desaconseja: “If you use gguf we recommend keeping dynamic vram enabled and using native ComfyUI model formats instead. ComfyUI native formats like fp8, int8 and w4a8 will be faster even if they are larger than your memory.” Y la ayuda de --lowvram dice: “Doesn’t do anything if dynamic vram is enabled.”
Puntos clave
Sección titulada «Puntos clave»- Los modelos recientes se dividen en un transformer de eliminación de ruido, un codificador de texto basado en un modelo de lenguaje y un VAE, cada uno con su propio cargador, y a menudo están destilados a unos pocos pasos con CFG 1.
- Lee la licencia en la ficha del modelo original, para el modelo y el tamaño exactos: klein 4B está bajo Apache 2.0, klein 9B no.
- La cabecera de un archivo cuantizado dice lo que contiene: capas int8 y nvfp4 con sus escalas, capas que se quedan en bf16, y formatos mezclados en un mismo archivo, diga lo que diga su nombre.
- Un formato solo se ejecuta de forma nativa en las GPUs que tienen sus kernels. En las demás, ComfyUI descuantiza en cada paso: el archivo sigue siendo pequeño, y se pierde la velocidad.
- La VRAM dinámica, activada por defecto en NVIDIA, ejecuta modelos más grandes que la GPU.
nvidia-smimuestra entonces lo que está libre, no lo que necesita el modelo, y--lowvramno hace nada. - Aquí, int8 mantuvo la imagen cerca de la de bf16; nvfp4 hizo otra imagen de la misma escena, al doble de la velocidad de bf16.
Tu turno
Sección titulada «Tu turno»Elige un modelo que de verdad pienses usar y haz las dos lecturas que hace esta lección. Lee su cabecera y cuenta los bytes por formato: cuánto hay en int8 o en fp4, cuánto se quedó en bf16 y cuánto se aleja el archivo del tamaño que sugiere su nombre. Lee después su licencia en la ficha del modelo original, para el tamaño exacto que descargaste — no para la familia — y decide antes de generar si lo que salga podrá publicarse donde piensas publicarlo.
Ejercicios
Sección titulada «Ejercicios»- Una red de 4.000 millones de parámetros se guarda en bf16, luego en int8 con una escala por capa, y luego en nvfp4 con todos los pesos cuantizados. Estima el tamaño de cada archivo.
- Ejecutas
z_image_turbo_nvfp4.safetensorsen una RTX 4090, con compute capability 8.9. ¿Qué enumera la línea “Native ops” del log, y qué les pasa a las capas nvfp4? - Un cliente quiere imágenes de producto para una tienda en línea, renderizadas con FLUX.2 klein. ¿Qué modelo klein puedes usar, y qué compruebas primero?
Solución 1
bf16 son 2 bytes por peso: unos 8 GB. int8 es 1 byte: unos 4 GB, más unos pocos escalares. nvfp4 es medio byte por peso, más una escala de 1 byte por bloque de 16 pesos, 1/16 de byte por peso: unos 4 × 0,5625 = 2,25 GB. Los archivos reales son más grandes, porque capas como las normalizaciones, los embeddings y, en el caso de Z-Image-Turbo, los bloques refiner se quedan en bf16: el archivo bf16 de klein 4B ocupa 7,75 GB, y el archivo nvfp4 de Z-Image-Turbo conserva 1,46 GB en bf16.
Solución 2
supports_nvfp4_compute exige una compute capability de 10 o superior, así que nvfp4 pasa a la lista de emulados: la línea enumera como nativos float8_e4m3fn, float8_e5m2, int8_tensorwise y los demás formatos, y nvfp4 aparece después de “emulated ops”. El modelo se carga, y cada capa nvfp4 se descuantiza a bf16 en cada pasada hacia delante: se mantiene el ahorro de memoria, y se pierde la velocidad de los kernels fp4. Por verificar: la máquina del curso no tiene ninguna GPU de la serie RTX 40; esto se deduce del código.
Solución 3
klein 4B, bajo Apache 2.0, permite el uso comercial; klein 9B está bajo la FLUX Non-Commercial License. Comprueba la licencia en la ficha de Black Forest Labs para el archivo exacto que descargas, incluido uno reempaquetado, y guarda constancia de ella junto con el hash del archivo. Después comprueba lo que dice la licencia sobre las salidas del modelo, y las propias normas de la tienda sobre imágenes generadas. Esto no es asesoramiento jurídico.
Fuentes
Sección titulada «Fuentes»- Z-Image Team, Z-Image: An Efficient Image Generation Foundation Model with Single-Stream Diffusion Transformer, 2025.
- NVIDIA, Introducing NVFP4 for Efficient and Accurate Low-Precision Inference, 2025.
- Documentación de ComfyUI: Z-Image-Turbo, FLUX.2 klein.
- ComfyUI en la v0.36.0:
QUANTIZATION.md,comfy/ops.py,comfy/quant_ops.py,comfy/model_management.py,comfy/utils.py,comfy/cli_args.py,main.py. - Fichas de los modelos: Tongyi-MAI/Z-Image-Turbo, Comfy-Org/z_image_turbo, black-forest-labs/FLUX.2-klein-4B, Comfy-Org/flux2-klein-4B, y, para la comparación de licencias, stabilityai/stable-diffusion-3.5-large, black-forest-labs/FLUX.1-dev, black-forest-labs/FLUX.1-schnell, Qwen/Qwen-Image.
- city96/ComfyUI-GGUF.